쉽게 말하면, 역전파는 목적 함수(예: 손실 함수)의 값이 각 가중치에 따라 얼마나 변하는지를 출력에서 입력 쪽으로 거슬러 올라가며 계산하는 방법이다. 이렇게 구한 기울기는 가중치를 어느 방향으로 얼마나 고칠지 정하는 재료가 되지만, 실제로 값을 갱신하는 일은 최적화 알고리즘이 맡는다.
| 분류 | 역모드 자동 미분의 신경망 특수화 |
|---|---|
| 계산 대상 | 스칼라 목적 함수의 변수에 대한 도함수(신경망에서는 주로 가중치와 편향의 기울기) |
| 기본 원리 | 연쇄 법칙을 계산 그래프의 출력에서 입력 방향으로 적용 |
| 역할 분담 | 기울기 계산은 역전파, 매개변수 갱신 방식은 별도의 최적화 알고리즘 |
1. 개요
역전파는 계층 구조나 여러 함수가 합성된 계산에서 스칼라 목적 함수를 각 변수에 대해 미분하는 알고리즘이다. 계산 그래프의 출력에서 입력 쪽으로 연쇄 법칙을 적용하며, 모든 하위 경로에서 오는 기여를 더해 간다. 신경망 학습에서 이 도함수는 보통 가중치와 편향에 대한 기울기다. 역전파는 기울기를 계산할 뿐이고, 매개변수를 어떻게 갱신할지, 또는 갱신할지 말지는 별도의 최적화 알고리즘이 정한다.
역전파는 신경망에 특화된 역모드 자동 미분이다. 계산에 입력이나 매개변수가 많고 손실 함수 같은 스칼라 출력이 하나일 때 실제로 특히 쓸모가 크다. 역방향 계산 한 번으로 그 스칼라 출력에 대한 모든 입력의 도함수를 구할 수 있기 때문이다. 현대 소프트웨어는 텐서 연산, 분기, 공유 매개변수, 반복되는 부분 계산이 들어간 계산 그래프에도 같은 원리를 적용한다.2,3
역전파 자체는 네트워크 구조, 목적 함수, 데이터셋, 규제 방법, 학습률, 최적화 규칙을 정하지 않는다. 경사 하강법과 함께 쓸 수 있지만 두 용어는 같은 뜻이 아니다. 또 생물의 신경계가 같은 메커니즘을 쓴다고 전제하지도 않는다.
2. 범위와 용어
| 용어 | 가리키는 것 |
|---|---|
| 역전파 | 합성된 계산을 거쳐 도함수를 역방향으로 누적하는 계산. 관례상 신경망을 두고 논의된다 |
| 역모드 자동 미분 | 출력에서 입력 쪽으로 벡터-야코비 곱을 계산하는, 더 일반적인 프로그램 변환 또는 그래프 실행 기법 |
| 경사 하강법 | 기울기의 음의 방향으로 변수를 바꾸는 최적화 규칙 |
| 학습 단계 | 순방향 계산, 손실 구성, 역전파, 기울기 처리, 최적화 알고리즘 갱신, 상태 갱신을 포함할 수 있는 더 넓은 절차 |
| 수치 미분 | 섭동된 함수 값으로부터 도함수를 근사하는 것. 흔히 유한 차분을 쓴다 |
| 기호 미분 | 도함수 식을 대수적으로 구성하고 정리하는 것 |
자동 미분은 실제로 실행된 기본 연산마다 도함수 규칙을 합성해 도함수를 계산한다. 유한 차분 근사도 아니고, 완전한 닫힌 형태의 식을 기호로 조작하는 것도 아니다. 계산된 값에는 일반적인 유한 정밀도 반올림이 적용되며, 그 타당성은 그래프 연산마다 지정된 도함수 규칙에 달려 있다.3
'역방향(backward)'이라는 말은 도함수 누적의 의존 순서를 가리킨다. 모델의 수치 순방향 계산을 뒤집는다는 뜻은 아니다. 역방향 패스는 순방향 패스의 값이나 메타데이터를 쓰고, 출력에서 그 조상 노드 쪽으로 민감도 정보를 전파한다.
스칼라 계산으로 역모드 미분을 보일 수 있다. x = 2, w = 3, b = 1일 때 J = (wx + b)^2의 값은 49이고, dJ/dw = 28, dJ/db = 14, dJ/dx = 42다. 이 도함수를 계산하는 일은 최적화 알고리즘이 매개변수를 갱신하는 일과 별개다.4
3. 계산 그래프 표현
방향성 비순환 그래프를 생각해 보자. 노드는 값이고, 입력이 아닌 각 값은 부모 값들로부터 국소 연산을 거쳐 만들어진다. 스칼라 목적 함수를 L이라 하자. 노드 v_i의 수반값(adjoint)은 그 노드에 대한 전체 도함수로 정의하며 다음과 같다.
\bar{v}_i = \frac{\partial L}{\partial v_i}.children(i)는 v_i를 직접 사용하는 노드들의 집합이다. 연쇄 법칙에 따르면 수반값은 다음과 같이 계산된다.
\bar{L} = \frac{\partial L}{\partial L} = 1.
\bar{v}_i = \sum_{j \in \operatorname{children}(i)} \left(\frac{\partial v_j}{\partial v_i}\right)^{\mathsf T} \bar{v}_j.이 식에는 역전파의 두 성질이 담겨 있다. 국소성은 각 연산이 들어온 수반값에 자기 국소 도함수의 전치를 적용하는 규칙만 있으면 된다는 뜻이다. 누적은 어떤 값이 여러 경로로 목적 함수에 영향을 주면 모든 경로의 기여를 더한다는 뜻이다.
- 역방향 실행은 위상 정렬의 역순으로 진행하며, 먼저 순방향 그래프를 계산해 국소 도함수 규칙에 필요한 값을 보관하거나 나중에 다시 만들 수 있게 준비한다.
- 선택한 출력에 수반값을 준다. 스칼라 손실이면 보통 1이다.
- 연산을 의존 관계의 역순으로 방문한다.
- 각 연산의 국소 벡터-야코비 곱을 적용한다.
- 분기 지점과 공유 변수에서는 기여를 더한다.
- 요청된 입력과 매개변수에 대한 수반값을 반환하거나 누적한다.
분기 지점의 합산은 선택 사항이 아니다. 예를 들어 스칼라 x가 u = x^2와 v = sin(x)에 모두 쓰이고 L = uv이면 다음이 성립한다.
\frac{dL}{dx} = \frac{\partial L}{\partial u}\frac{du}{dx} + \frac{\partial L}{\partial v}\frac{dv}{dx} = 2x\sin(x) + x^2\cos(x).두 기여를 모두 더하지 않고 하나만 덮어쓰는 구현은 잘못된 도함수를 낸다. 같은 문제는 한 매개변수가 여러 층, 시간 단계, 분기에서 재사용될 때도 나타난다.
3.1. 국소 규칙과 텐서 모양
역전파는 보통 밀집 야코비안을 만들지 않고 국소 도함수 곱을 적용한다. 몇 가지 흔한 규칙이 이를 보여 준다. y = x_1 + x_2이면 두 입력이 모두 들어온 수반값을 받는다.
\bar{x}_1 \mathrel{+}= \bar{y}, \qquad \bar{x}_2 \mathrel{+}= \bar{y}.원소별 곱 y = x_1 ⊙ x_2에서는 다음이 성립한다.
\bar{x}_1 \mathrel{+}= \bar{y}\odot x_2, \qquad \bar{x}_2 \mathrel{+}= \bar{y}\odot x_1.행렬 곱 Y = AB의 역방향 곱은 다음과 같다. 이 식들은 순방향 피연산자를 쓰지만 행렬 곱셈의 야코비안 전체는 만들지 않는다. 연산별 벡터-야코비 곱이 가진 큰 실용적 장점이 바로 이것이다.
\bar{A} \mathrel{+}= \bar{Y}B^{\mathsf T}, \qquad \bar{B} \mathrel{+}= A^{\mathsf T}\bar{Y}.모양 변환에도 도함수 규칙이 있다. reshape은 들어온 수반값을 원래 모양으로 되돌린다. transpose는 역순열을 적용한다. slice와 gather는 선택된 원천 위치에 기여를 흩뿌리며, 인덱스가 반복되면 기여를 더한다. sum 축소는 들어온 수반값을 줄어든 위치 전체로 펼쳐 준다. mean 축소도 같지만 축소된 원소 수로 나눈다.
브로드캐스팅의 역연산은 브로드캐스팅된 축을 따라 합해야 한다. 편향 벡터가 배치의 모든 행에 더해졌다면 그 기울기는 한 행이 아니라 행별 수반값의 합이다. 이를 잘못 처리하면 값은 그럴듯해 보여도 모양이나 크기가 틀린 결과가 나올 수 있다.
최댓값, 정렬, 이산 선택에 따른 인덱싱, 반복 인덱스는 더 신중하게 다뤄야 한다. 최댓값은 동점일 때 미분할 수 없으므로 도함수가 선택한 관례에 따라 정해진다. 이산 인덱스는 보통 쓸모 있는 기울기가 없지만, 선택된 부동소수점 값은 여전히 수반값을 받을 수 있다. 이것들은 국소 연산의 성질이며, 그래프 수준 누적 규칙의 예외가 아니다.
4. 층을 쌓은 신경망의 유도
순전파 신경망에서는 열벡터를 쓴다. 층 l은 가중치 행렬 W^(l), 편향 벡터 b^(l), 활성화 전 값 z^(l), 활성화 값 a^(l), 원소별 활성화 함수 φ^(l)을 가진다. 순방향 식은 다음과 같다.
a^{(0)} = x,
z^{(l)} = W^{(l)}a^{(l-1)} + b^{(l)},
a^{(l)} = \phi^{(l)}\left(z^{(l)}\right).최종 스칼라 목적 함수와 층별 오차 신호를 다음과 같이 정의한다.
L = \ell\left(a^{(m)}, y\right).
\delta^{(l)} = \nabla_{z^{(l)}} L.일반적인 최종 활성화의 경우 출력 층의 신호는 다음과 같다.
\delta^{(m)} = J_{\phi^{(m)}}\left(z^{(m)}\right)^{\mathsf T} \nabla_{a^{(m)}}\ell.원소별 은닉 활성화에서는 역방향 점화식이 다음과 같다. 여기서 ⊙는 원소별 곱셈이다.
\delta^{(l)} = \left(\left(W^{(l+1)}\right)^{\mathsf T} \delta^{(l+1)}\right) \odot \phi^{(l)\prime}\left(z^{(l)}\right).매개변수에 대한 도함수는 다음과 같다.
\nabla_{W^{(l)}}L = \delta^{(l)}\left(a^{(l-1)}\right)^{\mathsf T}, \qquad \nabla_{b^{(l)}}L = \delta^{(l)}.이 모양들은 유도의 일부다. W^(l)의 모양이 n_l × n_(l-1)이면 δ^(l)의 길이는 n_l이고, a^(l-1)과의 외적은 가중치 행렬과 정확히 같은 모양이 된다.
배치 크기가 B인 예시들을 열로 저장했다면 편향 기울기는 예시별 신호를 합한다. 보고된 손실이 배치 평균이면 1/B 인수는 기울기에 들어간다.
\nabla_{W^{(l)}}L_{\mathrm{mean}} = \frac{1}{B}\Delta^{(l)}\left(A^{(l-1)}\right)^{\mathsf T}, \qquad \nabla_{b^{(l)}}L_{\mathrm{mean}} = \frac{1}{B}\Delta^{(l)}\mathbf{1}.손실을 합에서 평균으로 바꾸면 기울기의 크기가 달라진다. 손으로 한 유도 결과와 프레임워크 결과가 달라 보이는 흔한 원인이 여기에 있다.
라이브러리는 손실과 최종 활성화를 하나의 융합 연산으로 구현하기도 한다. 예를 들어 융합된 log-softmax와 교차 엔트로피의 도함수는 활성화 야코비안 전체를 명시적으로 만들지 않고 계산할 수 있다. 이런 단순화는 연산별 벡터-야코비 곱이며, 연쇄 법칙을 바꾸는 것이 아니다.
5. 벡터-야코비 곱
함수가 n개의 입력을 m개의 출력으로 대응시킨다고 하자. x에서의 야코비안은 J_f(x) ∈ R^(m×n)이다.
f:RnarrowRm, Jf(x) ∈ Rm × n.
순방향 모드 자동 미분은 접선 벡터 r을 전파하고 야코비안-벡터 곱을 계산한다. 역모드는 출력 쪽 여벡터(cotangent) s를 전파하고 벡터-야코비 곱, 즉 전치 야코비안-벡터 곱을 계산한다.
J_f(x)r, \qquad J_f(x)^{\mathsf T}s.스칼라 목적 함수에서는 m = 1이고 시드는 보통 s = 1이다. 그러면 역방향 계산 한 번으로 입력 기울기 전체가 나온다. 출력이 스칼라가 아니면 역방향 호출에 명시적 시드를 주거나 스칼라로 암묵적 축소를 해야 한다. 이때 역방향 계산 한 번은 전체 야코비안이 아니라 선택한 출력들의 선형 결합에 대한 도함수를 계산한다.
| 모드 | 기본 곱 | 차원상 유리한 조건 | 전체 야코비안 구성 |
|---|---|---|---|
| 순방향 모드 | Jr | 미분하는 입력이 적고 출력이 많을 때 | 입력 기저 방향마다 반복 |
| 역모드 | J^T s | 미분하는 입력이 많고 출력이 적을 때 | 출력 기저 방향마다 반복 |
이 비교는 차원에 따른 것이며 성능을 언제나 보장하지는 않는다. 연산 종류, 배치 처리, 컴파일러 변환, 희소성, 메모리 이동, 하드웨어에 따라 측정 성능은 달라질 수 있다. JAX 공식 문서는 야코비안-벡터 곱과 벡터-야코비 곱으로 이 구분을 직접 보여 준다.5
6. 계산 비용과 저장 공간
역방향 누적은 매개변수마다 도함수 프로그램 전체를 따로 평가하지 않아도 된다. 자동 미분 분석에서 쓰는 산술 연산 모델에서는 스칼라 함수의 기울기를 함수 평가 비용의 작은 상수배로 얻을 수 있다. 널리 인용되는 한 서베이는 자신의 모델에서 상한이 6보다 작고 전형적인 배수가 2~3 정도라고 보고하며, 저장 공간은 별도의 비용으로 다룬다. 이 진술들은 연산 수에 관한 것이지, 모든 장치와 소프트웨어 스택에서 실제 소요 시간을 보장하지 않는다.3
역방향 계산에는 각 국소 도함수를 평가하는 데 필요한 순방향 정보가 있어야 한다. 연산에 따라 그 정보는 입력, 출력, 모양, 인덱스 선택, 마스크, 기타 메타데이터일 수 있다. 프레임워크는 다음 방법 가운데 하나를 쓸 수 있다.
- 필요한 값을 그대로 유지한다.
- 나중에 다시 계산한다.
- 압축된 표현으로 저장한다.
- 다른 메모리 계층으로 내보낸다.
- 값을 구체화하지 않는 융합 도함수 규칙을 쓴다.
따라서 '역전파는 모든 활성화를 저장한다'는 말은 너무 넓다. 일부 값은 계속 쓸 수 있어야 하거나 다시 만들어야 하지만, 필요한 집합은 연산과 구현에 따라 달라진다. PyTorch는 자동 미분(autograd) 그래프가 역방향 공식에 필요한 텐서를 선택해 저장하고, 그래프 수명 규칙에 따라 이를 해제한다고 문서에 밝힌다.6
그래디언트 체크포인팅(활성화 체크포인팅 또는 재물질화라고도 함)은 추가 계산을 대가로 저장되는 활성화 메모리를 줄인다. 층이 n개인 연쇄형 네트워크에 대해 Chen 등은 특징 맵 메모리가 √n 차수이고 순방향 계산이 한 번 더 필요한 스케줄을 기술했다. 더 극단적으로는 메모리가 log n 차수이고 순방향 재계산이 n log n 차수인 스케줄도 분석했다. 이 결과는 특정 그래프 구조와 스케줄에 관한 것이며, 모든 동적 그래프에 대한 보편적 상한은 아니다.7
파라미터 저장, 파라미터 기울기, 옵티마이저 상태, 통신 버퍼, 임시 커널은 저장된 활성화와 별개다. 따라서 활성화 메모리를 줄여도 이 구성 요소들이 모두 줄어드는 것은 아니다.
7. 주요 프레임워크의 동작
| 시스템 | 관련 인터페이스 | 문서화된 동작 |
|---|---|---|
| PyTorch | Tensor.backward, torch.autograd.grad, torch.func | 자동 미분은 실행된 텐서 연산의 그래프를 기록하고 역모드 자동 미분을 쓰며, 연산별로 필요한 텐서를 저장한다. 즉시 실행 그래프는 반복마다 다시 만들어진다6 |
| TensorFlow | tf.GradientTape | 테이프는 감시 대상 값이 관여하는 적격 연산을 기록하고, 이후 요청된 원천에 대한 도함수를 계산한다. 지속형 테이프는 기울기를 여러 번 물을 수 있지만 자원을 더 오래 붙잡는다8 |
| JAX | grad, vjp, jvp, 변환들의 조합 | grad는 역모드 위에 만들어졌다. vjp는 역방향 곱을, jvp는 순방향 곱을 드러낸다5 |
프레임워크의 세부 사항은 결과에 영향을 준다. 다음 점들을 확인해야 한다.
- 텐서는 기록되는 계산에 참여해야 하며, 프레임워크 규칙에 따라 감시(watch)되어야 한다.
- 의도적인 detach, 기울기 차단(stop-gradient) 연산, 미분 불가능한 표현으로의 변환, 상태 변경은 의존 관계를 끊을 수 있다.
- 사용자 정의 기본 연산은 애플리케이션이 쓰는 모든 미분 모드에 대해 올바른 도함수 규칙이 있어야 한다.
- 역방향 호출은 기존 기울기 버퍼를 대체하지 않고 누적할 수 있다.
- 반복 미분이나 고차 미분을 위해 도함수 그래프를 유지하면 그 수명과 메모리 사용이 달라진다.
동적 제어 흐름은 실제로 실행된 연산을 따라 미분된다. 원래 프로그램의 모든 분기가 특정 도함수 계산에 기여한다는 뜻은 아니다. 모든 컴파일러가 그래프를 같은 방식으로 표현하거나 최적화한다는 뜻도 아니다.
7.1. 도함수의 범위와 목적 함수 구성
도함수는 항상 지정된 원천에 대해 계산된다. 값이 다른 곳의 미분 가능한 값과 수치적으로 같아도 상수로 취급된 값은 기울기를 받지 않는다. 따라서 잎 매개변수, 중간 활성화, 복사되거나 분리(detach)된 텐서는 서로 다른 미분 동작을 가질 수 있다.
목적 함수가 가중합이면 선형성에 의해 기울기도 가중합이 된다.
L = \sum_{k=1}^{K}\lambda_k L_k
\nabla_{\theta}L = \sum_{k=1}^{K}\lambda_k\nabla_{\theta}L_k.계수, 축소, 마스크, 규제 항은 수학적 목적 함수의 일부다. 역전파는 그래프에 부호화되지 않은 의도된 목적 함수를 스스로 추론할 수 없다. 기록된 계산 바깥에서 더한 규제 항은 도함수를 갖지 않는다. 마스크를 배치 크기가 아니라 유효한 예시 수로 나누면 그 분모가 기울기 크기를 바꾼다.
마이크로배치 누적과 분산 축소는 또 다른 스케일 선택지를 더한다. 크기가 같은 M개의 마이크로배치에 걸쳐 기울기를 합하면 합산된 마이크로배치 손실의 기울기가 된다. M으로 나누면 평균 손실의 기울기가 되며, 각 마이크로배치 손실의 축소 방식이 서로 호환된다는 전제가 필요하다. 분산 all-reduce는 워커 사이에서 합하거나 평균할 수 있다. 결과의 스케일은 '평균'이라는 단어가 아니라 정확한 프레임워크와 학습 코드에서 확인해야 한다.
무작위성도 순방향 계산에 속한다. 샘플링된 연속 변수를 거쳐 역전파하려면 미분 가능한 경로가 필요하며, 흔히 재매개변수화가 이를 제공한다. 이산 샘플링 결정은 이후 연산이 미분 가능하다고 해서 도함수를 얻지 않는다. 그런 선택에 대한 기울기 추정기는 일반 역전파의 자동 결과가 아니라 별도의 방법이다.3
8. 미분 가능성과 수치 동작
역전파는 국소 도함수를 합성한다. 기본 연산이 평가점에서 미분 가능하고 도함수 규칙이 올바르면 연쇄 법칙이 적용된다. 실제 그래프에는 미분 불가능한 점, 불연속점, 정수 값 출력, 정의되지 않은 값을 가진 연산도 들어 있다.
미분 불가능한 점에서는 고전적 의미의 유일한 기울기가 없을 수 있다. 이때 프레임워크는 하위 기울기나 다른 문서화된 관례를 고른다. 예를 들어 PyTorch는 0에서의 ReLU나 제곱근 같은 연산에 대해 일련의 관례를 문서화한다. 따라서 그 점에서 돌아온 값을 고전적 도함수가 존재한다는 증거로 착각하면 안 된다.
잘못된 순방향 값은 역방향 계산을 오염시킬 수 있다. 잘못된 연산 뒤에 무한대나 NaN을 마스킹한다고 해서 그 연산이 기록된 그래프에서 사라지지는 않는다. PyTorch 문서는 0으로 나누기를 예로 들며, 마스킹된 순방향 결과도 NaN 기울기를 낼 수 있다고 설명한다.6
- 많은 국소 도함수를 곱하면 언더플로, 오버플로, 유효숫자 손실이 생길 수 있다.
- 혼합 정밀도 실행에서는 손실 스케일링이나 다른 범위 관리가 필요할 수 있다.
- 축소 연산은 실행 순서에 따라 다른 반올림 결과를 낼 수 있다.
- 수치적으로 같은 순방향 식이라도 도함수의 안정성은 다를 수 있다.
- 복소수 변수의 도함수 규칙에는 명시적인 관례가 필요하다.
이 문제들은 연쇄 법칙의 항등식을 바꾸지 않는다. 대신 계산된 수치에 영향을 준다.
9. 올바른 기울기의 의미와 한계
미분 가능한 스칼라 목적 함수에서 계산된 기울기는 국소 1차 민감도다. 매개변수 θ_i의 성분은 다른 좌표를 고정했을 때의 순간 변화율을 알려 준다.
(∇θL)i = (∂ L)/(∂ θi).
충분히 작은 섭동 Δθ에 대해 1차 근사는 다음과 같다.
L(\theta+\Delta\theta) \approx L(\theta) + \nabla_{\theta}L^{\mathsf T}\Delta\theta.유한한 스텝에서는 생략된 고차항이 중요하다. 기울기가 0이 아니고 목적 함수가 미분 가능하면 음의 기울기 방향은 국소 하강 방향이다. 그러나 그 방향으로 임의의 스텝 길이를 잡으면 목적 함수가 오히려 증가할 수 있다. 스텝을 고르고 조정하는 일은 최적화 알고리즘의 문제다.
올바른 기울기가 보장하지 않는 것은 다음과 같다.
- 목적 함수가 볼록하다는 것
- 옵티마이저가 전역 최소나 쓸모 있는 최소에 도달한다는 것
- 학습 데이터와 평가 데이터의 분포가 같다는 것
- 학습 손실이 낮아지면 일반화가 좋아진다는 것
- 목적 함수가 원하는 행동을 측정한다는 것
- 유한 정밀도 학습 실행이 안정적이라는 것
- 가용 데이터로부터 모델이 식별 가능하다는 것
반대로 학습 실행이 실패했다고 해서 역전파가 잘못 구현되었다는 뜻은 아니다. 원인은 최적화, 초기화, 데이터, 목적 함수, 수치 범위, 모델 용량, 기울기 계산 중 어디에든 있을 수 있다. 진단 층위를 나눠 보아야 '역전파 실패'라는 말이 관계없는 문제까지 흡수하지 않는다.
10. 구현 검증
기울기 검사는 해석적 결과나 자동 미분 결과를, 섭동된 함수 값으로 추정한 도함수와 비교한다. 스칼라 함수와 좌표 방향 e_i에 대해 중심 차분은 다음과 같다.
(∂ f)/(∂ xi) ≈ (f(x+ε ei)-f(x-ε ei))/(2ε).
ε이 작아지면 절단 오차는 줄어들지만, 부동소수점 상쇄 때문에 결국 수치 오차가 커진다. 따라서 쓸 만한 검사는 규모에 맞는 스텝, 가능하면 더 높은 정밀도, 알려진 미분 불가능점에서 떨어진 입력을 쓴다. PyTorch의 gradcheck 문서는 해석적 자동 미분 결과와 유한 차분 추정치의 비교를 설명하며, 실수 함수와 복소수 함수를 따로 다룬다.9
입력 차원이 높으면 방향 검사가 더 싸다. 방향 r에 대해 두 값을 비교한다.
\nabla f(x)^{\mathsf T}r \qquad \text{와} \qquad \frac{f(x+\varepsilon r)-f(x-\varepsilon r)}{2\varepsilon}.건전한 테스트 모음은 다음도 확인한다.
- 기대한 텐서 모양과 축소 인수
- 팬아웃과 공유 매개변수의 누적
- 길이가 0인 입력, 마스킹된 입력, 퇴화된 입력
- 사용자 정의 연산을 신뢰할 만한 기준과 비교
- 1차 도함수와 고차 도함수를 따로 검사
- 대표 범위에서 출력과 기울기가 유한한지
- 의도적으로 미분 불가능한 점에서의 동작
- 기울기 버퍼의 비우기 또는 누적 의미
유한 차분과 일치하는 결과는 강한 진단 증거이지만 모든 입력에 대한 증명은 아니다. 두 구현이 같은 모델링 오류, 예를 들어 잘못된 목적 함수를 줄이는 오류를 공유하면서도 서로 일치할 수 있다.
11. 시간에 따른 역전파
시간에 따른 역전파(BPTT)는 시간으로 펼친 순환 신경망의 계산에 역모드 미분을 적용한다. 순환 상태가 다음을 만족한다고 하자. 시퀀스 목적 함수는 L = Σ ℓ_t(h_t)이다.
h_t = \Phi(h_{t-1}, x_t; \theta)
L = \sum_{t=1}^{T}\ell_t(h_t).상태 수반값을 다음과 같이 정의한다. 시퀀스 바깥의 종단 조건을 0으로 두면 역방향 점화식은 다음과 같다.
\bar{h}_t = \nabla_{h_t}L.
\bar{h}_t = \nabla_{h_t}\ell_t + \left(\frac{\partial h_{t+1}}{\partial h_t}\right)^{\mathsf T}\bar{h}_{t+1}.같은 매개변수 θ가 재사용되므로 모든 시간 단계의 기여를 더해야 한다. 국소 편도함수는 들어오는 상태 h_(t-1)을 고정한 채 계산한다. 어떤 단계별 손실이 θ에 직접 의존하면 그 직접 편도함수도 더해야 한다. 이 구분은 상태 수반값을 통해 이미 흐르는 의존성을 이중으로 세는 것을 막는다.
\nabla_{\theta}L = \sum_{t=1}^{T}\left(\frac{\partial h_t}{\partial \theta}\right)_{\mathrm{local}}^{\mathsf T}\bar{h}_t.Werbos는 1990년 논문에서 동적 시스템과 순환 시스템을 위한 BPTT를 체계적으로 정리했다. 이 방법은 별도의 연쇄 법칙이 아니라, 시간으로 펼친 그래프에 대한 일반 역전파다.10
잘린 BPTT(truncated BPTT)는 상태 수반값이 전파되는 거리를 제한한다. 구현은 흔히 윈도 경계에서 순환 상태를 분리(detach)하거나 역방향 순회를 멈춘다. 윈도 너머의 의존성이 아무 기여도 하지 않는 경우가 아니라면, 결과 기울기는 전체 시퀀스 기울기와 다르다. 잘림은 메모리와 지연 시간을 줄일 수 있지만, 계산하는 도함수 자체를 바꾼다.
이 용어를 트랜스포머에 무분별하게 적용하면 안 된다. 일반 트랜스포머는 유한한 계산 그래프를 처리하며, 층과 토큰 사이의 상호작용을 통해 미분된다. 입력에 유한한 컨텍스트 창이 있다고 해서 잘린 BPTT가 되지는 않는다. BPTT는 시간에 따른 순환 상태 전이를 거치는 역미분에 특별히 관련된다.
12. 기울기 소실과 폭발
깊거나 시간으로 펼친 그래프에서 먼 기여는 국소 야코비안들의 곱을 담는다. 순환 상태에 대해 곱은 연쇄 법칙의 순서대로 다음과 같다.
(∂ ht)/(∂ hk) = (∂ ht)/(∂ ht-1)(∂ ht-1)/(∂ ht-2)⋯(∂ hk+1)/(∂ hk).
반복된 곱셈은 성분을 0 쪽으로 줄이거나 급격히 키울 수 있다. 결과는 특이 방향, 활성화 함수의 도함수, 입력, 상태, 그리고 단계마다 방향들이 어떻게 맞물리는지에 따라 달라진다. '스펙트럴 노름이 1을 넘으면 기울기가 폭발한다'는 식의 단일 규칙은 모든 비선형, 시변 네트워크에 대해 성립하지 않는다.
Bengio, Simard, Frasconi는 기울기 기반 순환 학습으로 장기 의존성을 배우는 일이 의존 기간이 길어질수록 점점 어려워진다는 것을 보였다. 이후 Pascanu, Mikolov, Bengio는 순환 야코비안들의 곱을 사용해 소실과 폭발 행동을 분석했고, 특정 모델 설정에서 충분 조건과 필요 조건을 구분했다.11,12
기울기 노름 클리핑은 원래 기울기 g를 다음 식으로 바꾼다. 여기서 τ는 양의 임계값이다.12
g_{\mathrm{clip}} = g\min\left(1,\frac{\tau}{\lVert g\rVert_2}\right).Pascanu 등은 순환 네트워크 학습에서 기울기 폭발에 대한 대응으로 이 형태를 제안하고 실험으로 평가했다. 클리핑은 옵티마이저에 전달되는 기울기의 노름을 제한한다. 그러나 옵티마이저가 모멘텀, 적응형 전처리, 가중치 감쇠 같은 상태를 함께 쓰면 최종 매개변수 변화량까지 제한하지는 않는다.12
장단기 메모리(LSTM) 구조는 긴 구간에 걸친 오차 흐름의 감쇠를 다루려고 일부 도입되었다. LSTM이 모든 기울기를 잘 조건화하는 것은 아니며, 클리핑도 기울기 소실을 해결하지 못한다. 구조, 초기화, 정규화, 잔차 경로, 목적 함수 설계, 시퀀스 길이, 수치 정밀도가 모두 기울기 전파에 영향을 줄 수 있다.13
12.1. 기울기 전파 모니터링
층별 또는 시간 단계별 기울기 노름을 보면 민감도가 어디서 줄고, 커지고, 비유한 값이 되는지 드러난다. 해석은 매개변수 수와 텐서 모양을 고려해야 한다. 큰 층은 전형적인 성분이 특별히 크지 않더라도 전체 노름이 더 클 수 있다. 유용한 진단 항목에는 전역 노름, 층별 노름, 선택된 성분의 통계, 활성화 범위, 갱신량 대 매개변수 비율, 비유한 값을 처음 만든 연산이 포함될 수 있다.
클리핑은 수치를 계속 쓸 수 있게 해 주지만 반복되는 폭발의 원인을 가릴 수 있다. 보고서에는 클리핑이 얼마나 자주 작동했는지, 가능하면 클리핑 전 노름을 함께 기록해야 한다. 마찬가지로 손실 스케일링은 언더플로를 막을 수 있지만, 잘못 끊긴 그래프를 고쳐 주지는 않는다.
기울기 소실이 모든 의미에서 비활성 매개변수와 같은 것은 아니다. 포화된 활성화는 다른 매개변수 설정이 모델을 실질적으로 바꿀 수 있는 경우에도 국소 도함수가 작을 수 있다. 대칭성은 평평한 방향을 만들 수 있다. 0인 1차 도함수는 극소점, 극대점, 안장점, 또는 미분 불가능 관례에서 나올 수 있다. 따라서 기울기 통계는 순방향 상태와 목적 함수의 맥락과 함께 읽어야 한다.
13. 고차 도함수
역전파는 1차 벡터-야코비 곱을 만들지만, 자동 미분 변환은 서로 합성할 수 있다. 다음과 같은 조합이 가능하다.
- 역모드 기울기에 순방향 모드를 적용한다.
- 순방향 모드 곱에 역모드를 적용한다.
- 도함수 그래프 자체가 미분 가능하면 역모드를 다시 적용한다.
스칼라 함수의 헤시안 H에 대해 많은 알고리즘은 전체 헤시안이 아니라 임의의 벡터 r에 대한 Hr이 필요하다. Pearlmutter는 기울기 계산을 한 방향으로 미분해 헤시안-벡터 곱을 정확히 구하는 절차를 유도했으며, 분석된 설정에서 그 계산 비용은 기울기 평가와 비슷했다. 현대 시스템은 JVP와 VJP의 조합으로 이런 곱을 표현할 수 있다.5,14
고차 미분에는 첫 번째 도함수 그래프의 연산마다 적절한 도함수 규칙이 있어야 한다. 그래프 상태를 더 많이 유지하므로 메모리 사용이 늘 수 있으며, 1차 미분에서는 드러나지 않던 미분 불가능성이 나타날 수도 있다.
14. 생물학적 해석과 대안
역전파는 피질의 학습을 확립된 방식으로 기술한 것이 아니라 계산 방법이다. 엄격한 구현에는 부호가 맞는 오차 신호를 어떻게 전달할지, 순방향 시냅스 가중치와 관련된 피드백을 어떻게 얻을지, 순방향 활동과 오차 정보를 어떻게 분리할지, 층 사이의 갱신을 어떻게 맞출지라는 생물학적 질문이 따른다. 2020년 리뷰는 이 문제들이 여전히 활발한 연구 질문이라고 결론내리며, 핵심 계산 일부를 근사하는 메커니즘을 함께 검토했다.15
피드백 정렬(feedback alignment)은 은닉층 오차 경로에서 정확한 전치 순방향 가중치 대신 고정된 무작위 피드백 가중치를 쓴다. Lillicrap 등은 특정 선형, 비선형, 손글씨 숫자, 함수 근사 실험에서 역전파와 비슷한 행동을 보였다. 이 실험은 테스트한 시스템에서 정확한 가중치 대칭이 필요하지 않았음을 보여 줄 뿐이다. 임의의 구조에서 역전파와 일치한다거나 생물학적 신경계가 이 방식을 쓴다는 것을 입증하지는 않는다.16
포워드-포워드 알고리즘(forward-forward)은 순방향과 역방향 쌍을 양의 순방향 패스와 음의 순방향 패스, 그리고 국소 층 목적 함수로 대체한다. 원 보고서는 이 연구를 예비적이라고 명시했고, 소수의 작은 문제에서만 시연했다. 따라서 일반적인 대체재로 검증된 동등성을 가진 방법이 아니라 연구 제안으로 보는 것이 적절하다.17
국소 손실, 목표 전파, 평형 기반 학습, 섭동 방법, 학습된 피드백 경로 등 다른 연구도 있다. 이들은 서로 다른 제약을 다루므로, 특정 모델과 데이터, 계산 예산, 정확도 기준에서 비교해야 하며 입증된 대체재로 한데 묶어서는 안 된다.
15. 역사
역전파의 역사는 수치 해석, 제어, 동적 시스템, 신경망 연구에 걸쳐 있다. Andreas Griewank의 역사 서베이는 1960년대 이후 여러 독립적인 역모드 미분의 형태를 기록하고, Seppo Linnainmaa가 1970년과 1976년에 계산식을 역으로 다룬 연구를 논의한다. 이 기록은 일반적인 역모드 아이디어를 하나의 신경망 논문에 귀속하는 것을 뒷받침하지 않는다.18
Werbos는 순서 도함수를 학습과 동적 시스템 문제에 적용했고, 1990년 Proceedings of the IEEE 논문에서 BPTT를 제시했다. 데이비드 럼멜하트(David Rumelhart), 제프리 힌턴(Geoffrey Hinton), 로널드 윌리엄스(Ronald Williams)는 1985년 일반화된 델타 규칙 보고서를 돌렸고, 1986년 Nature에 간결한 설명을 실었다. 이들의 긴 장(chapter)은 데이비드 파커(David Parker)와 얀 르쿤(Yann LeCun)의 독립적인 관련 유도도 언급했다. 1986년 연구는 다층 네트워크에서 내부 표현을 학습하는 실용적 방법으로 역전파를 자리 잡게 하는 데 기여했다.2,10,19
얀 르쿤 등은 1989년 손글씨 우편번호 인식 네트워크에서 역전파를 시연했다. 이 연구들은 현대 방법의 모든 요소를 담은 하나의 논문에서 깔끔하게 이어진 순서라기보다, 더 긴 발전 과정의 일부로 보는 것이 맞다.20
16. 흔한 오해
| 흔한 오해 | 바로잡기 |
|---|---|
| 역전파가 가중치를 갱신한다 | 역전파는 도함수를 계산한다. 갱신 규칙은 옵티마이저가 적용한다 |
| 역전파와 경사 하강법은 같다 | 역전파는 기울기를 제공하며, 경사 하강법은 그것을 쓰는 한 방법이다 |
| 역방향 패스는 항상 전체 야코비안을 돌려준다 | 시드를 준 역방향 패스는 벡터-야코비 곱을 돌려준다. 시드 1을 둔 스칼라 손실은 기울기를 준다 |
| 모든 순방향 텐서를 저장해야 한다 | 도함수 규칙에 필요한 값만 남아 있으면 되며, 때로는 다시 계산하거나 압축, 융합, 오프로딩할 수 있다 |
| 자동 미분에는 수치 오차가 없다 | 유한 차분의 절단 오차는 피하지만 여전히 유한 정밀도 연산을 쓴다 |
| 꺾인 점에서 프레임워크가 준 값이 유일한 도함수다 | 그 점에서는 고전적 도함수가 없을 수 있으며, 프레임워크는 관례를 쓴다 |
| 기울기가 0이면 매개변수가 전역적으로 무관하다 | 평가점과 기록된 그래프에서의 국소 1차 민감도만 보여 준다 |
| 기울기 클리핑은 매개변수 갱신을 제한한다 | 옵티마이저의 후속 변환 전에 선택된 기울기 노름을 제한한다 |
| 트랜스포머의 유한한 컨텍스트 창은 잘린 BPTT다 | 잘린 BPTT는 순환 상태 전이를 거친 역전파를 멈춘다. 유한한 비순환 그래프는 다른 경우다 |
| 역전파가 뇌의 학습 알고리즘으로 알려져 있다 | 생물학적 해석은 아직 정해지지 않았다 |
17. 실무 보고 체크리스트
역전파 기반 실험을 재현 가능하게 기술하려면 다음 항목을 명시해야 한다.
- 정확한 스칼라 목적 함수와 각 축소가 합인지 평균인지
- 미분하는 매개변수와 고정되었거나 분리된 경로
- 프레임워크와 관련 도함수 규칙 또는 사용자 정의 연산 규칙
- 수치 정밀도와 손실 스케일링
- 마이크로배치, 예시, 장치, 시간 단계에 걸친 누적 방식
- 옵티마이저 전에 적용하는 클리핑, 정규화, 기타 처리
- 도함수 그래프를 유지하는지, 재물질화하는지
- 순환 모델의 BPTT 윈도와 상태 분리 정책
- 사용자 정의 기울기를 검사한 방법
- 비유한 값과 미분 불가능점을 다루는 방법
이렇게 나누어 적어야 보고된 실패가 도함수 계산, 목적 함수, 옵티마이저, 수치 범위, 주변 학습 절차 중 어디에서 왔는지 판단할 수 있다.
출처 20개
- AI Wiki: Backpropagation (2026-10-04 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-17
- Learning representations by back-propagating errors nature.com · 확인 2026-10-18
- Automatic Differentiation in Machine Learning: a Survey jmlr.org · 확인 2026-10-18
- Forward values, backward gradients (AI Wiki 인용) aiwiki.ai · 확인 2026-10-17
- Forward- and reverse-mode autodiff in JAX docs.jax.dev · 확인 2026-10-18
- Autograd mechanics docs.pytorch.org · 확인 2026-10-18
- Training Deep Nets with Sublinear Memory Cost arxiv.org · 확인 2026-10-18
- Introduction to gradients and automatic differentiation tensorflow.org · 확인 2026-10-18
- Gradcheck mechanics docs.pytorch.org · 확인 2026-10-18
- Backpropagation Through Time: What It Does and How to Do It doi.org · 확인 2026-10-18
- Learning Long-Term Dependencies with Gradient Descent Is Difficult pubmed.ncbi.nlm.nih.gov · 확인 2026-10-18
- On the difficulty of training recurrent neural networks proceedings.mlr.press · 확인 2026-10-18
- Long Short-Term Memory (AI Wiki 인용) direct.mit.edu · 확인 2026-10-17
- Fast Exact Multiplication by the Hessian doi.org · 확인 2026-10-18
- Backpropagation and the brain nature.com · 확인 2026-10-18
- Random synaptic feedback weights support error backpropagation for deep learning nature.com · 확인 2026-10-18
- The Forward-Forward Algorithm: Some Preliminary Investigations arxiv.org · 확인 2026-10-18
- Who Invented the Reverse Mode of Differentiation? ems.press · 확인 2026-10-18
- Learning Internal Representations by Error Propagation cs.toronto.edu · 확인 2026-10-18
- Backpropagation Applied to Handwritten Zip Code Recognition doi.org · 확인 2026-10-18
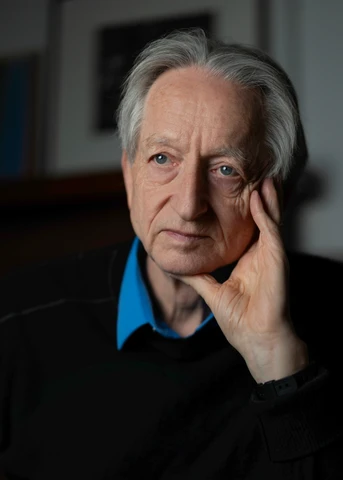 제프리 힌턴
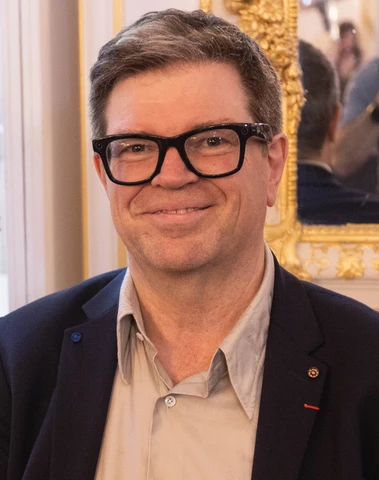 얀 르쿤