쉽게 말하면, 합성곱 신경망은 작은 필터(커널)를 이미지나 신호의 여러 위치에 같은 가중치로 옮겨 가며 적용해 패턴을 찾는 신경망이다. 같은 필터를 위치마다 재사용하기 때문에 적은 매개변수로 이미지 전체를 훑을 수 있다. 주로 이미지 인식에 쓰이지만 1차원 신호나 영상 같은 다른 데이터에도 쓰인다.
| 분류 | 적어도 일부 층에서 합성곱 계열 선형 연산자를 쓰는 신경망2 |
|---|---|
| 별칭 | CNN, ConvNet |
| 핵심 연산 | 학습된 커널을 여러 위치에 적용하는 합성곱(엄밀히는 상호상관) |
| 구조적 특징 | 국소 연결과 위치 간 커널 매개변수 공유2 |
| 주요 적용 분야 | 컴퓨터 비전, 1차원 신호·영상·부피 데이터 등 |
| 주요 사례 | AlexNet(2012년, ImageNet 대규모 학습)3 |
1. 개요
합성곱 신경망(CNN, 또는 ConvNet)은 적어도 일부 층에서 합성곱과 비슷한 선형 연산자를 쓰는 신경망이다. 컴퓨터 비전에서 특히 흔하지만, 이 핵심 아이디어는 순서가 있는 격자나 이웃 구조를 가진 모든 입력에 적용된다. 여기에는 1차원 신호, 이미지, 영상, 부피 데이터가 포함된다. 합성곱 층은 학습된 커널 묶음을 여러 위치에 적용한다. 이로써 국소 연결이 생기고 위치마다 같은 커널 매개변수를 공유하는데, 이 두 가지 구조적 선택이 일반적인 CNN을 완전 연결 층만으로 이루어진 신경망과 구분한다.
대부분의 딥러닝 라이브러리에서 합성곱이라 부르는 연산은 엄밀히는 상호상관(cross-correlation)이다. 적용하기 전에 커널을 뒤집지 않기 때문이다. 이 차이는 연산자를 수학적 정의와 비교할 때는 중요하지만, 학습된 커널의 역할을 바꾸지는 않는다. 학습으로 어느 방향의 커널이든 배울 수 있다. CNN은 보통 이 선형 연산자를 비선형 활성화 함수, 정규화, 잔차 경로, 다운샘플링 또는 업샘플링, 과제에 맞춘 출력 헤드와 함께 쓴다.2
합성곱은 시각에 대한 완전한 이론이 아니라 구조적 사전 가정(prior)을 제공한다. 가중치 공유 덕분에 보폭이 1인 합성곱은 이상적인 격자에서 경계 효과를 제외하면 이동에 대해 등변성(equivariance)을 가진다. 그 자체로 최종 예측이 위치, 회전, 크기, 변형에 불변이 되는 것은 아니다. 보폭, 패딩, 풀링, 유한한 이미지 경계, 전처리, 학습된 헤드가 모두 결과 동작에 영향을 준다. CNN의 정확도는 데이터, 목적 함수, 최적화 절차, 평가 방식, 배포 구현 방식에도 달려 있다. 이 문서는 연산 자체, 그 구조적 결과, 주요 설계 패턴, 그리고 'CNN'이라는 이름만으로 할 수 있는 주장의 한계에 초점을 맞춘다.4,5
2. 정의와 적용 범위
가장 넓고 실용적인 정의는 합성곱 또는 상호상관 층을 하나 이상 포함한 신경망이다. 이 정의에는 나중 블록에서 어텐션, 순환 구조, 완전 연결 계산을 쓰는 구조도 포함된다. 그러나 일상적으로 'CNN'이라고 하면 보통 공간적으로 공유되는 국소 연산자가 특징 추출기나 예측 네트워크의 상당 부분을 맡는 경우를 가리킨다.
CNN의 입력은 보통 텐서(tensor)로 표현된다. 2차원 이미지 모델의 구현은 대개 배치, 채널 축, 두 개의 공간 축을 저장한다. 메모리에서 축 순서는 구현마다 다르다. 어떤 시스템은 배치-채널-높이-너비 순서를, 다른 시스템은 배치-높이-너비-채널 순서를 쓴다. 레이아웃이 달라도 의미상 연산은 같을 수 있지만, 레이아웃 변환은 성능에 영향을 줄 수 있다.
특징 맵(feature map)은 한 층에서 하나 이상의 채널에 대해 만들어진 활성화 텐서다. 커널(이 맥락에서는 필터라고도 한다)은 학습된 계수로 이루어진 작은 배열이다. 출력 채널 하나는 보통 연결된 입력 채널마다 커널 조각을 하나씩 두며, 2차원 필터 하나로 끝나지 않는다. 네트워크는 이 계수를 역전파 또는 다른 최적화 절차로 데이터에서 학습한다.
합성곱이라는 단어는 서로 관련된 여러 대상을 가리킬 수 있다.
| 대상 | CNN에서의 의미 |
|---|---|
| 합성곱 또는 상호상관 | 국소 입력 값과 커널 계수를 결합하는 선형 연산자 |
| 커널 또는 필터 | 여러 위치에 적용되는 학습된 계수 배열 |
| 합성곱 층 | 커널 묶음. 보통 편향과 보폭, 패딩, 팽창, 그룹 설정을 함께 정의한다 |
| 합성곱 블록 | 합성곱, 정규화, 활성화, 잔차 경로, 규제를 포함할 수 있는 더 큰 단위 |
| CNN 아키텍처 | 블록, 해상도, 채널 폭, 연결 방식, 과제 헤드의 배치 |
| 학습된 CNN | 아키텍처와 학습된 상태, 그리고 사용에 필요한 전처리·출력 규칙을 합친 것 |
이 용어들은 서로 바꿔 쓸 수 없다. 같은 아키텍처라도 학습된 매개변수가 다른 두 네트워크가 있을 수 있다. 동등한 커널을 서로 다른 레이아웃으로 저장하는 두 구현도 있을 수 있다. 모델 이름은 정확히 하나의 산출물이 아니라 한 계열을 가리킬 수 있다. 반대로 합성곱 기반이라고 설명된 시스템도 합성곱이 아닌 계산을 상당히 많이 포함할 수 있다.
CNN이 이미지 분류에만 쓰이는 것은 아니다. 1차원 CNN은 오디오 파형, 시계열, 토큰 시퀀스를 처리할 수 있다. 2차원 CNN은 이미지, 스펙트로그램, 그 밖의 직사각형 격자 데이터에 쓰인다. 3차원 CNN은 영상 볼륨이나 의료 스캔을 처리할 수 있다. 합성곱은 그래프, 구면, 군(group), 다양체에서도 정의될 수 있다. 다만 이런 확장에는 영역에 맞는 이웃과 대칭 개념이 필요하므로, 평면 이미지 CNN과 완전히 같게 동작한다고 가정해서는 안 된다.
3. 합성곱 연산
입력 텐서 X가 C_in개의 채널을 가지고, 학습된 커널 텐서 K가 C_out개의 채널을 만든다고 두자. 그룹이 하나인 2차원 상호상관에서 출력 값 하나는 다음과 같이 쓸 수 있다.
Y[o,i,j] = b[o] + Σc=0Cin-1 Σu=0kh-1 Σv=0kw-1 K[o,c,u,v] X[c, i sh + u dh - ph, j sw + v dw - pw]
여기서 o는 출력 채널의 인덱스, i와 j는 출력 위치, b는 선택적인 편향, k_h와 k_w는 커널 크기, s는 보폭, d는 팽창(dilation), p는 패딩이다. 저장된 입력 바깥의 값에는 명시적인 경계 규칙이 필요하다. 0 패딩이 흔하지만, 반사 패딩, 복제 패딩, 순환 패딩, 유효 영역만 계산하는 방식, 학습된 경계 처리는 서로 다른 연산자다.
입력 길이가 n, 커널 크기가 k, 대칭 패딩이 p, 보폭이 s, 팽창이 d인 1차원 경우 일반적인 출력 길이는 다음과 같다.
n_{out} = \left\lfloor \frac{n + 2p - d(k-1) - 1}{s} \right\rfloor + 1이 식은 표준 직사각형 2차원 경우에 높이와 너비에 각각 독립적으로 적용된다. 커널 크기만으로는 출력 형상을 추론할 수 없다는 점도 보여 준다. 패딩, 보폭, 팽창은 층 정의의 일부다. 풀링과 전치 합성곱에 대응하는 경우는 합성곱 산술 안내서가 유도한다.6
축 하나에서 커널이 덮는 실효 범위는 d(k-1)+1이다. 팽창이 1이면 인접한 샘플을 쓴다. 팽창을 키우면 커널 계수 수를 늘리지 않고 샘플링 위치 사이에 간격을 넣는다. 이는 이론상 수용 영역을 넓힐 수 있지만, 적절한 주변 층 없이 쓰면 희소한 샘플링 패턴이나 격자 모양 아티팩트를 만들 수도 있다.
그룹이 하나이고 출력 채널마다 편향이 있을 때, 학습 가능한 스칼라 매개변수 수는 다음과 같다.
Cout(Cinkhkw + 1)
편향이 없으면 마지막 C_out 항이 빠진다. 매개변수 수는 각 커널이 평가되는 모든 위치에서 공유되므로 이미지의 높이나 너비에 의존하지 않는다. 반면 연산량과 활성화 메모리 비용은 보통 출력 위치 수에 따라 커진다.
밀집(dense) 2차원 층의 근사 곱셈-누산(multiply-accumulate) 횟수는 다음에 비례한다.
HoutWoutCoutCinkhkw
이 식은 층 형상을 비교하는 데 유용하지만 지연 시간을 예측하는 값은 아니다. 커널 구현, 메모리 이동, 캐시 동작, 자료형, 희소성, 배치 처리, 하드웨어, 컴파일러 선택, 연산자 융합에 따라 실행 시간이 달라질 수 있다. 곱셈-누산 하나를 연산 한 번으로 셀지 두 번으로 셀지에 따라 보고되는 FLOP 합계도 달라지므로, 보고서에는 그 집계 기준을 밝혀야 한다.
3.1. 상호상관과 수학적 합성곱
수학적 이산 합성곱은 커널의 인덱스를 뒤집는다. 상호상관은 뒤집지 않는다. 많은 기계학습 라이브러리가 상호상관을 구현하고 이를 합성곱이라고 부른다. 제약 없는 학습 커널이라면 저장된 계수 패턴을 뒤집는 것은 한 매개변수화를 다른 매개변수화로 옮기는 것에 해당한다. 따라서 명명 관례가 층이 배울 수 있는 것을 줄이지는 않는다. 다만 고정된 신호처리 필터를 가져올 때, 항등식을 증명할 때, 구현 세부를 비교할 때는 중요하다.2
커널이 고정되어 있을 때 합성곱은 입력에 대해 선형이고, 입력이 고정되어 있을 때는 커널에 대해 선형이다. 하지만 학습된 CNN 전체는 보통 비선형이다. 활성화, 정규화 동작, 풀링, 게이트, 클리핑, 과제 헤드가 단순한 선형 형태를 깨뜨린다. 합성곱 층을 중간에 비선형 연산 없이 쌓으면 여전히 하나의 더 큰 선형 연산자가 되며, 다만 경계와 보폭 세부 사항의 제약을 받는다.
3.2. 패딩과 경계
패딩은 가장자리 근처에서 어떤 입력 위치가 출력에 기여하는지를 정한다. 「유효(valid)」 합성곱은 커널 전체가 입력 안에 놓이는 위치에서만 계산한다. 「같음(same)」은 보통 보폭이 1일 때 출력의 공간 크기가 입력과 같도록 패딩을 고른다는 뜻이다. 하지만 커널 크기가 짝수이거나 보폭이 2 이상이면 비대칭 패딩과 반올림 관례가 필요하다.
0 패딩은 이미지 경계에서 학습 데이터의 분포와 닮지 않은 값을 넣을 수 있다. 반사 패딩과 복제 패딩은 서로 다른 가정을 담는다. 순환 패딩은 반대편 가장자리를 이웃으로 취급한다. 따라서 이미지를 자르거나, 내용을 프레임에 상대적으로 옮기거나, 패딩 규칙을 바꾸면 내부 합성곱이 이동 등변성을 가지더라도 활성화 값이 달라질 수 있다.
경계의 세부 사항은 깊이를 따라 전파된다. 이론상 수용 영역이 가장자리에 닿는 유닛은 패딩된 값에 의존하며, 수용 영역이 넓어질수록 영향을 받는 유닛의 비율이 커진다. 정확한 비교에는 층 이름뿐 아니라 입력 크기, 자르기 정책, 패딩 관례, 정렬 방식을 함께 포함해야 한다.
3.3. 그룹 합성곱과 깊이별 합성곱
그룹 합성곱은 채널을 여러 그룹으로 나눈다. 각 출력 채널은 자기 그룹에 속한 입력 채널에만 연결된다. 그룹이 g개로 같고 채널 수가 g로 나누어떨어지면 조밀한 매개변수 항은 다음과 같이 g분의 1로 줄어든다.
(CoutCinkhkw)/g
깊이별 합성곱은 그룹의 극단적인 경우로, 각 입력 채널을 따로 필터링한다. 보통 입력 채널마다 출력 채널이 하나이거나 작은 배수만큼 있다. 뒤따르는 1×1 점별(pointwise) 합성곱이 채널 사이의 정보를 섞는다. 원래의 MobileNet 구조는 이 깊이별 분리(depthwise-separable) 분해를 써서 경량 모델을 만들고 너비와 해상도 사이의 교환 관계를 드러냈다. 비슷한 밀집 합성곱에 비해 연산량은 줄지만, 실제 속도는 목표 런타임과 하드웨어가 작은 연산을 효율적으로 실행하는지에 따라 달라진다.7
1×1 합성곱은 한 위치를 넘어 공간적으로 연결되지 않지만, 모든 위치에서 채널 방향으로 학습된 선형 변환이다. 공간 적용을 유지한 채 채널 표현을 확장하거나 축소하거나 섞을 수 있다. 병목(bottleneck) 블록은 비용이 큰 공간 연산 주변에 점별 층을 자주 쓴다.
3.4. 전치 합성곱과 업샘플링
전치 합성곱은 선택한 행렬 표현에 대해 대응하는 합성곱 연산자를 전치(transpose)한 선형 연산이다. 때로 디컨볼루션(deconvolution)이라고 부르지만, 일반적으로 앞선 합성곱을 역으로 되돌리거나 다운샘플링으로 버려진 정보를 복원하지는 않는다. 출력 크기는 보폭, 패딩, 커널, 팽창, 출력 패딩 관례에 따라 달라진다.6
전치 합성곱은 공간 업샘플링을 학습할 수 있다. 대안 설계는 고정된 보간 규칙으로 크기를 키운 뒤 일반 합성곱을 적용한다. 두 방법은 샘플링 동작과 아티팩트 위험이 다르다. 예를 들어 출력 위치가 받는 기여 수가 고르지 않게 겹치면 체크보드(checkerboard) 무늬가 생길 수 있다. 적절한 방법은 '학습된 업샘플링'이라는 명칭보다 정렬, 출력의 의미, 평가에 따라 정해진다.
4. 지역성, 공유, 등변성
CNN은 두 가지 강한 구조적 가정을 담고 있다. 첫째, 일반적인 작은 커널을 쌓은 구조에서는 가까운 입력 값이 먼 값보다 먼저 연결된다. 둘째, 같은 국소 변환이 둘 이상의 위치에서 유용하다. 이 가정은 이미지나 신호에 자주 맞지만, 데이터로부터 배운 사실이 아니라 구조가 부과한 사전 가정이다.
국소 연결은 이미지 전체에 대한 밀집 층에 비해 직접 연결 수를 줄인다. 매개변수 공유는 구별되는 계수 수를 더 줄인다. 두 가지가 함께 작동해 학습된 하나의 검출기를 많은 위치에서 평가할 수 있게 한다. 과제에 대략 반복되는 국소 구조가 있을 때 이는 통계적 효율을 높일 수 있다.
경계가 일관되게 정해진 무한 격자나 격자에서 보폭이 1인 상호상관은 정수 단위 이동과 순서를 바꿔도 결과가 같다. T_δ가 입력을 이동시키고 F가 그런 층이라면 다음이 성립한다.
F(T_δ X) = T_δ F(X)
이 성질을 이동 등변성(translation equivariance)이라 한다. 입력을 이동하면 출력 특징 맵도 같은 만큼 이동한다. 출력이 변하지 않는 이동 불변성(translation invariance)과는 다르다. 점별 활성화는 등변성을 유지한다. 다른 여러 구성 요소도 명시된 변환과 경계 가정 아래에서 등변성을 유지할 수 있지만, 일반 CNN은 회전이나 반사에 대해 자동으로 등변하지 않는다. 군 등변 CNN은 선택된 변환 군으로 가중치 공유를 확장한다.4
유한한 이미지에서는 이 등식이 조건부로만 성립한다. 이동하면 새 경계 값이 드러나거나 오래된 값이 사라지고, 패딩 적용 방식도 달라질 수 있다. 보폭이 1보다 크면 샘플링 격자만 남으므로, 입력이 한 픽셀 이동해도 출력이 그만큼 이동한다고 할 수 없다. 최대 풀링, 평균 풀링, 보폭 합성곱은 적절한 저역 통과 처리 없이 다운샘플링하면 에일리어싱(aliasing)을 일으킬 수 있다.8
작업 수준에서 예측이 위치에 덜 민감해지는 메커니즘은 여러 가지다.
- 풀링이나 보폭 집계로 이후 유닛이 요약하는 영역이 넓어진다.
- 전역 집계가 명시적인 출력 위치를 없앤다.
- 데이터 증강이 변환된 예시를 모델에 노출한다.
- 손실 함수가 변환된 예시들에 같은 라벨을 주도록 보상한다.
- 과제 헤드가 공간 증거를 결합한다.
- 등변 아키텍처가 더 넓은 대칭 군을 담을 수 있다.
어떤 메커니즘도 모든 변환에 대한 불변성을 보장하지 않는다. 전역 평균 풀링도 평균하는 전체 유한 특징 맵을 보존하는 순열이나 이동에 대해서만 불변이다. 자르기, 패딩, 가림(occlusion), 보간, 재표본화, 경계 변경은 그 맵의 값을 바꿀 수 있다.
등변성은 라벨이 위치에 의존하면 바람직하지 않을 수도 있다. 해부학 영상, 문서 레이아웃, 원격 탐사, 계측기 판독처럼 절대 좌표가 필요한 네트워크도 있다. 과제가 요구하면 아키텍처는 좌표 채널, 위치 특징, 비대칭 패딩, 공유되지 않는 구성 요소를 추가할 수 있다. 유용한 사전 가정은 데이터 생성 과정과 목적 함수가 정하며, 불변성을 무조건 선호하는 보편 원칙으로 정해지지 않는다.
5. 수용 영역과 학습된 표현
유닛의 수용 영역(receptive field)은 그 유닛에 영향을 줄 수 있는 이전 표현의 영역이다. 단일 합성곱 층에서 수용 영역은 커널이 덮는 범위를 따른다. 층을 쌓으면 커널 범위, 팽창, 누적 보폭에 따라 수용 영역이 커진다. 보폭이 1인 3×3 합성곱을 쌓으면 층마다 이론상 범위가 두 위치씩 늘어나며, 다운샘플링이 있으면 이후 단계의 한 칸이 입력 좌표에서 더 큰 간격에 대응한다.
이론상 수용 영역은 가능한 의존성을 기록한다. 모든 위치가 똑같이 기여한다는 뜻은 아니다. Luo와 동료들은 이를 영향력이나 기울기 크기로 측정한 실효 수용 영역(effective receptive field)과 구분했다. 그들이 분석한 구조에서는 실효 영역이 이론상 영역의 일부만 차지했고, 그 영향은 중심 근처에 집중되었다. 이 구분은 이름상 깊은 네트워크가 긴 범위의 문맥을 충분히 쓰지 못할 때 중요하다.9
스킵 연결, 팽창, 풀링, 커널 크기, 깊이, 비선형 동작은 실효 문맥에 영향을 준다. 학습 데이터와 목적 함수도 마찬가지다. 아키텍처로 계산한 수용 영역은 어떤 의존성이 가능한지 진단할 수는 있지만, 학습된 모델이 그 의존성을 실제로 쓰는지, 특정 개념을 표현하는지는 증명하지 못한다.
초기 층을 가장자리 검출기로, 중간 층을 질감이나 부분으로, 후기 층을 물체로 보는 설명은 유용한 직관이지만 결정론적 법칙은 아니다. 학습된 표현은 채널과 위치에 걸쳐 분산되어 있다. 개별 유닛은 여러 패턴에 반응할 수 있고, 의미 있는 정보는 유닛들의 조합으로 부호화될 수 있다. 무엇이 나타나는지는 초기화, 데이터, 규제, 아키텍처, 과제에 따라 달라진다.
생물학적 시각과의 역사적 관계도 신중히 말해야 한다. Hubel과 Wiesel은 1959년 고양이의 줄무늬 피질(striate cortex)에서 국소적이고 방향에 민감한 수용 영역을 보고했다. Fukushima의 1980년 neocognitron은 교대로 나타나는 세포 유형과 공유되는 국소 패턴을 써서, 위치 이동의 영향을 덜 받도록 의도된 다층 인식 시스템을 만들었다. 이 연구들은 영향력 있는 개념과 비유를 제공했다. 현대 CNN은 망막이나 시각 피질의 상세한 모형이 아니며, 역전파, 데이터 요구량, 활성화, 연결성, 목적 함수가 생물학적 학습과 크게 다르다.10,11
표현 분석은 질감에서 형태로 가는 단순한 진행이라는 생각에도 이의를 제기했다. 큐 충돌(cue-conflict) 실험에서 Geirhos와 동료들은 시험한 ImageNet 학습 CNN들이 사람 관찰자보다 질감에 더 강하게 의존한다는 것을 발견했고, 학습 데이터를 바꾸면 형태 편향이 커질 수 있다는 것도 확인했다. 2025년 연구는 이 실험 설정이 특징 의존성을 혼동시킨다고 주장했으며, 통제된 특징 억제를 써서 시험한 컴퓨터 비전 CNN들이 주로 국소 형태 특징에 의존한다고 보고했다. 두 방법은 서로 다른 실험 질문에 답한다. 이 결과들을 합치면 모든 CNN이 본질적으로 질감 기반이라고 볼 근거는 없으며, 층의 깊이 이야기만으로는 모델이 어떤 증거를 쓰는지 확정할 수 없음을 보여 준다.12,13
6. 구성 요소와 아키텍처 패턴
CNN은 어느 한 구성 요소보다 상호작용이 중요한 연산들로 조립된다. 흔한 블록은 합성곱 층, 정규화 연산, 활성화 함수를 적용한다. 순서, 편향 유무, 초기화, 잔차 경로, 다운샘플링 위치는 계열마다 다르다.
6.1. 비선형 활성화
비선형 연산이 없으면 합성곱 층을 쌓아도 선형으로 남는다. 정류 선형 단위(ReLU)는 양의 쪽에서 포화하지 않고 계산 비용이 낮아 널리 쓰이게 되었다. AlexNet 논문은 대규모 이미지 분류기를 더 빨리 학습시키는 요소의 하나로 비포화 뉴런을 사용했다. ReLU가 필수는 아니다. 시그모이드, tanh, 누수 정류 함수, GELU, SiLU, 게이트 함수, 학습된 활성화 등이 서로 다른 설계에서 쓰인다.3
활성화는 최적화와 표현 동작을 바꾼다. ReLU는 입력이 계속 음수로 남으면 영구적으로 비활성인 유닛을 만들 수 있다. 부드럽거나 게이트 방식인 대안은 계산 비용이 다르다. 초기화, 정규화, 깊이, 정밀도, 과제와 무관하게 보편적으로 최선인 활성화는 없다.
6.2. 정규화
배치 정규화는 학습 중에는 미니배치 통계를, 추론 실행 중에는 저장되었거나 추정된 통계를 써서 활성화를 정규화한다. Ioffe와 Szegedy는 내부 공변량 이동(internal covariate shift)을 줄이기 위한 방법으로 이를 제시했고, 실험에서 더 높은 학습률과 더 빠른 학습을 가능하게 했다고 보고했다. 이후 연구는 층 입력 분포를 안정시키는 것이 시험한 설정에서 효과를 설명하지 못하며, 대신 더 부드러운 최적화 동작과 관련되어 있음을 밝혔다.14,15
이 메커니즘을 하나의 확립된 표어로 줄여서는 안 된다. 배치 정규화는 학습 모드, 배치 구성, 통계 추정, 동기화 선택에 따라서도 동작이 달라진다. 배치가 작거나, 샘플이 독립이 아니거나, 도메인이 이동하거나, 분산 실행을 하면 이런 선택이 중요해진다. 그룹, 층, 인스턴스, 응답 정규화는 다른 축이나 통계를 쓰며 서로 다른 동작을 부호화한다.
6.3. 다운샘플링과 풀링
풀링은 이웃 영역의 값을 요약한다. 최대 풀링은 각 창에서 가장 큰 값을 남기고, 평균 풀링은 평균을 계산한다. 보폭이 있는 합성곱은 다운샘플링 필터를 대신 학습할 수 있다. 어느 것이든 공간 해상도를 줄이고, 이후 유닛이 나타내는 입력 간격을 넓힌다.
다운샘플링은 깊은 단계의 활성화 메모리와 연산을 줄이지만 공간 샘플을 버린다. 고주파 내용이 적절히 필터링되지 않으면 에일리어싱 때문에 작은 이동에도 출력이 민감해질 수 있다. 밀집 예측 과제는 보통 더 높은 해상도를 유지하고, 팽창 층을 쓰고, 여러 스케일을 유지하거나 업샘플링 경로로 해상도를 복원한다.5,8
전역 평균 풀링은 마지막 특징 맵 각각을 스칼라 하나로 줄인다. 분류 헤드에서 큰 완전 연결 층을 대신할 수 있고, 입력 크기의 일부 변화를 허용한다. 하지만 네트워크 앞쪽의 공간 정보를 모두 지우지는 않으며, 특징 값을 바꾸는 변환에 대해 불변성을 보장하지도 않는다.
6.4. 잔차 연결과 스킵 연결
잔차 연결은 블록 입력을 학습된 잔차 가지에 더한다. 두 형상이 맞으면 그대로 더하고, 맞지 않으면 투영을 쓴다. 원래의 ResNet 연구는 잔차 학습을 최적화 재구성으로 제시했고, 상당히 더 깊은 잔차 네트워크가 비슷한 일반 네트워크보다 최적화하기 쉽다는 경험적 근거를 보였다.16
잔차 경로가 그래디언트를 흘려보낸다고 말하는 것은 축약된 설명이라 불완전하다. 그래디언트 전파는 여전히 비선형성, 정규화, 매개변수 값, 스케일, 정밀도, 손실에 달려 있다. 잔차 연결은 순전파 함수 클래스와 역전파 경로를 모두 바꾼다. 일부 최적화 어려움은 줄이지만, 임의의 깊이에서 안정적이거나 성공적인 학습을 보장하지는 않는다.
스킵 연결은 서로 다른 해상도의 표현을 결합하기도 한다. 분할 디코더는 거친 의미 특징과 더 세밀한 공간 특징을 합칠 수 있다. 특징 피라미드 설계는 여러 스케일을 탐지 헤드에 노출한다. 덧셈, 연결(concatenation), 어텐션, 게이트 융합은 매개변수와 메모리에 서로 다른 영향을 준다.
6.5. 너비, 깊이, 해상도, 단계
깊이는 순차적인 변환의 수를 세지만, 공개된 깊이 표기가 연산을 항상 같은 방식으로 세지는 않는다. 너비는 채널 수나 다른 은닉 차원을 가리킨다. 입력 해상도는 공간 위치의 수를 조절한다. 이 중 무엇을 키워도 용량과 연산량이 늘 수 있지만, 확장 관계는 서로 다르다.
많은 이미지 CNN은 단계(stage)를 쓴다. 한 단계 안에서는 공간 해상도가 일정하고 여러 블록이 같은 채널 폭에서 동작한다. 단계 사이에서는 해상도가 줄고 채널 폭이 보통 늘어난다. 이로써 고해상도 연산은 입력 근처에 모이고, 더 거친 특징에는 더 많은 채널이 할당된다.
EfficientNet은 고정된 계열 안에서 자원 지향 탐색 과정을 거쳐 깊이, 너비, 입력 해상도의 복합 스케일링(compound scaling)을 연구했다. 보고된 비교는 그 논문의 아키텍처, 학습 방식, 장치, 지표에 묶여 있다. 복합 스케일링은 설계 방법이지, 하나의 고정된 비율이 모든 CNN, 데이터셋, 하드웨어 대상에 최적이라는 증명이 아니다.17
6.6. 다중 분기와 분리 설계
다중 분기 블록은 같은 입력에 서로 다른 변환을 적용하고 출력을 합친다. Inception 계열은 병렬 경로와 점별 투영을 써서 비용을 관리하면서 여러 수용 영역 패턴을 결합했다. 잔차 블록은 덧셈 항등 경로를 강조하고, 밀집 연결(dense connectivity)은 앞선 블록들의 출력을 연결한다. 이 패턴들은 함께 쓸 수도 있다.18
깊이별 분리 합성곱과 그룹 연산은 형식상 연산량이나 매개변수 수를 줄이지만, 한 층 안의 채널 간 연결을 제한한다. 점별 혼합, 채널 셔플, 확장 층, 이후의 밀집 연산이 통신을 복원한다. 연산 비용이 어떻게 분포하는지도 중요하다. 연산(FLOP)이 적은 모델도 작은 커널을 많이 만들거나, 큰 중간 텐서, 레이아웃 변환, 동기화 지점을 만들면 더 느릴 수 있다.
6.7. 헤드와 출력의 의미
백본(backbone)이라 부르는 특징 추출기는 표현을 만든다. 과제 헤드는 이를 클래스 로짓, 경계 상자, 마스크, 키포인트, 깊이 값, 임베딩 같은 출력으로 바꾼다. 이 경계는 관례적이다. 학습된 탐지기는 분류 백본보다 많은 것을 포함하며, 분할 네트워크는 디코더 전체에서 공간 예측을 할 수 있다.
소프트맥스 헤드는 로짓을 상호 배타적인 라벨 집합의 정규화된 클래스 점수로 바꾼다. 독립적인 시그모이드 출력은 일부 다중 라벨 문제에 맞는다. 회귀 헤드는 연속 값이나 확률 분포의 매개변수를 예측할 수 있다. 비최대 억제, 임계값 처리, 크기 조정, 보정은 학습된 네트워크 바깥에 있을 수 있지만 여전히 시스템 동작을 바꾼다. 이 파이프라인을 명시하지 않으면 'CNN 출력'이라는 말은 모호하다.
7. 학습과 평가
CNN 학습은 별도의 학습 이론이 아니다. 네트워크는 매개변수화된 함수를 정의하고, 최적화기가 학습 예시에 대한 목적 함수를 줄이도록 매개변수를 갱신한다. 다른 신경망에 쓰이는 넓은 절차, 즉 미니배치 최적화, 규제, 학습률 스케줄, 검증 기반 선택, 체크포인트 저장이 그대로 적용된다.
아키텍처 자체도 최적화에 영향을 준다. 공유 커널은 많은 위치에서 오는 그래디언트 기여를 누적한다. 활성화 크기는 채널과 단계에 따라 달라질 수 있다. 매우 깊은 일반(plain) 네트워크는 기울기 소실이 유일한 문제가 아닌 경우에도 성능 저하를 보일 수 있으며, 이것이 잔차 재구성의 동기가 되었다. 정규화, 초기화, 잔차 스케일링, 옵티마이저 설정, 배치 크기, 정밀도, 데이터 순서는 서로 영향을 주므로, 한 계열에 성공한 학습 방식이 다른 계열에 그대로 옮겨 가지 않을 수 있다.16
데이터 증강은 비전 학습에서 특히 중요하다. 자르기, 뒤집기, 색 변화, 기하 변환, 혼합 기법, 합성 손상은 원하는 견고성을 부호화하고 관측되는 입력 분포를 넓힐 수 있다. 증강은 목표가 보존되거나 의도적으로 변환될 때만 유효하다. 수평 뒤집기는 객체 클래스를 보존하더라도 글자, 좌우 방향, 교통 방향, 해부학적 구조를 뒤집을 수 있다. 공격적인 자르기는 라벨이 붙은 객체를 잘라 낼 수 있다.
증강이 불변성을 보장하지는 않는다. Azulay와 Weiss는 시험한 CNN들이 증강으로 학습했더라도 작은 이동과 크기 조정에서 예측이 바뀔 수 있으며, 그 해결책은 부분적이었다고 확인했다. 학습 예시는 관측된 변환 근처의 동작을 제약할 뿐, 변환된 모든 입력에 대해 출력이 같다는 것을 증명하지 않는다.5
전이 학습은 보통 더 크거나 관련된 데이터셋에서 학습된 CNN으로 초기화한 뒤 목표 과제에 맞춘다. 효과는 원천 데이터, 목표 데이터, 층 선택, 목적 함수, 영역 간 거리에 달려 있다. 백본을 고정하거나, 모든 층을 갱신하거나, 어댑터만 학습하면 서로 다른 모델이 된다. 사전 학습된 체크포인트에는 원치 않는 상관관계나 전처리 가정이 함께 들어 있을 수 있다.
7.1. 평가 단위
평가 결과는 정확한 모델과 프로토콜에 속한다. 이미지 분류 보고서에는 최소한 아래 항목을 밝혀야 한다.
- 데이터셋 버전과 분할.
- 입력 해상도와 색 규약.
- 크기 조정과 자르기 정책.
- 정규화와 테스트 시점 증강.
- 체크포인트와 매개변수 평균화.
- 클래스 매핑.
- top-1, top-k, 다중 라벨 등 지표 정의.
- 거부, 손상, 누락 입력의 처리.
- 효율 측정을 위한 정밀도, 장치, 런타임, 배치 크기.
벤치마크인 ImageNet은 이미지 분류기 비교를 빠르게 했지만, 'ImageNet 정확도'로 인용된 수치는 프로토콜과 데이터셋 세부 사항 없이는 불완전하다. top-1 정확도와 top-5 정확도는 서로 다른 지표다. 검증 세트, 공개 테스트 세트, 새로 수집한 테스트 세트는 서로 바꿔 쓸 수 없다.
Recht와 동료들은 원래 데이터 수집 과정을 따르려 한 절차로 새로운 CIFAR-10과 ImageNet 테스트 세트를 만들었다. 평가된 분류기 전반에서 정확도가 떨어졌지만 상대적 순위는 대체로 유지되었다. 이 결과는 벤치마크 성능이 표본 추출된 분포와 큐레이션 과정에 조건부라는 것을 보여 준다. 평가가 무의미하다는 뜻은 아니며, 불확실성을 보고하고 실제 사용에서 중요한 조건을 시험해야 한다는 근거가 된다.19
7.2. 정확도, 비용, 재현성
파라미터 수, FLOP, 처리량, 지연 시간, 최대 메모리, 에너지, 바이너리 크기, 하드웨어 활용률은 서로 다른 것을 측정한다. 의미 있는 효율 비교는 가능한 많은 조건을 고정하고 다른 조건을 밝혀야 한다. CPU에서 배치 크기 1의 지연 시간이 고처리량 가속기 성능을 예측하지는 않는다. 학습 비용은 추론 실행 비용과 같지 않다. 희소한 이론 연산이 희소한 하드웨어 실행을 보장하지도 않는다.
무작위 초기화, 데이터 순서, 비결정적 커널, 증강, 혼합 정밀도, 분산 축소는 학습 결과를 바꿀 수 있다. 독립 실행들의 평균과 변동을 보고하는 것이 유리한 체크포인트 하나보다 더 많은 정보를 준다. 코드와 가중치를 공개하면 도움이 되지만, 재현에는 정확한 전처리, 의존성 버전, 데이터 구성, 평가 스크립트도 필요하다.
많은 아키텍처나 체크포인트를 같은 검증 신호에서 비교하면 선택 과정 때문에 추정치가 낙관적으로 나올 수 있다. 실용적으로 가능하다면 최종 테스트 세트는 반복된 설계 결정으로부터 보호해야 한다. 배포를 위해서는 대표 하위 집단, 운영 임계값, 입력 실패, 드리프트, 오류 유형별 비용도 평가에 포함해야 한다.
8. 발전 과정
CNN의 역사는 하나의 발명 순간이 아니라 서로 관련된 아이디어들의 흐름이다. 생물학적 수용 영역 연구, 신호처리의 합성곱, 패턴 인식 시스템, 역전파, 벤치마크 데이터셋, 가속기, 소프트웨어 프레임워크가 모두 기여했다. 아래 이정표는 선택적이며, 리더보드가 아니라 아키텍처 변화를 가리킨다.
| 연도 | 연구 | 의미 |
|---|---|---|
| 1959년 | Hubel과 Wiesel | 고양이 줄무늬 피질에서 국소적이고 방향에 민감한 수용 영역을 보고했다. 이후 국소 특징 추출의 비유로 영향을 미쳤다.10 |
| 1980년 | Neocognitron | Fukushima가 위치 이동에 덜 민감하도록 의도된 다층 자기 조직화 패턴 인식 네트워크를 기술했다.11 |
| 1989년·1998년 | 기울기 학습 합성곱 네트워크와 LeNet 계열 시스템 | 얀 르쿤(Yann LeCun)과 동료들이 기울기 방법으로 학습되는 합성곱 네트워크를 개발하고, 손글씨 문서 인식에 쓰인 사례를 기록했다.20 |
| 2012년 | AlexNet | Krizhevsky, 일리야 수츠케버(Ilya Sutskever), 제프리 힌턴(Geoffrey Hinton)이 GPU를 써서 ImageNet에 대규모 깊은 CNN을 학습했고, 정류 비선형, 증강, 드롭아웃을 사용했다. 보고된 프로토콜에서 대회 성적이 크게 향상되었다.3 |
| 2014년 | VGGNet과 Inception 계열 설계 | VGGNet은 작은 커널로 깊이를 탐구하고, Inception은 다중 분기 연산을 탐구했다. 둘 다 재사용 가능한 이미지 백본을 확립하는 데 도움이 되었다.18,21 |
| 2015년·2016년 | 완전 합성곱 예측, 잔차 네트워크, 학습된 제안 공유 | CNN이 밀집 분할과 탐지를 위한 범용 백본이 되었고, 잔차 블록은 훨씬 깊은 최적화를 가능하게 했다.16,22,23 |
| 2017년~2019년 | 모바일·스케일링 지향 계열 | MobileNet은 깊이별 분리 합성곱을 강조했고, EfficientNet은 탐색된 계열 안에서 깊이, 너비, 해상도를 함께 확장했다.7,17 |
| 2020년 이후 | 어텐션 경쟁과 현대화된 ConvNet | 비전 트랜스포머는 비합성곱 백본을 제공했다. ConvNeXt는 갱신된 합성곱 설계가 현대 학습 방식에서도 경쟁력을 가질 수 있음을 보였다.24,25 |
1998년 문서 인식 논문은 국소 수용 영역, 가중치 공유, 서브샘플링, 기울기 기반 학습을 결합한 시스템을 기술했다. 따라서 현대의 학습 가능한 CNN에 대한 역사적 근거로는, 어느 후대 벤치마크 모델이 아키텍처를 발명했다는 주장보다 이 논문이 더 강하다. 마찬가지로 AlexNet은 합성곱, 역전파, GPU, 정류 유닛을 만들어 낸 것이 아니다. 그 의의는 이 요소들의 규모와 결합, 그리고 보고된 ImageNet 결과에 있다.3,20
원래 AlexNet 논문은 합성곱 층 다섯 개와 완전 연결 층 세 개, 약 6천만 개의 매개변수, 두 개의 GPU에 나눈 학습을 기술했다. 이 사실들은 그 모델에 고유하다. 이후 CNN은 훨씬 많은 층을 쓰고, 큰 밀집 헤드를 전역 풀링으로 바꾸고, 잔차 연결을 도입하고, 매개변수 수를 줄이고, 학습 절차를 바꾸었다. 따라서 'CNN'이라는 역사적 명칭은 실질적으로 다른 계산 그래프를 포괄한다.3
PyTorch와 TensorFlow 같은 라이브러리는 합성곱 연산자, 자동 미분, 가속기 백엔드, 사전 학습 모델 인터페이스를 제공한다. 프레임워크의 연산자 이름만으로 동작이 완전히 정해지지는 않는다. 패딩, 데이터 레이아웃, 편향, 초기화, 결정론성, 보간, 직렬화의 기본값은 버전과 API에 따라 다를 수 있다.
역사 서술에서도 '인간 수준'이라는 단일 기준을 쓰지 말아야 한다. 사람과의 비교는 주석 작업, 관찰자 전문성, 허용 시간, 클래스 분류 체계, 전처리, 오류 지표에 따라 달라진다. 모델은 한 벤치마크에서 지정된 인간 기준선을 넘으면서도, 분포 이동에서는 취약하거나 실제 의사결정 과정에 적합하지 않을 수 있다.
9. 과제별 변형
CNN은 재사용 가능한 공간 또는 시간 특징을 제공하지만, 그 특징이 예측으로 바뀌는 방식은 과제 아키텍처가 정한다.
9.1. 분류
이미지 분류 CNN은 이미지 또는 잘라낸 영역을 하나 이상의 라벨에 대응시킨다. 일반적인 설계는 백본을 통해 공간 해상도를 줄이고, 마지막 특징 맵을 집계한 뒤 분류 헤드를 적용한다. 출력은 입력된 잘라낸 영역을 다루며, 원래 장면의 모든 객체를 반드시 다루지는 않는다. 다중 라벨 분류, 계층적 라벨, 열린 집합 거부, 위치 추정은 백본 이외의 추가 결정을 요구한다.
분류용 사전 학습은 다른 과제의 백본을 자주 제공해 왔다. 초기 층과 중간 층의 특징이 전이될 때 이 재사용은 도움이 되지만, 분류기의 다운샘플링과 전역 집계는 밀집 과제에 필요한 공간 세부 사항을 버릴 수 있다. 미세 조정, 특징 피라미드, 팽창 단계, 재설계된 스템으로 이 불일치를 다룰 수 있다.
9.2. 객체 탐지
객체 탐지는 범주와 위치를 함께 예측한다. 2단계 시스템은 먼저 후보 영역을 만든 뒤 분류하거나 다듬는다. Faster R-CNN은 연구된 시스템에서 전체 이미지의 합성곱 특징을 탐지 네트워크와 공유하는 영역 제안 네트워크를 도입했다. 1단계 시스템은 조밀한 상자나 관련 표현을 직접 예측한다.23
탐지 지표는 위치 겹침, 신뢰도 순위, 클래스 정의, 객체 크기, 중복 처리에 따라 달라진다. 백본의 분류 점수만으로 탐지기 품질을 예측할 수 없다. 입력 크기 조정, 제안 설정, 앵커 설계나 앵커 없는 할당, 후처리가 결과를 실질적으로 바꿀 수 있다.
9.3. 분할과 밀집 예측
이미지 분할은 픽셀이나 영역 단위로 라벨 또는 값을 부여한다. 완전 합성곱 네트워크는 분류 네트워크를 밀집 예측기로 바꾸는 방법을 보였고, 스킵 연결로 거친 의미 정보와 세밀한 외형 정보를 결합했다. U-Net 같은 인코더-디코더 설계는 문맥을 위한 수축 경로와 위치 추정을 위한 확장 경로를 쓴다.22,26
다운샘플링은 해상도 상충 관계를 만든다. 큰 수용 영역은 문맥 분류에 도움이 되지만, 세밀한 경계에는 공간 세부 정보가 필요하다. 팽창 합성곱, 다중 스케일 특징, 스킵 융합, 학습된 업샘플링은 이 상충 관계의 서로 다른 부분을 다룬다. 출력 보간과 정렬 규약은 평가에 포함해야 하는데, 한 픽셀 이동도 경계 지표를 바꿀 수 있기 때문이다.
다른 2차원 과제에는 키포인트 추정, 광학 흐름, 깊이 예측, 영상 복원, 초해상도, 생성 모델링이 있다. 같은 합성곱 연산자가 각 과제에 쓰일 수 있지만 손실과 출력의 의미는 다르다. 목적이 인식이 아니더라도 합성곱 생성기나 판별기는 여전히 CNN이다.
9.4. 1차원과 3차원 CNN
1차원 CNN은 하나의 순서 있는 축을 따라 커널을 공유한다. 파형 샘플, 시간 창, 스펙트럼, 시퀀스를 처리할 수 있다. 인과성은 차원과 별개다. 인과 합성곱은 미래 위치를 제외하고, 중심 합성곱은 양방향을 모두 쓴다. 팽창은 매개변수를 비례하여 늘리지 않고 시간 문맥을 넓힐 수 있다.
3차원 CNN은 세 축에 걸쳐 커널을 공유한다. 영상이라면 축이 시간, 높이, 너비일 수 있고, 의료 또는 과학 볼륨이라면 세 축이 모두 공간일 수 있다. 완전한 3차원 커널은 추가 차원 때문에 활성화와 커널 볼륨이 커져 비용이 크다. 인수분해된 공간-시간 층, 슬라이스 기반 모델, 희소 표현, 2차원과 3차원의 혼합 처리는 서로 다른 절충을 제공한다.
축의 의미가 중요하다. 시간 축의 이동이 이미지 공간의 이동과 반드시 같은 것은 아니며, 의료 스캔의 축마다 복셀 간격이 다를 수 있다. 샘플 단위로 표현된 커널 크기는 샘플링 해상도를 통제하지 않는 한 고정된 물리적 범위와 같지 않다.
9.5. 규칙 격자를 넘어서
그래프 합성곱, 구면 합성곱, 군 합성곱은 국소 집계와 공유된 변환 규칙이라는 CNN 원리의 일부를 일반화한다. 그러나 이동, 이웃, 방향, 측도에 대해 서로 다른 정의가 필요하다. 그래프 신경망은 불규칙한 패딩을 가진 2차원 CNN이 아니며, 구면 모델은 구의 기하와 샘플링을 고려해야 한다.
모든 국소 공유 연산자를 합성곱이라고 부르면 이런 차이가 가려질 수 있다. 정확한 설명에는 영역, 변환 군, 이산화 방식, 그리고 연산자가 보존하도록 의도된 등변성 성질을 밝혀야 한다.
10. 효율과 배포
CNN 배포는 매개변수 수 목표가 아니라 대상 장치에서 시작한다. 서버 가속기, 데스크톱 GPU, 모바일 NPU, 마이크로컨트롤러, 브라우저 런타임은 서로 다른 연산, 메모리, 정밀도, 연산자 기능을 제공한다. 한 장치에서 효율적인 아키텍처가 다른 장치에서는 낮은 성능을 보일 수 있다.
10.1. 비용의 원천
CNN 비용은 서로 얽힌 여러 자원으로 나눌 수 있다.
- 곱셈-누산을 포함한 커널 연산.
- 가중치와 특징 맵 읽기.
- 중간 활성화 쓰기.
- 레이아웃 변환과 패딩.
- 실행 시작과 디스패치 오버헤드.
- 장치 간 동기화.
- 최적화된 알고리즘이 쓰는 임시 작업 공간.
- 네트워크 주변의 후처리와 데이터 전송.
초기 고해상도 층은 매개변수가 적어도 활성화 이동량을 지배할 수 있다. 깊이별 분리 모델에서는 채널 혼합이 조밀하기 때문에 점별 합성곱이 연산량을 지배할 수 있다. 오래된 아키텍처에서는 큰 분류 헤드가 매개변수 저장량을 지배하면서 공간 연산은 상대적으로 적게 기여할 수 있다.
최대 메모리는 매개변수의 합만이 아니다. 학습은 활성화, 그래디언트, 옵티마이저 상태, 때로는 마스터 정밀도 가중치를 저장한다. 추론 실행은 버퍼를 재사용할 수 있지만, 동적 형상, 분기 수명, 작업 공간 때문에 피크가 올라갈 수 있다. 양자화는 런타임이 관련 연산자를 지원하고 허용 가능한 정확도를 유지할 때만 저장이나 연산을 줄인다.
10.2. 아키텍처와 하드웨어 공동 설계
MobileNet은 최대 벤치마크 정확도만이 아니라 연산량을 줄이는 분해를 중심으로 설계된 아키텍처의 예다. EfficientNet은 자원 지향 탐색과 학습 설정 아래에서 깊이, 너비, 해상도를 함께 확장하는 방식을 보여 준다. ConvNeXt는 나중에 트랜스포머 시대에 얻은 학습과 아키텍처 선택을 써서 표준 CNN 설계를 다시 검토했다.7,17,25
이 예들은 보편적인 효율 순위를 정하지 않는다. 깊이별 합성곱은 메모리에 묶일 수 있다. 더 넓은 밀집 커널은 가속기를 더 효율적으로 쓸 수 있다. 더 큰 커널은 순차 깊이를 줄이면서 가중치 접근을 늘릴 수 있다. 연산 융합은 균형을 바꿀 수 있다. 따라서 의도한 장치에서의 직접적인 지연 시간과 에너지 측정이 여전히 필요하다.
10.3. 수치 정밀도와 변환
CNN 추론 실행은 학습보다 낮은 정밀도의 부동소수점 또는 정수 형식을 흔히 쓴다. 많은 정수 파이프라인에서 보정(calibration)이나 양자화 인식 학습이 스케일과 클리핑 동작을 정한다. 텐서별 스케일과 채널별 스케일은 서로 다른 절충을 한다. 누산 정밀도는 피연산자 정밀도보다 높을 수 있다.
변환은 패딩, 보간, 활성화 근사, 정규화 접기, 연산 순서를 바꿀 수 있다. 작은 수치 차이도 총 정확도가 안정적으로 보여도 임계값 처리되거나 순위가 매겨진 출력을 바꿀 수 있다. 검증은 대표적인 입력과 경계 사례에서 중간 형상과 최종 출력을 비교한 뒤, 변환 후 과제 지표를 다시 실행해야 한다.
추론 실행을 위해 배치 정규화를 인접 합성곱에 접는 일은 고정된 통계를 써서 가중치와 편향을 바꾸는 방식으로 흔히 한다. 이 대수는 지정된 추론 실행 모드 매개변수와 수치 규약에서만 유효하다. 학습 모드를 실수로 켜 두거나, 오래된 통계를 쓰거나, 다른 엡실론으로 접으면 동작이 바뀐다.
10.4. 동적 입력 크기
합성곱 백본은 커널이 공간적으로 공유되므로 여러 입력 크기를 받을 수 있는 경우가 많다. 그러나 고정된 밀집 헤드, 고정된 위치 가정, 최소 단계 크기, 정렬 제약, 컴파일된 형상은 여전히 제한을 줄 수 있다. 가변 해상도는 수용 영역의 범위, 객체 크기, 연산량, 메모리도 바꾼다.
한 자르기 크기로 학습한 모델이 더 큰 모든 크기에서 자동으로 검증되지는 않는다. 크기 조정은 가로세로 비율이나 픽셀 밀도를 바꿀 수 있다. 배치 구성에서는 공통 크기로 패딩이 필요할 수 있다. 배포 문서는 수학적으로 받아들일 수 있는 형상과 실제로 평가한 형상을 구분해야 한다.
10.5. 운영 측정
재현 가능한 지연 시간 보고서는 하드웨어, 소프트웨어, 모델 산출물, 정밀도, 입력 형상, 배치 크기, 워밍업, 샘플 수, 동기화, 스레딩, 전처리와 전송 포함 여부를 밝힌다. 백분위수는 평균에 가려진 지터를 드러낼 수 있다. 처리량 시험은 동시성과 대기열을 밝혀야 한다.
에너지와 열 동작은 지속 측정이 필요하다. 모바일 장치는 반복 추론 실행 후 성능 제한(스로틀링)이 걸릴 수 있다. 클라우드 가속기는 자원을 공유할 수 있다. 모델 수준 FLOP으로는 이런 효과를 포착할 수 없다. 운영 모니터링은 입력 형상, 오류율, 지연 시간, 자원 사용, 데이터 드리프트, 버전 식별자를 추적해야 한다.
11. 한계와 실패 양상
CNN이라는 라벨은 아키텍처를 밝힐 뿐 신뢰성을 보장하지 않는다. 실패는 데이터, 목적 함수, 표본 추출, 최적화, 수치 실행, 그리고 주변 시스템에서 생길 수 있다.
11.1. 이동 민감성과 에일리어싱
보폭이 1인 합성곱의 깔끔한 등변성은 정의된 경계 조건에서만 성립한다. 실제 분류기는 보폭, 풀링, 자르기, 유한한 프레임을 쓴다. Azulay와 Weiss는 연구한 CNN들이 작은 이미지 변환에도 큰 예측 변화를 보인다는 것을 보였다. Zhang은 이동 민감성이 안티에일리어싱을 무시하는 흔한 다운샘플링 방법과 연결된다고 보았고, 서브샘플링 전에 저역 통과 필터를 적용하면 평가된 모델의 안정성이 좋아진다는 것을 보였다.5,8
안티에일리어싱은 만능 보장이 아니다. 필터 선택이 과제에 중요한 세부 정보를 지울 수 있고, 비선형 연산은 새로운 고주파 성분을 만들 수 있다. 정수 픽셀 이동 시험은 회전, 크기 조정, 원근 변화, 연속적인 부픽셀 운동을 다루지 않는다. 견고성 주장은 시험한 변환과 범위를 명시해야 한다.
11.2. 분포 이동
학습 예시와 테스트 예시는 특정 수집 및 라벨링 과정에서 나온 표본이다. 모델은 벤치마크 안에서는 안정적이지만 배포 환경에는 없는 상관관계를 이용할 수 있다. 배경, 카메라, 압축, 지역, 계절, 기관, 인구 구성, 주석 정책이 모두 이동할 수 있다.
Recht와 동료들이 연구한 새로 수집된 테스트 세트는 원래 데이터셋 과정을 재현하려는 노력에도 불구하고 폭넓은 분류기에서 낮은 정확도를 낳았다. ImageNet-C와 ImageNet-P는 최악의 경우의 적대적 공격과 구분해 일반적인 손상과 교란을 따로 측정하기 위해 도입되었다. 이 벤치마크들은 명시된 약점을 드러내지만, 통과했다고 해서 알려지지 않은 배포 분포에 대한 견고성이 입증되는 것은 아니다.19,27
평가는 분포 내 정확도, 손상 견고성, 변환 안정성, 보정, 하위 집단 동작, 분포 외 탐지를 분리해야 한다. 이를 'robust CNN' 같은 하나의 주장으로 합치면 위협 모델과 운영 비용이 가려진다.
11.3. 질감, 형태, 지름길 학습
CNN은 학습 설정이 보상하는 예측 특징을 무엇이든 쓸 수 있다. Geirhos와 동료들의 큐 충돌 실험에서 일부 ImageNet 학습 CNN은 질감 단서를 선호했고, 양식화된 이미지로 학습하면 행동이 형태 쪽으로 옮겨 가고 일부 시험된 견고성 지표가 개선되었다. 이후 Burgert와 동료들은 그 시험의 혼란 요인을 비판했고, 억제 기반 평가에서 주로 국소 형태에 의존한다고 보고했다. 의존 패턴은 응용 영역마다 달랐다. 어느 결과도 합성곱이 수학적으로 하나의 특징 선호를 요구한다는 주장으로 바꾸면 안 된다. 아키텍처, 데이터, 목적 함수, 영역, 최적화, 측정 방법이 모두 결론에 영향을 준다.12,13
지름길 학습(shortcut learning)은 질감보다 넓다. 의료 모델은 스캐너 표식을, 야생동물 모델은 배경을, 제품 분류기는 스튜디오 스타일을 쓸 수 있다. 벤치마크 정확도가 높아도 인과적 근거는 잘못될 수 있다. 반사실 시험, 층화된 데이터, 취득 감사, 외부 검증은 일부 지름길을 드러낼 수 있지만, 단일한 설명 시각화로는 그 부재를 증명할 수 없다.
11.4. 적대적 예시
Szegedy와 동료들은 연구에서 작은 최적화된 입력 교란이 오분류를 일으킬 수 있고, 네트워크 사이에 전이될 수 있음을 발견했다. 이후 연구들은 많은 공격과 방어를 개발했지만, 적대적 견고성은 위협 모델에 따라 조건부로 남는다. 허용된 노름이나 변환, 공격자 지식, 교란 예산, 질의 접근, 평가 방법이 그 조건이다.28
자연 손상에 대한 견고성과 적대적 견고성은 같은 말이 아니다. 흐림에 안정적인 모델도 표적 최적화 공격에는 취약할 수 있다. 한 공격에 대해 평가된 방어가 더 강한 적응형 공격에는 실패할 수 있다. 배포 평가는 공격자 능력과 기권, 거부, 거짓 경보의 결과를 포함해야 한다.
11.5. 불확실성과 신뢰도
소프트맥스 점수는 정답일 확률로 자동 보정되지 않는다. 신경망 분류기는 분포가 바뀌었거나 모호하거나 적대적인 입력에서 자신 있게 틀릴 수 있다. 한 검증 분포에서 측정한 보정은 다른 분포에서 떨어질 수 있다. 앙상블, 온도 스케일링, 베이즈 근사, 선택적 예측은 유용할 수 있지만 각각 자신의 가정과 평가가 필요하다.
분포 외 점수도 새로운 모든 입력을 식별할 수 없다. '알 수 없음'은 하나의 일관된 분포가 아니다. 모니터링은 모델 신호를 입력 검증, 데이터 출처, 운영 제약, 결과가 정당화할 때의 사람 에스컬레이션과 결합해야 한다.
11.6. 해상도와 정보 손실
보폭과 풀링은 샘플을 버린다. 목표가 전역적이면 분류기가 이를 견딜 수 있지만, 작은 객체, 얇은 구조, 글자, 정밀한 경계는 사라질 수 있다. 입력 해상도를 높이는 것은 취득 과정이 정보를 담고 있고 아키텍처가 그것을 보존할 때만 도움이 된다. 보간은 애초에 취득되지 않은 세부 정보를 복원할 수 없다.
이론상 수용 영역이 전체 입력을 덮어도 실효 영향은 여전히 집중될 수 있다. 반대로 네트워크는 거짓 배경 단서를 담은 넓은 문맥을 쓸 수도 있다. 따라서 수용 영역 크기는 직접적인 품질 지표도, 국소적 또는 전역적 추론의 증거도 아니다.9
11.7. 데이터셋과 라벨의 한계
CNN은 라벨과 예시가 나타내는 구분을 학습한다. 모호한 라벨, 주석자 간 불일치, 누락된 클래스, 중복 이미지, 누출, 클래스 불균형이 결과 모델을 제약한다. 닫힌 집합 분류기는 시스템이 거부 동작을 추가하지 않는 한 알려진 클래스 중에서만 배정해야 한다.
보고된 성능은 드물지만 비용이 큰 오류를 평균 속에 묻을 수 있다. 탐지와 분할에서는 작은 구조나 적게 대표된 조건의 품질이 대표 수치보다 훨씬 낮을 수 있다. 의료, 산업, 과학 활용에서 내부 무작위 분할은 학습 데이터와 취득 아티팩트를 공유해 외부 성능을 과대평가할 수 있다.
11.8. 해석 가능성의 한계
특징 시각화, 민감도(saliency), 귀인, 활성화 최대화, 예시 검색은 서로 다른 질문에 답한다. 모델 행동에 대한 가설을 세우는 데 도움이 될 수 있지만, 불안정하거나 관련 변화에 둔감하거나 검증하기 어려울 수 있다. 눈길을 끄는 히트맵이 강조한 영역이 배포 의미에서 결정의 원인이었다는 증거는 아니다.
추론 실행 시 CNN은 산출물과 실행 방식이 고정되어 있을 때 결정론적 함수다. 다만 의도된 확률 연산이나 비결정적 구현은 예외다. 결정론성이 해석 가능성, 공정성, 인과성, 안전을 뜻하지는 않는다. 그 속성들은 별도의 정의와 시험이 필요하다.
11.9. 시스템 수준의 한계
전처리가 실패의 주된 원인이 될 수 있다. 색 채널 순서, 값 범위, 방향 메타데이터, 알파 처리, 자르기 정렬, 정규화는 학습과 맞아야 한다. 올바른 네트워크에 잘못된 표현을 넣으면 그 시스템은 잘못된 것이다. 후처리 임계값과 좌표 변환도 마찬가지로 올바른 내부 예측을 훼손할 수 있다.
피드백 루프, 사용자 행동, 센서 노후화, 변하는 데이터 원천, 소프트웨어 업데이트는 CNN 바깥에서 일어난다. 모델 카드나 벤치마크 표는 특정 조건에서의 산출물을 설명할 뿐, 모니터링, 접근 통제, 사고 대응, 롤백, 도메인 검토를 대신하지 않는다.
12. CNN과 비전 트랜스포머
비전 트랜스포머는 주로 공간 합성곱에 기대지 않고, 어텐션으로 이미지에서 얻은 토큰을 처리한다. 원래 ViT 연구는 이미지를 패치로 나누고, 대규모 데이터로 사전 학습해 이미지 인식 벤치마크에 전이하면 순수 트랜스포머도 강한 성능을 낼 수 있음을 보였다. 이는 실용적인 대안을 확립한 것이지, CNN을 대체하는 보편적 수단이 된 것은 아니다.24
두 구조는 서로 다른 기본 상호작용 패턴을 부호화한다. 아래 표에서 비교한다.
| 성질 | 전형적 CNN | 전역 어텐션 비전 트랜스포머 |
|---|---|---|
| 기본 공간 혼합 | 공유된 국소 커널 | 토큰 사이의 데이터 의존 가중 상호작용 |
| 기본 국소성 | 작은 커널에서 명시적 | 패치화와 학습된 어텐션이 결정하며, 국소성을 추가하지 않으면 정해지지 않음 |
| 변환 구조 | 가중치 공유가 조건부 등변성을 준다 | 위치 표현과 토큰화가 이동 동작에 영향을 준다 |
| 초기 상호작용 범위 | 국소적이며 깊이나 팽창으로 확장 | 토큰화 이후 잠재적으로 전역 |
| 밀집 연산 확장 | 고정 커널과 채널에서 대략 공간 위치에 선형 | 표준 전역 어텐션은 어텐션 행렬에서 토큰 수에 대해 이차 |
| 공통 계층 구조 | 해상도를 줄이는 단계 | 평평한 설계와 계층적 설계가 모두 존재 |
| 하드웨어 동작 | 성숙한 합성곱 커널이 있으나 효율은 연산자에 따라 다름 | 밀집 행렬 연산은 효율적일 수 있으나 토큰 수와 메모리가 중요 |
이 표는 두 계열 전체가 아니라 전형적 형태를 설명한다. 윈도우, 희소, 선형, 계층적 어텐션은 확장 방식을 바꾼다. 큰 커널과 동적 합성곱은 CNN의 상호작용 패턴을 바꾼다. 하이브리드 네트워크는 합성곱 스템, 어텐션 블록, 또는 토큰 처리 단계 안의 합성곱을 쓴다.
데이터 효율도 고정된 아키텍처 순위가 아니다. 원래 ViT 결과는 대규모 사전 학습을 강조했다. 이후 DeiT는 ImageNet만으로도 세심하게 설계된 학습 방식과, 보고된 설정의 증류 방법을 써서 트랜스포머가 경쟁력 있게 학습될 수 있음을 보였다. 따라서 모든 트랜스포머가 수억 장의 이미지를 필요로 한다거나, 모든 CNN이 적은 데이터에서 잘 학습된다고 말하는 것은 부정확하다.24,29
벤치마크 점수 이상의 차이도 보고되었다. Raghu와 동료들은 분석한 ViT에서 층 표현이 더 균일하고 전역 정보가 더 일찍 집계된다고 보고했고, CNN은 더 점진적인 표현 진행을 보였다. 이는 명시된 모델과 분석에 대한 경험적 패턴이며, 모든 아키텍처의 모든 층에 대한 보장이 아니다.30
비교는 프로토콜에 매우 민감하다. 학습 증강, 옵티마이저, 정규화, 에포크 수, 입력 해상도, 사전 학습 데이터, 매개변수 수, FLOP, 평가 자르기는 계열 라벨보다 큰 차이를 낼 수 있다. 공정한 실험은 임의로 고른 발표 수치를 비교하기보다 응용에 중요한 자원 또는 품질 제약을 맞춰야 한다.
ConvNeXt는 ResNet 계열 CNN을 현대 비전 트랜스포머와 연관된 설계 및 학습 선택으로 현대화했고, 그 프로토콜에서 이미지 분류, 탐지, 분할에 대해 경쟁력 있는 결과를 보고했다. 그 의의는 합성곱이 항상 이긴다는 것이 아니다. 오래된 CNN 기준선과 오래된 학습 방식은 아키텍처 결론을 내릴 충분한 근거가 되지 않는다는 점을 보여 준다.25
CNN과 어텐션은 시스템의 서로 다른 부분을 맡아 상호 보완할 수 있다. 합성곱은 많은 목표에서 국소 공유 처리와 효율적인 다중 스케일 특징 피라미드를 제공한다. 어텐션은 데이터 의존 상호작용과 직접적인 장거리 집계를 제공한다. 하이브리드는 안정적인 국소 처리를 위한 합성곱 스템, 전역 문맥을 위한 어텐션 단계, 밀집 출력을 위한 합성곱 디코더를 쓸 수 있다. 이것이 가치 있는지는 측정된 정확도, 견고성, 메모리, 지연 시간, 데이터, 구현 지원에 달려 있다.
확고한 결론은 어느 계열이 지배할지에 대한 예측보다 좁다. 'CNN'은 2012년의 고정된 아키텍처가 아니라 유용한 연산자와 사전 가정의 집합을 가리킨다. '트랜스포머'도 마찬가지로 많은 토큰화와 어텐션 패턴을 포괄한다. 모델 선택은 정확한 아키텍처, 학습 절차, 산출물, 배포 대상의 수준에서 이루어져야 한다.
출처 30개
- AI Wiki: Convolutional Neural Network (2026-10-02 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-26
- Convolutional Networks deeplearningbook.org · 확인 2026-10-26
- ImageNet Classification with Deep Convolutional Neural Networks proceedings.neurips.cc · 확인 2026-10-26
- Group Equivariant Convolutional Networks proceedings.mlr.press · 확인 2026-10-26
- Why Do Deep Convolutional Networks Generalize So Poorly to Small Image Transformations? jmlr.csail.mit.edu · 확인 2026-10-26
- A Guide to Convolution Arithmetic for Deep Learning arxiv.org · 확인 2026-10-26
- MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications arxiv.org · 확인 2026-10-26
- Making Convolutional Networks Shift-Invariant Again proceedings.mlr.press · 확인 2026-10-26
- Understanding the Effective Receptive Field in Deep Convolutional Neural Networks proceedings.neurips.cc · 확인 2026-10-26
- Receptive Fields of Single Neurones in the Cat's Striate Cortex pmc.ncbi.nlm.nih.gov · 확인 2026-10-26
- Neocognitron: A Self-organizing Neural Network Model for a Mechanism of Pattern Recognition Unaffected by Shift in Position doi.org · 확인 2026-10-26
- ImageNet-trained CNNs Are Biased Towards Texture; Increasing Shape Bias Improves Accuracy and Robustness openreview.net · 확인 2026-10-26
- ImageNet-trained CNNs Are Not Biased Towards Texture: Revisiting Feature Reliance Through Controlled Suppression proceedings.neurips.cc · 확인 2026-10-26
- Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift proceedings.mlr.press · 확인 2026-10-26
- How Does Batch Normalization Help Optimization? proceedings.neurips.cc · 확인 2026-10-26
- Deep Residual Learning for Image Recognition openaccess.thecvf.com · 확인 2026-10-26
- EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks proceedings.mlr.press · 확인 2026-10-26
- Going Deeper with Convolutions openaccess.thecvf.com · 확인 2026-10-26
- Do ImageNet Classifiers Generalize to ImageNet? proceedings.mlr.press · 확인 2026-10-26
- Gradient-Based Learning Applied to Document Recognition bottou.org · 확인 2026-10-26
- Very Deep Convolutional Networks for Large-Scale Image Recognition arxiv.org · 확인 2026-10-26
- Fully Convolutional Networks for Semantic Segmentation openaccess.thecvf.com · 확인 2026-10-26
- Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks proceedings.neurips.cc · 확인 2026-10-26
- An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale openreview.net · 확인 2026-10-26
- A ConvNet for the 2020s openaccess.thecvf.com · 확인 2026-10-26
- U-Net: Convolutional Networks for Biomedical Image Segmentation arxiv.org · 확인 2026-10-26
- Benchmarking Neural Network Robustness to Common Corruptions and Perturbations iclr.cc · 확인 2026-10-26
- Intriguing Properties of Neural Networks arxiv.org · 확인 2026-10-26
- Training Data-Efficient Image Transformers and Distillation Through Attention proceedings.mlr.press · 확인 2026-10-26
- Do Vision Transformers See Like Convolutional Neural Networks? proceedings.neurips.cc · 확인 2026-10-26
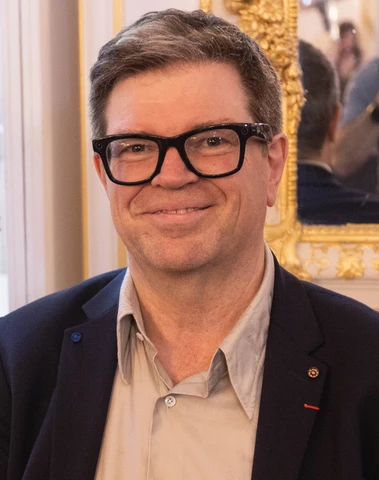 얀 르쿤
 일리야 수츠케버
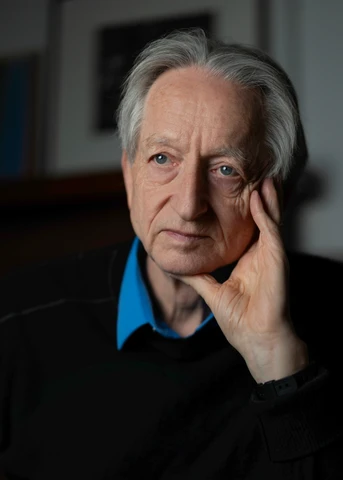 제프리 힌턴