쉽게 말하면, 퍼플렉시티는 언어 모델이 실제 문장의 다음 토큰을 얼마나 잘 예측했는지 재는 점수다. 값이 낮을수록 모델이 실제로 나온 토큰에 평균적으로 더 높은 확률을 주었다는 뜻이다. 같은 이름의 회사 Perplexity는 출처를 붙여 답하는 검색 서비스를 운영하며, 이 점수와는 이름만 같다.
| 분류 | 확률 모델 평가 지표(정보 이론·자연어 처리) · 동명의 AI 회사 |
|---|---|
| 지표 정의 | 관찰된 시퀀스에 대한 모델의 평균 음의 로그우도에 지수를 취한 값2,3,4 |
| 최초 제안 | 1977년 Jelinek 등의 음성 인식 과제 논문3 |
| 해석 | 값이 낮을수록 관찰된 결과에 평균적으로 더 높은 확률을 부여했음을 뜻함2 |
| 동명 회사 | Perplexity AI, Inc. · 2022년 설립, 샌프란시스코 |
| 회사 주력 제품 | 출처를 찾아 링크나 인용을 붙여 답하는 답변 엔진(answer engine) 검색 서비스5,6 |
퍼플렉시티(perplexity)는 인공지능에서 두 가지 뜻으로 쓰인다. 정보 이론과 자연어 처리에서 퍼플렉시티(PPL)는 확률 모델을 평가하는 내재적 점수다. 주어진 시퀀스에서 모델의 평균 음의 로그우도에 지수를 취한 값이다. 값이 낮을수록 모델이 실제로 관찰된 결과에 평균적으로 더 높은 확률을 주었다는 뜻이다. 이 수치는 평가 데이터, 토크나이저나 예측 단위, 전처리, 문맥 정책, 우도의 정의와 함께 볼 때만 의미가 있다.2,3,4
Perplexity AI, Inc.(줄여서 Perplexity)는 2022년에 설립된 샌프란시스코 기반 비상장 회사다. 웹 검색과 질의응답 서비스를 운영하며, 출처를 검색한 뒤 언어 모델로 답을 종합해 링크나 본문 인용을 붙인다. 회사는 이 제품을 '답변 엔진(answer engine)'이라고 부른다.5,6
이 두 뜻은 이름만 같을 뿐 관련이 없다. 회사가 곧 지표인 것은 아니며, 제품의 답변이 제공사 이름이 Perplexity라는 이유만으로 신뢰할 만한 품질 점수를 받는 것도 아니다.
이 문서는 지표를 먼저 다루고 회사를 나중에 다룬다. 회사의 제품, 요금, 소송 내용은 2026년 7월 28일 기준이며, 자금 조달 부분에는 2026년 8월 23일에 나온 보도가 포함된다. 이 정보는 바뀔 수 있다.
1. 평가 지표로서의 퍼플렉시티
1.1. 정의
시퀀스 x_{1:N} = (x_1, …, x_N)을 평가 단위의 열이라고 하자. 관찰된 각 단위에 조건부 확률을 주는 자기회귀 모델 q에 대해, 자연로그 단위의 평균 음의 로그우도와 표본 퍼플렉시티는 다음과 같이 정의한다.
\mathcal{L}_{\mathrm{nat}} = -\frac{1}{N}\sum_{i=1}^{N}\ln q(x_i\mid x_{<i})
\operatorname{PPL}_q(x_{1:N}) = \exp(\mathcal{L}_{\mathrm{nat}}) = \exp\left(-\frac{1}{N}\sum_{i=1}^{N}\ln q(x_i\mid x_{<i})\right)
\operatorname{PPL}_q(x_{1:N}) = 2^{-\frac{1}{N}\sum_{i=1}^{N}\log_2 q(x_i\mid x_{<i})}
\operatorname{PPL}_q(x_{1:N}) = \left(\prod_{i=1}^{N}\frac{1}{q(x_i\mid x_{<i})}\right)^{1/N}밑이 2인 로그를 써도 같은 값이 된다. 곱 형태로 보면 퍼플렉시티는 관찰된 단위에 부여된 확률의 기하평균의 역수다. 구현에서는 보통 확률을 곱하지 않고 로그 확률을 더한다. 로그 형태가 자연스러운 손실 함수이기도 하고, 작은 확률을 많이 곱하면 수치 언더플로가 생기기 때문이다.4
이 표기는 글자 그대로 읽어야 한다. 특정 조건부 규약 아래에서 모델 q가 이 특정 시퀀스에 준 점수를 나타낼 뿐, 모델과 독립된 텍스트를 나타내지는 않는다. 또 그 자체로 텍스트가 참인지, 유용한지, 문법적인지, 사람이 썼는지, 안전한지를 추정하지도 않는다.
예를 들어 짧은 평가에서 모델이 관찰된 다음 토큰 세 개에 각각 1/2, 1/4, 1/8의 확률을 주었다고 하자. 비트 단위 음의 로그 확률은 1, 2, 3이다. 토큰당 평균은 2비트이므로 PPL = 2² = 4다. 곱 형태로 계산해도 같은 값이 나온다.
\operatorname{PPL}=2^2=4
\left(\frac{1}{1/2}\cdot\frac{1}{1/4}\cdot\frac{1}{1/8}\right)^{1/3}=(2\cdot4\cdot8)^{1/3}=4이 결과는 '동등한 선택지' 값으로 해석할 수 있다. 모델의 평균 놀람도가 4개 중 하나를 균등하게 고르는 예측과 같다는 뜻이다. 다만 모델이 실제로 후보 4개를 유지했다거나 모든 예측 확률이 1/4였다는 뜻은 아니다. 매우 다른 확률 분포도 기하평균은 같을 수 있다.
1.2. 엔트로피·교차 엔트로피와의 관계
클로드 섀넌(Claude Shannon)은 1948년 연구에서 엔트로피를 확률 분포 아래의 평균 불확실성 또는 정보량으로 정의했다. 참 분포 p와 모델 분포 q에 대해 비트 단위 교차 엔트로피는 다음과 같다.2
H(p,q)=-\mathbb{E}_{X\sim p}\log_2 q(X)
H(p,q)=H(p)+D_{\mathrm{KL}}(p\Vert q)D_KL은 쿨백-라이블러 발산이다. 따라서 교차 엔트로피는 p의 엔트로피보다 작지 않으며, p 아래 거의 모든 점에서 q가 p와 같을 때 등호가 성립한다. 교차 엔트로피를 비트로 잰 모집단 퍼플렉시티는 2^{H(p,q)}다. 유한한 테스트 세트 점수는 알 수 없는 기댓값을 표본 평균으로 대신한다.
최대우도로 학습한 언어 모델에서는 같은 관측에 대해 평균 교차 엔트로피를 최소화하는 것과 퍼플렉시티를 최소화하는 것이 동등하다. 지수 함수가 단조 증가하기 때문이다. 퍼플렉시티로 보고하면 로그 손실을 해석하기 쉬워질 수 있지만, 바탕의 평균 음의 로그우도에 정보를 더하지는 않는다. 구분할 점이 둘 있다.
- 엔트로피는 명시된 단위와 조건 설정 아래에서 한 분포의 성질이다.
- 교차 엔트로피나 퍼플렉시티는 한 분포를 다른 분포나 모델이 준 확률로 평가한 값이다.
테스트 세트 퍼플렉시티를 '영어의 엔트로피'라고 부르려면 계산이 뒷받침하지 못하는 많은 가정이 필요하다. 그 결과에는 언어에 있는 불확실성뿐 아니라 모델, 표본, 분절 방식, 이용 가능한 문맥이 함께 반영된다.
1.3. 범위와 실효 선택지 해석
정규화된 확률 모델에서 관찰된 각 확률은 1 이하이므로, 유한한 표본 퍼플렉시티는 1 이상이다. 값이 정확히 1이라는 것은 채점한 모든 위치의 관찰 결과에 확률 1을 주었다는 뜻이다. 그렇다고 다른 시퀀스에서 완벽한 예측기임이 입증되지는 않는다.
퍼플렉시티에는 어휘 크기로 정해지는 유한한 상한이 없다. 어휘 크기 V인 균등 분포의 퍼플렉시티는 V지만, 모델은 관찰된 토큰에 1/V보다 훨씬 작은 확률을 줄 수도 있다. 관찰 토큰의 확률이 0에 가까워지면 음의 로그우도와 퍼플렉시티는 한없이 커질 수 있다. 채점 대상 결과 하나에라도 확률 0이 주어지면, 스무딩처럼 평가 절차가 그 확률을 바꾸지 않는 한 표본 퍼플렉시티는 무한대다.
'실효 분기 인자(effective branching factor)'라는 말은 2^H를 같은 엔트로피를 가진 동일 확률 선택지 수로 해석하는 데서 나왔다. Jelinek 등은 1977년 음성 인식 과제에서 언어 모델의 난이도를 논하며 퍼플렉시티를 도입했다. 이들은 어휘 크기와 단순한 분기 수가 불균등한 확률을 충분히 반영하지 못한다고 주장했다.3
이 해석은 평균 로그 손실에서의 동등성으로 유지될 때만 유용하다. 탐색 트리의 자식 노드 수나 모델이 의식적으로 고려한 단어 수의 추정이 아니며, 예측 분포가 균등하다는 주장도 아니다.
1.4. 역사적 발전
섀넌은 1948년 통신 시스템에서 확률, 부호 길이, 불확실성을 연결했다. 이후 통계적 언어 모델링은 이 개념을 써서 시퀀스에 확률을 부여했다. 1977년 Jelinek 등은 음성 인식에서 언어 모델이 주는 난이도를 확률에 민감하게 재는 척도로 퍼플렉시티를 제안했다.2,3
초기 언어 모델은 흔히 n-그램을 썼다. 연쇄 법칙에 따르면 시퀀스의 확률은 다음과 같다.
q(x_{1:N})=\prod_{i=1}^{N}q(x_i\mid x_{<i})n-그램 모델은 전체 이력을 고정된 개수의 앞선 단위로 근사한다. 스무딩이 필수적인 이유는 스무딩하지 않은 빈도 모델이 본 적 없는 사건에 0 확률을 주어 테스트 퍼플렉시티가 무한대가 되기 때문이다. n-그램 시기에는 보류 퍼플렉시티가 일치된 평가 조건에서 스무딩, 보간, 가지치기, 모델 차수 선택을 비교하는 편리한 내재적 척도가 되었다.4
신경망 확률 모델도 같은 평가 목표를 유지했다. 요슈아 벤지오(Yoshua Bengio) 등의 2003년 신경망 확률 언어 모델은 단어 표현과 단어열의 확률 함수를 함께 학습했고, 그 연구에서 살펴본 n-그램 기준선보다 나은 결과를 보고했다. 이후 순환 신경망과 트랜스포머 언어 모델도 음의 로그우도나 퍼플렉시티를 계속 보고했다. 하위 과제, 사람 평가, 사실성, 안전성, 효율성 평가가 현대 시스템에 필요해진 뒤에도 그랬다.7
이 연속성이 호환되지 않는 벤치마크 간 비교를 부추기면 오해를 낳을 수 있다. 펜 트리뱅크(Penn Treebank)의 한 전처리에서 나온 단어 단위 n-그램 점수, 다른 말뭉치에서 나온 서브워드 트랜스포머 점수, 마스크 모델의 유사 퍼플렉시티는 하나의 보편적 척도 위의 점수가 아니다.
2. 올바른 계산 방법
2.1. 보류 데이터와 평가 대상
학습 퍼플렉시티는 모수 추정에 쓴 관측에 대한 적합도를 잰다. 보류 퍼플렉시티는 모델을 맞추는 데 쓰지 않은 관측에 대한 예측 로그 손실을 추정한다. 표본화된 대상 분포로의 일반화에 대한 증거가 되는 것은 후자뿐이며, 그것도 타당한 분할을 전제로 한다. 평가에는 다음을 명시해야 한다:
- 정확한 말뭉치와 버전
- 분할 단위(문서, 화자, 사용자, 시간 구간 등)
- 중복과 근사 중복의 처리 방식
- 모든 정규화와 필터링
- 학습 데이터에 평가 예제가 들어갈 수 있었는지
- 개발 단계 결과가 모델, 체크포인트, 프롬프트 선택에 영향을 주었는지
- 결과를 일반화하려는 모집단이나 도메인
테스트 자료가 학습 데이터에 있었다면 낮은 퍼플렉시티는 데이터 오염이나 암기를 반영할 수 있다. 테스트 분포가 실제 배포 환경과 다르면 정밀한 도메인 내 추정도 도메인 밖에서는 무관할 수 있다. 같은 보류 표본으로 많은 대안을 고르면 이긴 결과가 낙관적으로 선택될 수 있다. 학습 퍼플렉시티는 떨어지는데 검증 퍼플렉시티가 평평하거나 오르면 과적합을 시사할 수 있지만, 그 자체로 증명되지는 않는다. 차이는 확률적 규제, 전처리 차이, 작은 표본, 독립이 아닌 기록에 의해서도 생길 수 있다. 평가 코드는 모델을 의도된 추론 모드로 두고 동일한 채점 규칙을 적용해야 한다.
2.2. 토큰화와 예측 단위
원시 토큰 퍼플렉시티는 토크나이저에 따라 달라진다. 한 토크나이저는 단어 하나를 토큰 하나로, 다른 토크나이저는 여러 토큰으로 나눌 수 있다. 예측의 개수와 난이도가 바뀌므로 토큰당 평균은 일반적으로 직접 비교할 수 없다. 어휘 크기만 맞춘다고 이 문제가 해결되지는 않는다. 같은 이름의 토크나이저라도 결과가 달라질 수 있다. 이유는 다음과 같다:
- 토크나이저 버전이나 어휘
- 공백, 유니코드, 대소문자, 구두점의 처리
- 시퀀스 시작·끝 기호의 포함 여부
- 특수 토큰이나 패딩 토큰을 채점하는지
- 알 수 없는 토큰의 처리
- 문서 경계에서 상태를 초기화하는지
- 긴 입력을 자르거나 나누는 방식
Cao와 Rimell은 서브워드 언어 모델을 결정론적 토큰화 하나로만 평가하면 일반적으로 기저 문자열의 확률을 계산하지 못한다는 것을 보였다. 문자열의 주변 가능도는 가능한 모든 토큰화에 걸친 확률의 합이며, 이들의 연구는 그 양을 추정하는 방법을 개발했다. 대부분의 공개된 토큰 단위 평가는 대신 토크나이저가 고른 분절을 채점한다. 이는 밝혀 두면 허용되지만, 토크나이저와 무관한 문자열 확률과 혼동하면 안 된다.8
2.3. 문자·바이트 단위로 환산
같은 텍스트를 쓸 수 있다면 전체 음의 로그우도를 외부 단위로 정규화할 수 있다. 자연로그 단위의 전체 음의 로그우도를 L, 텍스트의 문자 수를 N_c, 바이트 수를 N_b라 하면 다음과 같다.
L=-\sum_{i=1}^{N}\ln q(x_i\mid x_{<i})
\operatorname{BPC}=\frac{L}{N_c\ln 2}\qquad\text{and}\qquad\operatorname{BPB}=\frac{L}{N_b\ln 2}BPC와 BPB는 모델이 같은 문자열을 내부 토큰으로 나누는 방식이 주는 직접 영향을 줄인다. 그렇다고 모든 평가 차이를 없애지는 않는다. 문자 세기는 유니코드 정규화와 경계 규약을 명시해야 하고, 바이트 세기는 바이트 표현에 따라 달라지며, 모델의 문맥, 전처리, 토큰화 확률의 주변화 여부에 따라서도 차이가 날 수 있다. 단어 단위 토큰화 평가라면 단어당 비트는 log₂(PPL)이다. 이런 단위 환산은 분모의 개수가 같은 텍스트와 같은 전체 손실을 가리킬 때만 정당하다.
2.4. 고정 문맥 창
유한한 컨텍스트 창을 가진 자기회귀 모델은 긴 문서의 모든 토큰을 그 앞의 전체 이력에 조건으로 둘 수 없다. 그러므로 평가 정책이 지표의 일부가 된다.
가장 단순하지만 비효율적인 방법은 토큰을 하나씩 옮기며 허용된 가장 긴 앞 문맥을 유지하고 새 토큰 하나만 채점하는 것이다. 흔한 근사는 선택한 보폭(stride)으로 겹치는 창을 쓰는 것으로, 각 구간이 문맥을 제공하고 손실은 새로 들어온 토큰에만 계산한다. 겹치지 않는 청크 방식은 더 싸지만, 청크가 바뀔 때마다 연속 사용이라면 가질 수 있었던 문맥을 잃는다. 허깅페이스 문서는 겹치지 않는 블록에서 보폭이 있는 슬라이딩 창으로 바꾸면 GPT-2의 보고 퍼플렉시티가 달라진다는 것을 보여준다. 이용 가능한 문맥이 달라지기 때문이다. 재현 가능한 보고서는 다음을 밝혀야 한다:9
- 최대 문맥 길이
- 보폭 또는 겹침 크기
- 각 창에서 손실에 기여하는 위치
- 상태 초기화가 문서 단위인지 말뭉치 경계에서만인지
- 문서의 첫 토큰을 채점하는지와 그때 쓰는 문맥
- 마지막 구간이 짧을 때 손실에 주는 가중치
구간별 퍼플렉시티를 평균하는 것은 대개 잘못이다. 구간마다 채점되는 토큰 수가 다를 수 있기 때문이다. 구간별 음의 로그우도를 모두 더하고, 채점된 전체 단위 수로 나눈 뒤 지수를 한 번만 취해야 한다.
2.5. 조건부 모델과 시퀀스 변환 모델
퍼플렉시티는 조건부 모델에도 정의할 수 있다. 입력 x가 주어졌을 때 목표 시퀀스 y_{1:M}의 퍼플렉시티는 다음과 같다.
\operatorname{PPL}(y\mid x)=\exp\left(-\frac{1}{M}\sum_{j=1}^{M}\ln q(y_j\mid y_{<j},x)\right)기계 번역이나 요약에서 이 값은 교사 강요(teacher forcing) 아래에서 참조 목표의 가능도를 평가한다. 자유롭게 생성된 출력의 품질을 직접 재는 것은 아니다. 시스템은 참조 문장에 높은 확률을 주면서도 특정 탐색 방법에서는 잘 디코딩하지 못할 수 있고, 반대로 참조 가능도는 낮지만 적절한 대안을 생성할 수도 있다. 따라서 종단간 과제 지표와 사람 평가가 여전히 필요하다. 분모도 분명해야 한다. 어떤 소프트웨어는 패딩이 아닌 목표 토큰당 손실을 보고하고, 다른 코드는 실수로 패딩, 프롬프트 토큰, 입력 토큰을 포함할 수 있다. 이런 선택에 따라 점수가 달라진다.
2.6. 마스크 언어 모델과 유사 퍼플렉시티
표준 양방향 마스크 언어 모델은 문장을 왼쪽에서 오른쪽으로 인수분해해 정규화된 다음 토큰 확률을 만들지 않는다. 그래서 일반적인 자기회귀 퍼플렉시티를 직접 정의할 수 없다. 조건 없이 학습 손실을 자기회귀 공식에 대입하면 서로 다른 대상이 섞인다.
Salazar 등은 마스크 언어 모델을 유사 로그우도(pseudo-log-likelihood)로 채점하자고 제안했다. 토큰을 하나씩 가리고, 나머지 관찰된 토큰이 주어졌을 때 그 토큰의 조건부 로그 확률을 합하는 방식이다. 이 합의 음의 평균에 지수를 취한 것이 유사 퍼플렉시티(pseudo-perplexity)다.10
유사 퍼플렉시티는 지정된 마스크 모델 아래에서 문장을 순위 매기거나 비교하는 데 유용하지만, 시퀀스의 연쇄 법칙 가능도는 아니다. 따라서 따로 이름을 붙여 별도로 보고해야 한다. 여러 토큰을 한꺼번에 가리거나, 은닉 상태를 재사용하거나, 점수를 근사하는 변형은 계산량이 적을 수 있지만 추가 프로토콜 선택을 만든다. 비교하려면 같은 마스킹과 정규화 방법을 써야 한다.
2.7. 토픽 모델과 기타 확률 모델
이 정의는 모델이 관찰에 확률을 부여하고 정규화 단위가 정해져 있다면 다음 토큰 신경망 모델을 넘어 확장된다. 예를 들어 토픽 모델은 보류 문서의 가능도나 그로부터 도출한 퍼플렉시티를 보고할 수 있다. 그 점수는 토픽 모델 아래의 예측 적합도를 평가할 뿐, 발견된 토픽이 사람에게 일관되거나 유용하게 보이는지는 직접 재지 않는다.
Chang 등은 토픽 모델의 가능도를 사람의 해석 과제와 비교했다. 연구한 설정에서는 보류 가능도가 더 좋은 모델이 사람이 의미상 덜 일관된다고 판단한 토픽을 만들 수 있었다. 이 결과는 퍼플렉시티가 쓸모없다는 뜻이 아니다. 가능도와 사람의 해석 가능성은 서로 다른 평가 대상임을 보여준다.11
음성 토큰 모델, 이미지 토큰 모델, 멀티모달 시퀀스 모델도 비슷한 문제를 낳는다. 토큰이 언어적 단어가 아니라 학습된 음향 단위나 시각 단위를 나타낼 수 있기 때문이다. 그러면 전역 토큰 퍼플렉시티는 그 표현의 속도, 중복성, 분절 선택까지 물려받는다. 단위와 지각 품질의 관계는 가정하지 말고 검증해야 한다.
2.8. 근소한 차이의 결과 비교
수치 차이가 작다고 자동으로 의미 있는 개선이 되지는 않는다. 퍼플렉시티는 평균 로그 손실의 지수이므로, 비교는 바탕의 로그 손실 단위에서 가장 명확하다. 같은 토큰 프로토콜에서 모델 A의 퍼플렉시티가 P_A, 모델 B의 퍼플렉시티가 P_B라면 토큰당 비트 차이는 다음과 같다.
Δ=log2 PA-log2 PB=log2((PA)/(PB))
이 변환은 척도를 분명하게 한다. 20에서 19로 줄어든 것과 200에서 190으로 줄어든 것은 절대 변화량은 달라도 상대 비율은 같다.
불확도는 데이터 의존성을 반영하는 단위에서 추정해야 한다. 한 문서 안의 토큰들은 독립 관측이 아니므로, 수백만 토큰을 독립 시행으로 취급하면 비현실적으로 좁은 구간이 나올 수 있다. 표본화 주장에 따라 문서, 화자, 대화, 사용자, 시간 블록이 더 타당한 재표본 단위일 수 있다. 두 모델이 같은 예제를 채점하므로 짝비교가 유용하다.
집계 결과는 이질적 효과를 가릴 수 있다. 한 모델이 자주 나오는 상용구에서는 나아지지만 드문 이름, 다른 언어, 긴 문서, 문맥 창의 뒷부분에서는 나빠질 수 있다. 문서별 로그 손실, 분위수, 도메인과 언어별 구분, 문맥 내 위치, 토큰 빈도, 이상치가 전체 손실에서 차지하는 비율 같은 진단이 유용하다. 통계적 유의성은 중요성과 다르다. 로그 손실의 아주 정밀한 감소가 의도한 응용에서는 측정 가능한 이득이 없을 수 있다. 반대로 안전이 중요한 드문 사건에 집중된 변화는 말뭉치 평균이 작아도 중요할 수 있다. 따라서 결론에는 통계적 근거와 과제에서의 결과를 함께 적어야 한다.
3. 용도와 한계
3.1. 모델 내재 개발
퍼플렉시티는 토큰별 로그 손실이 로그 공간에서 합산되고, 관찰된 시퀀스 외에 별도의 사람 라벨이 필요 없으며, 많은 하위 평가보다 계산이 효율적이라는 점에서 쓸모가 있다. 고정된 프로토콜에서는 다음을 비교하는 데 도움이 된다:
- 스무딩과 보간 방법
- 모델 구조나 매개변수 설정
- 학습 중 체크포인트
- 문맥 길이나 검색 제거 실험(ablation)
- 도메인 적응
- 적절한 정규화를 거쳐 보고한 토크나이저 선택
- 예측 확률을 바꾸는 압축이나 양자화 변화
낮은 점수가 뒷받침하는 가장 강한 주장은 좁다. 그 평가와 프로토콜에서 모델이 평균 음의 로그우도를 더 낮게 얻었다는 것뿐이다. 더 넓은 주장에는 추가 근거가 필요하다.
3.2. 음성 인식
퍼플렉시티는 음성 인식에서 언어 모델의 난이도를 평가하는 데서 시작되었다. 언어 모델 퍼플렉시티가 낮으면 모델이 참조 전사에 더 높은 확률을 주므로 도움이 될 수 있다. 그러나 인식은 음향 근거, 언어 모델 점수, 탐색, 가지치기, 보정을 함께 쓰므로 단어 오류율(WER)이 낮아진다는 보장은 없다.3
Chelba와 Jelinek은 일부 언어 모델 비교에서 기존 퍼플렉시티와 WER의 상관이 낮다는 것을 보고했고, 혼동을 음향 유사도로 가중하는 음향 민감 대안을 제안했다. 따라서 음성 시스템 주장에는 WER이나 다른 종단 간 지표를 보고해야 한다. 퍼플렉시티는 인식 정확도의 대용물이 아니라 언어 모델 구성요소를 위한 내재적 진단으로 남는다.12
3.3. 도메인 적합성과 데이터 선별
한 도메인에서 주로 학습한 모델은 다른 도메인의 자료에 더 높은 퍼플렉시티를 주는 경우가 많다. 연구자들은 이 성질을 말뭉치 선택, 도메인 필터링, 이상 탐지에 활용한다. 해석은 상대적이어야 한다. 높은 퍼플렉시티는 '이 채점 모델과 프로토콜에서 가능성이 낮다'는 뜻이지 '나쁜 텍스트'라는 뜻이 아니다.
퍼플렉시티가 높은 정당한 이유에는 새 주제, 다른 언어나 방언, 고유명사, 코드, 수식, 시, 전사 오류, 적대적 훼손이 있다. 낮은 정당한 이유에는 흔한 상용구, 중복, 암기된 구절, 정형화된 글, 실제 도메인 내 산문이 있다. 한 말뭉치에서 학습한 임계값이 다른 말뭉치에 자동으로 옮겨가지는 않는다.
데이터 큐레이션 설계에서는 채점 모델, 학습 데이터, 토크나이저, 임계값 선택 절차, 언어와 도메인별 점수 분포를 보고해야 한다. 필터링이 최종 모델을 실제로 개선하는지, 아니면 가치 있는 다양성을 지우기만 하는지는 사람의 검토와 하위 과제의 제거 실험으로 판단해야 한다.
3.4. 측정하지 않는 것
퍼플렉시티는 일반 지능이나 답변 품질 점수가 아니다. 그 자체로는 다음을 측정하지 못한다:
| 속성 | 퍼플렉시티만으로 부족한 이유 |
|---|---|
| 사실 정확성 | 흔한 거짓 진술에도 높은 확률이 부여될 수 있다. |
| 논리적 타당성 | 국소적으로 그럴듯한 토큰이 타당하지 않은 논증을 이룰 수 있다. |
| 긴 글의 일관성 | 토큰 평균은 중요한 장거리 의존성의 실패를 가릴 수 있다. |
| 지시 따르기 | 우도 목표는 응답이 사용자 요청을 따랐는지 부호화하지 않는다. |
| 도움 되는 정도와 관련성 | 통계적으로 그럴듯한 이어짐이 과제를 다루지 않을 수 있다. |
| 별도 답변의 보정 | 토큰 확률이 곧 답이 맞을 확률인 것은 아니다. |
| 안전성과 공정성 | 피해와 집단 간 격차는 별도 정의와 검사가 필요하다. |
| 효율성 | 같은 퍼플렉시티를 가진 두 모델도 지연 시간, 메모리, 에너지 사용이 크게 다를 수 있다. |
| 사람의 선호 | 선호는 사용 사례에 따라 다르며 예측 우도와 어긋날 수 있다. |
Stanford 텍스트는 내재적 평가와 외재적 평가를 구분하고, 모델이 더 큰 시스템의 구성요소일 때는 응용에서의 성능이 핵심 검사라고 설명한다. 그래서 현대 언어 모델 평가는 우도를 벤치마크 과제, 통제된 사람 연구, 강건성 검사, 보정 분석, 안전성 평가, 비용 측정과 함께 쓴다.4
3.5. AI 생성 텍스트 탐지
우도 관련 신호는 통제된 실험 설정에서 일부 기계 생성 텍스트와 사람 글을 구분하는 데 도움이 될 수 있다. 예를 들어 GLTR은 언어 모델 아래 관찰된 각 토큰의 순위와 확률을 시각화했고, 2019년 실험에서 이 단서가 사람이 생성 문단을 식별하는 데 도움이 되었다고 보고했다. 이후 DetectGPT는 단일 퍼플렉시티 임계값 대신 임의 변형 아래 로그 확률의 곡률을 써서, 연구한 모델과 데이터 설정에서 제로샷 탐지를 수행했다.13,14
사람 글은 퍼플렉시티가 높고 기계 글은 낮다는 보편 규칙은 없다. 점수는 생성기, 디코딩 방법, 도메인, 언어, 프롬프트, 편집, 탐지기의 채점 모델에 따라 달라진다. 사람은 예측 가능한 평범한 글을 쓸 수 있고, 생성기는 높은 온도로 샘플링하거나 낯선 도메인을 다루거나 편집과 패러프레이즈를 거칠 수 있다.
Sadasivan 등은 패러프레이즈가 여러 탐지기를 크게 떨어뜨릴 수 있음을 보였고, 사람 텍스트와 기계 텍스트 분포 사이의 통계적 거리로 탐지의 한계를 분석했다. Liang 등은 평가한 탐지기들이 비원어민 영어 글에 높은 오탐률을 보인다는 것을 발견했고, 어휘 다양성을 높이면 실험에서 그 오탐이 줄었다고 보고했다. 이 연구들이 모든 탐지기가 항상 실패한다는 것을 증명하지는 않는다. 다만 퍼플렉시티 유사 점수를 저작의 증거로 취급하거나 그 점수만으로 징계 결정을 내리면 안 되는 이유를 보여준다.15,16
안전한 해석은 범주적 판정이 아니라 증거적 판단이어야 하며, 다음을 따른다:
- 탐지기 점수는 문서화된 작동점에서 나온 모델 출력이다.
- 오류율은 최신의 대표적인 생성기와 사람 집단에서 측정해야 한다.
- 오탐률과 미탐률은 임계값과 기저율에 따라 달라진다.
- 편집된 글과 여러 사람이 쓴 글은 따로 검사해야 한다.
- 중대한 결론에는 과정 증거, 출처 기록, 사람의 검토가 필요하다.
3.6. 보고 체크리스트
퍼플렉시티 결과가 재현되려면 숫자에 맥락이 함께 있어야 한다. 완전한 보고에는 다음이 포함되어야 한다:
- 모델 정체: 체크포인트, 매개변수 버전, 수치 정밀도, 평가 모드
- 데이터 정체: 데이터셋 이름, 릴리스, 분할, 관련 라이선스, 가능하면 내용 기반 식별자
- 오염 통제: 중복, 학습과 테스트의 겹침, 벤치마크 노출을 어떻게 검사했는지
- 예측 단위: 단어, 서브워드, 문자, 바이트, 음향 토큰 등
- 토크나이저: 구현, 어휘 버전, 정규화, 특수 토큰 정책
- 우도: 자기회귀 로그우도, 조건부 목표 우도, 주변 가능도, 유사 로그우도 중 무엇인지
- 문맥 정책: 최대 길이, 보폭, 겹침, 초기화 경계, 손실에서 제외한 위치
- 분모: 채점된 토큰, 단어, 문자, 바이트의 정확한 개수
- 집계: 배치 퍼플렉시티의 비가중 평균이 아니라 전체 음의 로그우도를 전체 단위 수로 나눈 값
- 불확도: 문서 단위 변동, 부트스트랩 구간, 또는 근접 결과 비교에 쓴 다른 정당한 측정
- 선택 이력: 평가 분할이 체크포인트나 하이퍼파라미터 선택에 영향을 주었는지
- 동반 지표: 의도한 용도에 필요한 과제, 사람, 안전, 보정, 효율 측정
이 세부 정보가 없으면 단독 숫자는 감사하기 어렵고 비교하기도 위험하다.
4. 회사 Perplexity
4.1. 정체성과 설립
Perplexity AI, Inc.는 샌프란시스코에 본사를 둔 미국 인공지능 회사다. 2022년 8월 Aravind Srinivas, Denis Yarats, Johnny Ho, Andy Konwinski가 설립했다. Srinivas가 최고경영자다. 회사는 2022년 12월 첫 공개 답변 제품을 출시했고, 이후 소비자 구독, 기업 요금제, 개발자 API, 브라우저, 에이전트형 과제 제품으로 확장했다.5,17,18
회사는 검색을 앞세운 흐름을 강조한다. 사용자가 질문하면 서비스가 웹을 검색하고, 검색된 자료에서 내용을 종합해 인용과 링크를 붙인 답을 보여준다. '답변 엔진'은 제품 명칭이지 기술적 보장이 아니다. 인용은 검증을 가능하게 하지만, 각 문장이 연결된 출처에서 따라 나온다는 증명은 아니다. 중요한 주장에는 사용자가 여전히 출처를 확인해야 한다.5,6
4.2. 초기 자금 조달과 보도된 비공개 기업가치
퍼플렉시티는 비상장 회사라서 상장사 공시로는 재무 상태가 드러나지 않는다. 자금 총액, 매출, 기업가치, 사용자 수는 출처와 상태에 따라 나눠 봐야 한다.
회사는 2023년 3월 2,560만 달러 규모의 시리즈 A를 발표했다. 같은 발표에서 2022년 9월 310만 달러 규모의 시드 라운드를 먼저 받았다고 밝혔다. 2024년 1월에는 7,360만 달러 규모의 시리즈 B를 발표하며 누적 자금이 1억 달러에 이르렀다고 밝혔다. 이것들은 회사 발표이며 감사를 거친 재무제표가 아니다.18,19
기업가치는 출처가 밝혀지지 않은 취재원을 통해 보도되기도 했다. 2025년 9월 The Information은 투자 약정 2억 달러와 기업가치 200억 달러를 보도했다. Reuters는 이를 되풀이하면서도 정보를 즉시 검증할 수 없다고 밝혔고, 회사는 즉각 논평하지 않았다. 검토한 자료에서 완료된 자금 조달 발표로 확인되지 않은 약 210억 달러나 226억 달러라는 수치는 이 문서에서 사실로 제시하지 않는다.20
2026년 4월 Financial Times는 3월 연간 반복 매출(ARR)이 4억 5,000만 달러를 넘었다고 보도했다. 이는 비상장 회사의 운영 지표에 대한 언론 보도이며 감사 결과가 아니므로, 정확한 수치는 확인된 것이 아니라 보도된 것으로 표현해야 한다. 2025년 TechCrunch는 Srinivas의 말을 인용해 서비스가 한 달에 7억 8,000만 건의 질의를 받았다고 전했다. 질의 수는 월간 활성 사용자 수와 같지 않다. 이 문서는 집계 통계 제공자의 주장이 독립적으로 검증할 만큼 강한 근거가 되지 못한다고 보고, 기존의 월간 활성 사용자 4,500만 명 주장은 반복하지 않는다.21,22
2026년 8월 23일 The Information은 논의 내용을 아는 사람들을 인용해 Nvidia가 퍼플렉시티에 투자하는 것을 논의 중이라고 보도했다. 이 투자는 퍼플렉시티의 기업가치를 300억 달러 이상으로 평가하는 지분 투자 라운드의 일부로 논의되고 있다. 보도는 라운드 규모가 수십억 달러이고 제안된 기업가치가 이전 자금 조달 때 보도된 기업가치보다 50% 이상 높다고 전했다. 또 연간 환산 매출이 7억 5,000만 달러를 넘으며, 2026년 초에는 2억 5,000만 달러 미만이었다고 했다. Reuters는 이를 되풀이하면서도 독자적으로 검증하지 못했다고 밝혔다. 퍼플렉시티는 논평을 거부했고, Nvidia는 즉시 답하지 않았다.23,24
같은 보도는 Nvidia가 앞서 퍼플렉시티의 일부 기술에 라이선스를 주고 직원 일부를 채용하는 대가로 수십억 달러를 내는 방안을 검토했다고 전했다. 그 논의가 왜 일반 지분 투자로 바뀌었는지는 분명하지 않다고 했다. 이 보도는 지분 라운드가 마감되었다거나 최종 기업가치가 정해졌다거나, 앞선 라이선스와 채용 논의가 계약으로 이어졌다는 것을 확정하지 않는다.23
4.3. 검색·답변 파이프라인
퍼플렉시티는 완전한 생산 아키텍처를 공개하지 않으며, 논문이나 버전 명세 없이 제품이 바뀔 수 있다. 도움말 센터는 대략의 흐름을 설명한다. 질문을 해석하고, 현재 웹 자료를 검색하고, 검색된 정보를 요약하고, 번호가 붙은 출처 링크를 붙인다. Vespa 측 설명에 따르면 퍼플렉시티는 Vespa로 어휘 검색, 의미 검색, 구조화 검색을 결합하고, 후보를 걸러 순위를 매기며, 구절을 고르고, 언어 모델에 자료를 주기 전에 색인을 계속 갱신한다.6,25
검색 증강 생성 파이프라인의 일반적인 표현은 다음과 같다:
- 질의 처리: 자연어 요청을 해석하고, 분해하거나 다시 표현할 수 있다.
- 검색: 검색 인프라가 어휘, 벡터, 구조화 신호로 후보 문서나 구절을 고른다.
- 순위와 필터링: 관련성, 최신성, 기타 내부 기준으로 후보의 순위를 매긴다.
- 문맥 구성: 선택된 구절, 메타데이터, 링크를 언어 모델의 문맥 안에 조립한다.
- 생성: 질의와 검색 문맥을 조건으로 모델이 응답을 종합한다.
- 인용 표시: 인터페이스가 답의 구절이나 문장을 출처 링크와 연결한다.
이 그림의 세부 중 일부만 퍼플렉시티에 대해 공개적으로 문서화되어 있다. 모든 질의가 같은 경로를 따른다거나, 생성이 검색된 사실만 복사하도록 제한된다거나, 인용이 공개되지 않은 특정 알고리즘으로 정렬된다는 뜻으로 읽으면 안 된다.
검색은 모델 매개변수에 저장된 정보에 대한 의존을 줄이고 최신 출처를 드러낼 수 있지만, 고유한 실패 방식이 따로 있다. 검색 계층은 결정적 문서를 놓치거나, 품질이 낮은 사본을 가져오거나, 권위보다 관련성 기준으로 출처를 올리거나, 서로 모순되는 페이지를 반환할 수 있다. 생성 계층은 구절을 잘못 읽거나, 서로 다른 출처의 주장을 섞거나, 단서를 빼거나, 문장의 일부만 뒷받침하는 인용을 붙일 수 있다. 따라서 연결된 출처는 감사 추적이지 보증이 아니다.
독자는 다음을 확인해야 한다:
- 인용된 페이지에 주장된 사실이 실제로 있는가?
- 그 페이지가 1차 자료인가, 아니면 다른 보도를 되풀이하는가?
- 게시일이 시간에 민감한 주장과 맞는가?
- 답변이 범위와 불확실성을 보존하고, 어떤 진술이 주장(혐의)인지 구분하는가?
- 반대 자료나 나중의 정정이 빠져 있지 않은가?
- 수치 답이 출처와 같은 단위, 기간, 정의를 쓰는가?
이 확인은 의학, 법률, 금융, 속보, 비상장 회사 지표에서 특히 중요하다.
4.4. 소비자 검색 모드
서비스의 기본 검색 화면은 링크가 붙은 대화형 답을 돌려준다. 후속 질문은 앞선 대화를 문맥으로 쓸 수 있다. 퍼플렉시티의 2026년 5월 도움말 기사는 사용 가능한 모드로 일반 검색, Pro 검색, 리서치, 파일과 앱 만들기를 나열했다.5,6
Pro 검색은 기본 모드보다 복잡한 검색 과정을 거친다. 퍼플렉시티의 2026년 7월 문서에 따르면 여러 유형의 출처를 검색하고, 대화 문맥을 유지하며, 코드 해석을 쓰고, 유료 사용자는 지원되는 모델 중에서 고를 수 있다. 모델 이름과 할당량은 제품 설정이며 지속적 속성이 아니므로, 주 단위로 바뀔 수 있는 목록을 고정해서는 안 된다.26
Deep Research는 2025년 2월 출시되었으며, 더 긴 보고서를 만들기 전에 출처를 반복적으로 검색하고 읽는다. 출시 발표는 자료를 모으면서 리서치 계획을 다듬는 루프를 설명했고, 문서나 PDF로 내보내기를 허용한다고 했다. 발표에 적힌 특정 출처 수나 작업 시간은 벤더가 보고한 작동 설명이지 모든 질의에 대한 보장이 아니다. 회사가 공개한 벤치마크 점수도 벤치마크 버전, 엔드포인트, 평가 방법과 함께 해석해야 하며, 일반적인 정확도 백분율로 읽으면 안 된다.27
파일과 앱 만들기는 리서치나 지시문을 산출물로 바꾼다. 2026년 7월 16일 기준으로 도움말 센터는 DOCX 또는 PDF 문서, XLSX 스프레드시트, PPTX 프레젠테이션, HTML 앱을 나열했고, 접근과 한도는 요금제에 따라 다르다. 산출물 생성은 추가 정확성 문제를 낳는다. 수식, 인용, 레이아웃, 실행 코드는 채팅 미리보기만이 아니라 결과 파일에서 검증해야 한다.28
이 모드들은 핵심 검색과 생성 개념을 공유하지만 시간, 도구, 연산 예산이 다르다. 모드 이름이 안정적인 과학적 시스템을 뜻하지는 않으므로, 재현 가능한 제품 평가에서는 날짜, 계정 등급, 선택 모델, 프롬프트, 위치, 사용한 파일이나 커넥터를 기록해야 한다.
4.5. Comet 브라우저
Perplexity Comet은 2025년 7월 출시된 Chromium 기반 웹 브라우저로, 퍼플렉시티 검색과 어시스턴트 기능이 브라우징에 통합되어 있다. 현재 도움말 문서는 표준 브라우저 기능과 Chrome 확장 프로그램 지원, 열린 페이지에 대한 문맥형 질문, 요약, 자연어 탭 명령, 커넥터를 통한 이메일이나 캘린더 데이터의 선택적 접근을 설명한다.29
Comet은 어시스턴트가 사용자를 대신해 웹사이트나 워크플로를 조작하는 브라우저 에이전트 방식의 동작도 지원한다. 이 기능은 일반 검색과 세 가지 점에서 다르다.
첫째, 에이전트는 인증된 서비스와 개인 데이터에 접근할 수 있다. 브라우저 기록, 저장된 자격 증명, 커넥터, 페이지 내용의 범위가 중요하다. 사용자는 권한을 검토하고 중대한 행동을 확인해야 한다. 둘째, 웹 작업은 모호하거나 되돌릴 수 없을 수 있다. 쇼핑, 메시지 발송, 예약, 양식 제출은 사실 검색만이 아니라 사용자 의도의 정확한 해석을 요구한다. 인터페이스 변경, 봇 방지 장치, 숨은 페이지 상태 때문에 텍스트 답변에서는 생기지 않을 실패가 나올 수 있다.
셋째, 사용자의 허락이 웹사이트의 자동 접근 허가를 자동으로 뜻하지는 않는다. 이 구분은 Amazon이 Comet의 비밀번호로 보호된 영역 접근을 문제 삼아 낸 소송에서 핵심이 되었다(아래에서 다룸). 안정적인 사실은 Comet이 Chromium 기반이고, 퍼플렉시티 어시스턴트를 통합하며, 브라우징과 질의응답, 선택된 작업을 결합할 수 있다는 것이다.30
4.6. Perplexity Computer
2026년 2월 퍼플렉시티는 답만 돌려주는 대신 다단계 작업을 수행하는 에이전트형 제품 Computer를 내놓았다. 출시 글은 시스템이 결과를 하위 과제로 나누고, 하위 에이전트를 만들고, 격리된 샌드박스 환경에서 브라우저와 파일시스템을 쓰고, 연결된 서비스를 호출하고, 작업을 비동기로 실행할 수 있다고 설명했다. 2026년 7월 도움말 센터는 문서 작성, 코드, 웹 리서치, 지속 메모리, 일정, 외부 애플리케이션 커넥터를 설명했다.31
이 내용은 기능에 대한 제공자 설명이지 신뢰성이나 안전성에 대한 독립 측정이 아니다. 멀티 에이전트 조율은 작업을 병렬화하는 데 도움이 되지만, 실행 경로와 오류가 전파될 기회도 늘린다. 조사, 분석, 문서 작성, 발송을 하는 에이전트는 어느 전환 지점에서든 실패할 수 있다. 따라서 책임 있는 사용에는 사람의 확인 단계를 두고 다음을 포함해야 한다:
- 최소 권한 커넥터 사용
- 외부 발송, 지출, 삭제, 게시 전 확인
- 생성된 파일과 계산 검토
- 출처 자료와 도구 결과를 볼 수 있을 것
- 반복적이거나 장기 실행되는 작업의 경계 설정
- 워크플로를 중지, 취소, 점검할 수 있는 방법 확보
퍼플렉시티 지원 페이지는 Computer가 클라우드 샌드박스에서 실행되며 지속 메모리로 문맥을 유지할 수 있다고 설명한다. 이는 모든 데이터가 사용자 기기에만 남는다는 주장과 다르다.31
4.7. 개발자 플랫폼
퍼플렉시티는 소비자 구독과 별도로 API를 제공한다. 2026년 7월 28일 기준 문서는 세 가지 핵심 인터페이스를 설명한다:
- Agent API: 퍼플렉시티 검색 도구를 쓸 수 있는 모델 응답용 인터페이스
- Search API: 생성된 답 없이 순위가 매겨진 웹 결과를 반환하는 인터페이스
- Embeddings API: 검색과 탐색에 쓰는 텍스트 표현용 인터페이스32
문서에는 레거시 Sonar API도 남아 있다. Sonar 계열은 웹을 근거로 한 생성 답을 제공하고, Agent API는 지원되는 제3자 모델과 도구로 연결할 수 있다. 이 경계와 사용 가능한 모델 목록은 시간이 지나며 바뀌므로, 연동은 백과사전의 모델 표가 아니라 최신 API 문서를 따라야 한다.
요금은 모델 토큰, 검색이나 도구 호출, 요청 수수료, 기타 단위를 조합해 정해질 수 있다. 비용 분석을 날짜와 함께 남기려면 다음을 기록해야 한다:32
- 정확한 엔드포인트와 모델 식별자
- 입력, 출력, 추론, 인용 토큰 규칙
- 검색 문맥 또는 요청 수수료
- 도구 호출 횟수
- 캐싱과 배치 규칙
- 요청 속도 제한 등급
- 실패하거나 빈 요청이 과금되는지 여부
인용이 포함된 API 응답도 검증이 필요하다. 개발자는 출처 주소와 시각을 보존하고, 불확실성을 드러내며, 사용할 수 없는 출처를 처리하고, 모델 출력을 1차 자료처럼 제시하지 않아야 한다.
4.8. 구독과 사업 모델
퍼플렉시티는 소비자와 기업 구독, API 사용으로 수익을 낸다. 조건은 지역, 프로모션, 플랫폼, 날짜에 따라 다르다. 2026년 7월 기준 제공사 페이지에 나온 미국 기본 가격은 다음과 같다:
| 요금제 | 제공사가 밝힌 가격 | 범위 메모 |
|---|---|---|
| Pro | 월 20달러, 연간 요금은 200달러 상당 | 무료 등급보다 검색, 모델, 업로드, 제작 기능이 많음33 |
| Max | 월 200달러 또는 연 2,000달러 | 더 높은 한도와 선택된 기능의 조기 또는 확장 접근34 |
| Enterprise Pro | 활성 좌석당 월 40달러 또는 연 400달러 | 조직 단위 청구와 기업 관리 기능 |
| Enterprise Max | 활성 좌석당 월 325달러 또는 연 3,250달러 | 더 많은 기업 기능과 사용량35 |
Max 가격은 2026년 7월 16일 갱신된 도움말 기사에, 기업용 가격은 2026년 7월 22일 갱신된 기사에 나온다. 월 20달러 Pro 가격은 제공사의 현재 Pro 안내 자료에 나온다. 이 금액은 날짜가 찍힌 스냅샷일 뿐 영구적 속성이 아니다. API 요금은 별도이며, 프로모션이나 앱 마켓 결제는 다를 수 있다.33,34,35
제품 구성에는 여러 수익 경로가 있다:
- 검색과 제작 기능을 위한 개인 구독
- 좌석 단위 조직 구독
- 사용량에 따라 지불하는 개발자 API
- 일부 Computer 작업을 위한 구매 크레딧
- 상업 제휴
이전 문서는 2026년 2월에 광고가 중단되었다고 단정하고 여러 상거래·유통 제휴를 설명했다. 그러나 기준 시점의 상태를 확인해 줄 지속적인 1차 출처가 검토한 자료에 없어 이 주장들은 싣지 않았다. 여기서 빠졌다고 해서 특정 수익 경로가 있거나 없다는 증거가 되지는 않는다.
4.9. 출판사 프로그램과 출처 관계
퍼플렉시티는 2024년 7월 출판사 프로그램을 시작했다. 2024년 12월 업데이트에서 회사는 참여 매체를 이름으로 밝히고, 회원이 광고 기반 수익을 나누고, API와 개발자 지원을 받고, 일정 기간 Enterprise Pro 접근을 얻으며, 콘텐츠 성과 분석을 받는다고 설명했다. 이는 자발적 상업 프로그램에 대한 회사의 설명이며, 다른 출판사가 제기한 법적 쟁점을 정리한 합의가 아니다.36
르몽드(Le Monde)는 2025년 5월 퍼플렉시티와 별도의 다년 계약을 발표했다. 발행사는 자사 콘텐츠를 출처 표시와 함께 질의 답변에 쓰고, 계약에 수익 배분이 포함되며, 콘텐츠는 기반 모델 학습에 쓰지 않는다고 밝혔다. 한 참여 출판사의 조건을 모든 웹 콘텐츠에 일반화해서는 안 된다.37
이 관계는 자주 뒤섞이는 세 가지 메커니즘을 구분해야 한다:
로봇 배제 지시문, 라이선스, 계약, 저작권 예외, 사이트 이용약관은 서로 다른 메커니즘을 다룰 수 있다. 기반 모델을 학습하지 않는다는 진술만으로 검색이나 요약이 허용되는지는 답할 수 없다.
4.10. 크롤링 분쟁
2025년 8월 Cloudflare는 시험 결과를 공개했다. 이 시험에서 선언된 퍼플렉시티 크롤러가 robots.txt와 웹 애플리케이션 방화벽 규칙으로 모두 차단된 뒤에도 퍼플렉시티가 새 도메인에 접근했다고 밝혔다. Cloudflare는 이 요청을 선언되지 않은 사용자 에이전트와 순환하는 네트워크 출처에 귀속하고, 사이트 제한을 피하려는 시도로 규정했다. 이는 Cloudflare의 관찰과 귀속이며 법원의 판단이 아니다.38
퍼플렉시티의 현재 도움말 기사는 현재 동작에 대해 다른 설명을 한다. 2026년 7월 16일 갱신된 이 기사는 PerplexityBot이 robots.txt를 따르고, 차단된 페이지를 직접 주소로 지정해 요약하게 하던 이전 기능이 중단되었으며, 제3자 크롤러와의 계약이 특히 뉴스 사이트에 대한 준수를 요구하도록 갱신되었다고 밝힌다. 같은 기사는 차단된 페이지의 도메인, 헤드라인, 짧은 사실 요약은 여전히 색인될 수 있다고 밝힌다.39
두 출처는 서로 다른 날짜를 다루고 이해관계가 있는 당사자가 작성했다. 정리하면 다음과 같다:
- Cloudflare는 2025년 8월 공개한 시험에서 준수하지 않는 숨은 크롤링 행태를 보고했다.
- 퍼플렉시티는 현재 선언된 크롤러와 제3자 협약이 robots.txt를 따르며, 직접 주소 지정 방식의 이전 동작은 중단되었다고 밝힌다.
- 검토한 자료는 그 변경 이후의 모든 요청을 다루는 독립적이고 지속적인 감사를 제공하지 않는다.
이 틀은 어느 회사의 주장도 모든 크롤링에 대한 최종 사실 판단으로 취급하지 않는다.
4.11. 저작권 및 관련 소송
여러 출판사와 플랫폼 운영자가 퍼플렉시티를 고소했다. 소장은 주장을 담고 있을 뿐 사실 인정이 아니다. 예비 구제 명령은 특정 기준으로 초기 법적 기록을 평가하는 것이며, 책임을 최종적으로 결정하지 않는다.
4.11.1. Dow Jones와 New York Post
Dow Jones와 NYP Holdings는 2024년 10월 21일 뉴욕 남부지방법원에 퍼플렉시티를 상대로 소장을 냈다. 도켓은 이 사건을 저작권과 상표법으로 분류하고, 수정된 소장과 이후의 소송 절차를 기록한다. 원고들은 허가 없는 복제와 자신들의 간행물을 대체하는 사용을 주장했다. 퍼플렉시티는 주장을 부인했다. 사건의 존재와 절차 경과는 도켓으로 확인할 수 있으나, 검토한 기록에서 본안은 최종 해결되지 않았다.40
4.11.2. New York Times, Wirecutter, The Athletic
The New York Times Company, Wirecutter, The Athletic Media Company는 2025년 12월 5일 같은 법원에 퍼플렉시티를 상대로 저작권 소송을 냈다. 소장은 복제, 검색 색인에서의 출판사 콘텐츠 사용, 원고들의 저작물을 대체하는 답변 텍스트의 배포를 주장한다. 이 설명은 인정되거나 판결로 확정되기 전까지 주장으로 남는다.
사건 상태는 도켓 기록에 의존하며, 공개 기록이 확인하는 범위를 넘어 미해결 신청의 내용을 단정하지 않는다.30
4.11.3. Amazon과 에이전트형 쇼핑
Amazon.com Services는 2025년 11월 캘리포니아 북부지방법원에 소를 내며, Comet의 에이전트형 접근이 Amazon 사이트의 비밀번호로 보호된 영역에 닿는다고 주장했다. 2026년 3월 9일 Maxine M. Chesney 판사는 예비 금지명령을 내렸다. 명령은 소송이 해결되거나 법원이 달리 명할 때까지 특정 자동 접근을 금지했고, 그 단계에서 분석한 청구에 대해 Amazon이 승소할 가능성이 있다고 보았다. 퍼플렉시티의 항소 중 집행정지 요청은 기각했지만 7일간의 행정 정지는 허용했다.30
이 명령이 중요한 이유는 사용자의 허락과 사이트 운영자의 승인을 구분했기 때문이다. 그러나 여전히 예비 명령이다. 모든 청구에 대한 최종 판결이 아니며, 그 추론은 해당 법원 앞의 행위, 기록, 계약, 청구 원인에 묶여 있다.
4.11.4. 소송 기록을 읽는 법
중립적인 해석은 네 단계를 구분한다:
| 기록 | 확정하는 것 |
|---|---|
| 소장 | 원고가 특정 주장과 구제를 요청했다는 사실 |
| 답변이나 신청 | 당사자가 특정 항변이나 절차적 주장을 폈다는 사실 |
| 예비 명령 | 법원이 그때까지의 기록에 임시 기준을 적용했다는 사실 |
| 최종 판결과 항소 소진 | 판결 범위에 따라 분쟁이 최종 법적 처분에 이르렀다는 사실 |
위의 어떤 사건도 모든 AI 검색이 합법이거나 불법이라고 확정하지 않는다. 쟁점은 복제된 작품, 분량, 출처 접근, 계약 조건, 변형 여부, 시장 영향, 관할, 구제 방식에 따라 달라질 수 있다.
4.12. 선별 연표
아래 연표는 회사 발표나 법원 도켓으로 뒷받침되는 사건으로 의도적으로 제한했다. 확인되지 않은 자금 조달, 자주 바뀌는 모델 목록, 독립적으로 안정화하지 못한 제품 세부는 뺐다.
| 날짜 | 사건 | 출처 상태 |
|---|---|---|
| 2022년 8월 | 회사 설립 | 회사 계정과 이후 회사 소개17 |
| 2022년 12월 | 첫 공개 답변 제품 출시 | 회사 계정5 |
| 2023년 3월 | 2,560만 달러 규모 시리즈 A 발표 | 회사 자금 조달 발표18 |
| 2024년 1월 | 7,360만 달러 규모 시리즈 B 발표 | 회사 자금 조달 발표19 |
| 2024년 7월 | 출판사 프로그램 시작 | 회사 계정36 |
| 2024년 10월 | Dow Jones와 NYP Holdings 소송 제기 | 연방 도켓40 |
| 2025년 2월 | Deep Research 출시 | 회사 제품 발표27 |
| 2025년 7월 | Comet 출시 | 회사 제품 발표29 |
| 2025년 8월 | Cloudflare가 크롤링 시험과 주장 공개 | Cloudflare 기술 보고서38 |
| 2025년 12월 | New York Times, Wirecutter, The Athletic 소송 제기 | 연방 도켓30 |
| 2026년 2월 | Computer 출시 | 회사 제품 발표31 |
| 2026년 3월 | Amazon 사건에서 예비 금지명령 | 연방 법원 명령30 |
이 연표에 없는 사건이 일어나지 않았다는 뜻은 아니다. 출처 품질 기준에 따른 선별이다.
4.13. 평가와 연구 고려사항
독립적인 답변 엔진 평가는 검색, 인용, 종합, 사용자 결과를 나누어야 한다. 하나의 종단 간 점수는 어느 구성요소가 실패했는지 가릴 수 있다.
검색 평가는 시스템이 질의에 답하는 데 필요한 문서를 찾았는지 묻는다. 관련 있거나 권위 있는 출처의 재현율, 최신성, 언어 범위, 다양성을 잴 수 있다. 공개 웹은 계속 바뀌고 충분한 출처 집합이 여럿일 수 있으므로 정답을 정하기 어렵다.
인용 평가는 인용된 문서가 관련 주장을 뒷받침하는지 묻는다. 유용한 차원은 함의, 완결성, 출처 권위, 정확한 날짜, 배치다. 인용 개수를 세는 것만으로는 부족하다. 답변이 무관한 페이지를 많이 인용하거나 가장 중요한 주장을 뒷받침하지 않은 채 둘 수 있기 때문이다.
종합 평가는 답변이 검색된 증거를 정확히 결합하고, 충돌을 해소하며, 불확실성을 밝히고, 근거 없는 내용을 더하지 않는지 묻는다. 이는 전반적인 문체 선호가 아니라 주장 단위 검토를 요구한다. 과제 평가는 사용자가 의도한 작업을 올바르고 효율적으로 끝냈는지 묻는다. 브라우저나 에이전트라면 행동 정확도, 권한 처리, 되돌리기 가능성, 인터페이스 변경 후 회복을 포함한다.
안전과 개인정보 평가는 프롬프트 인젝션, 악성 웹 콘텐츠, 커넥터로 보낸 데이터, 보존, 사용자 간 격리, 확인 경계, 무단 행동을 살핀다. 검색은 신뢰할 수 없는 웹 페이지가 모델 문맥으로 들어오는 경로를 열기 때문에, 인용된 페이지의 지시가 사용자 의도를 몰래 덮어쓰면 안 된다.
제품 비교에는 고정된 날짜와 구성도 필요하다. 퍼플렉시티는 요금제와 지역에 따라 다른 모델, 검색 깊이, 한도를 노출할 수 있다. 연구는 프롬프트, 원시 출력, 출처 링크, 시각, 계정 등급, 선택한 모드, 반복 시행을 보존해야 한다. 그렇지 않으면 제품 업데이트 뒤 결과를 재현할 수 없다.
4.14. 회사와 지표 구분하기
같은 단어 때문에 반복적으로 생기는 오해가 있다:
- '퍼플렉시티가 좋아졌다'는 모델의 평가 점수가 낮아졌다는 뜻일 수도 있고, 회사가 제품을 바꿨다는 뜻일 수도 있다.
- '퍼플렉시티 검색'은 보통 회사 서비스를 가리키며, 지표를 최소화하는 검색 알고리즘을 뜻하지 않는다.
- '퍼플렉시티 점수'는 모델, 데이터, 단위, 프로토콜이 명시될 때만 확률 지표를 가리킨다.
- 기술 문서에서 회사명을 PPL로 줄이면 지표와 혼동될 수 있으므로 피해야 한다.
- Perplexity AI라는 이름의 리디렉션은 이 통합 문서를 가리키며, 별도의 두 번째 회사 문서를 뜻하지 않는다.
정식 결과에는 토큰 퍼플렉시티, 단어 퍼플렉시티, 유사 퍼플렉시티처럼 적절한 단위를 명시한다. 회사 맥락에서는 '퍼플렉시티' 또는 'Perplexity AI, Inc.'라고 쓴다.
출처 40개
- AI Wiki: Perplexity (2026-08-25 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-14
- A Mathematical Theory of Communication doi.org · 확인 2026-10-14
- Perplexity - A Measure of the Difficulty of Speech Recognition Tasks doi.org · 확인 2026-10-14
- N-gram Language Models web.stanford.edu · 확인 2026-10-14
- What Is Perplexity? (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- How Does Perplexity Work? (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- A Neural Probabilistic Language Model jmlr.org · 확인 2026-10-14
- You Should Evaluate Your Language Model on Marginal Likelihood over Tokenisations aclanthology.org · 확인 2026-10-14
- Perplexity of fixed-length models huggingface.co · 확인 2026-10-14
- Masked Language Model Scoring aclanthology.org · 확인 2026-10-14
- Reading Tea Leaves: How Humans Interpret Topic Models proceedings.neurips.cc · 확인 2026-10-14
- Acoustic Sensitive Language Model Perplexity for Automatic Speech Recognition research.google · 확인 2026-10-14
- GLTR: Statistical Detection and Visualization of Generated Text aclanthology.org · 확인 2026-10-14
- DetectGPT: Zero-Shot Machine-Generated Text Detection Using Probability Curvature proceedings.mlr.press · 확인 2026-10-14
- Can AI-Generated Text Be Reliably Detected? arxiv.org · 확인 2026-10-14
- GPT Detectors Are Biased against Non-Native English Writers doi.org · 확인 2026-10-14
- Perplexity: Company Overview forbes.com · 확인 2026-10-14
- Perplexity Raises Series A Funding Round (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Perplexity Raises Series B Funding Round (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Perplexity Finalizes $20 Billion Valuation Round, The Information Reports (AI Wiki 인용) investing.com · 확인 2026-10-14
- Perplexity ARR Tops $450M after Pricing Shift, FT Reports ca.finance.yahoo.com · 확인 2026-10-14
- Perplexity Received 780 Million Queries Last Month, CEO Says techcrunch.com · 확인 2026-10-14
- Nvidia Discusses Perplexity Investment at $30 Billion-Plus Valuation, Considered Tech Licensing Deal (AI Wiki 인용) theinformation.com · 확인 2026-10-14
- Nvidia Discusses Perplexity Investment at $30 Billion-Plus Valuation, The Information Reports (AI Wiki 인용) investing.com · 확인 2026-10-14
- Why Perplexity Chose Vespa for AI Search vespa.ai · 확인 2026-10-14
- What Is Pro Search? (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Introducing Perplexity Deep Research (AI Wiki 인용) hub-prod.perplexity.ai · 확인 2026-10-14
- Creating Assets with Perplexity: Overview (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Introducing Comet: Browse at the Speed of Thought (AI Wiki 인용) hub-prod.perplexity.ai · 확인 2026-10-14
- The New York Times Company et al. v. Perplexity AI, Inc., No. 1:25-cv-10106 (S.D.N.Y.), docket; Amazon.com Services LLC v. Perplexity AI, Inc., No. 3:25-cv-09514, Document 81 (N.D. Cal. March 9, 2026 (AI Wiki 인용) dockets.justia.com · 확인 2026-10-14
- Introducing Perplexity Computer (AI Wiki 인용) hub-prod.perplexity.ai · 확인 2026-10-14
- Quickstart docs.perplexity.ai · 확인 2026-10-14
- What Is Perplexity Pro? (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Perplexity Max (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Enterprise Pricing and Billing: Frequently Asked Questions (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Perplexity Expands Publisher Program with 15 New Media Partners (AI Wiki 인용) hub-prod.perplexity.ai · 확인 2026-10-14
- Artificial Intelligence: Le Monde Signs Partnership Agreement with Perplexity lemonde.fr · 확인 2026-10-14
- Perplexity Is Using Stealth, Undeclared Crawlers to Evade Website No-Crawl Directives blog.cloudflare.com · 확인 2026-10-14
- How Does Perplexity Follow robots.txt? (AI Wiki 인용) perplexity.ai · 확인 2026-10-14
- Dow Jones & Company, Inc. et al. v. Perplexity AI, Inc., No. 1:24-cv-07984 (S.D.N.Y.), docket (AI Wiki 인용) dockets.justia.com · 확인 2026-10-14
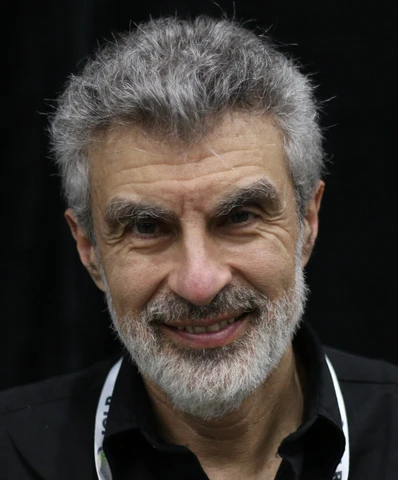 요슈아 벤지오
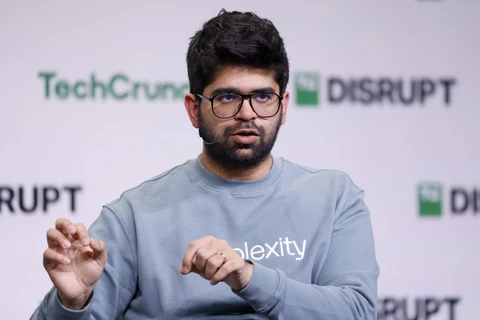 아라빈드 스리니바스