쉽게 말하면, 자기회귀 모델은 문장이나 숫자열처럼 순서가 있는 데이터에서 다음 원소를 앞에 나온 원소들을 보고 맞히는 모델이다. 방금 낸 결과를 다음 예측의 힌트로 다시 넣는 방식이어서, 오늘날 글을 한 토큰씩 써 내려가는 대규모 언어 모델이 이 방식을 쓴다. 대신 한 번에 하나씩만 만들 수 있어서 답이 길수록 시간이 더 걸린다.
| 분류 | 생성형 AI의 핵심 모델링 방식 |
|---|---|
| 핵심 원리 | 앞선 원소들을 조건으로 다음 원소를 순서대로 예측 |
| 최초 도입 | 1927년 조지 유디 율의 시계열 AR 모델2 |
| 대표 사례 | GPT-3(2020년, 1,750억 개 매개변수)3 |
| 주요 한계 | 순차 디코딩으로 인한 지연 시간 |
1. 개요
자기회귀 모델(autoregressive model)은 수열의 각 원소를 그 앞에 있는 원소들로부터 예측하며, 자신이 앞서 낸 출력을 이후 예측의 맥락으로 다시 넣는다. 이 용어는 1920년대부터 통계학자들이 시계열에 맞춰 온 선형 AR(p) 모델과, 오늘날 생성형 AI의 중심에 있는 신경망 수열 모델을 함께 가리킨다. GPT 계열과 대부분의 대규모 언어 모델(LLM)은 이 다음 토큰 예측 과제로 학습된다.
이 방식의 가장 뚜렷한 약점은 엄격하게 순차적인 디코딩이다. 2025년 초부터는 병렬 생성을 내세운 도전자들이 자리를 넓혀 왔고, 그중 가장 눈에 띄는 것이 Mercury와 Gemini Diffusion 같은 텍스트 확산 모델이다.
지금까지 가장 영향이 큰 자기회귀 모델은 GPT-3다. 2020년 논문은 GPT-3를 매개변수 1,750억 개의 자기회귀 언어 모델로 소개하며, 이전의 어떤 비희소 언어 모델보다 10배 많다고 밝혔다. 다음 토큰만 맞히도록 학습한 네트워크가 몇 가지 예시만으로 문맥 속에서 배우는 퓨샷 학습 능력을 보인다는 이 확장 결과가, 오늘날 OpenAI, Anthropic, Google의 주력 어시스턴트가 다음 토큰 예측을 기반으로 삼는 이유다.3
2. 생성 방식과 장단점
생성은 조상 샘플링(ancestral sampling)으로 진행된다. 첫 원소를 뽑고, 그것을 다시 입력해 두 번째 원소를 뽑고, 문장 끝 토큰이나 길이 제한에 닿을 때까지 이어 간다. 확률의 연쇄 법칙에 따르면 수열 전체의 결합 분포는 항상 단계별 조건부 확률의 곱으로 쓸 수 있으므로, 이 분해 자체는 일반성을 잃지 않는다. 모델마다 다른 것은 원소를 생성하는 순서와 각 조건부 확률을 계산하는 함수다. 고전적인 AR(p) 과정은 최근 p개 값에 대한 고정된 선형 함수를 쓰고, 디코더 전용 트랜스포머는 컨텍스트 창 안의 모든 내용에 깊은 신경망을 적용한다.
생성형 AI에서 이 방식이 지배적인 이유는 세 가지 성질로 설명된다. 첫째, 학습은 라벨 없는 데이터의 모든 위치에서 다음 원소를 맞히는 평범한 지도 예측이어서 주석 없이도 인터넷 규모의 말뭉치로 확장할 수 있다. 둘째, 모델은 어떤 수열에도 정확한 우도(likelihood)를 부여한다. 생성적 적대 신경망(GAN)과 달리, 이 덕분에 퍼플렉시티로 깔끔하게 평가할 수 있다. 셋째, 학습을 마친 하나의 네트워크가 임의 길이의 출력을 낼 수 있다. 대가는 t번째 원소를 뽑으려면 t-1번째 원소가 먼저 있어야 한다는 점이다.
3. 정의와 수식
자기회귀 모델은 수열의 결합 확률을 단계별로 분해하며, 각 항은 그보다 앞선 원소에만 조건을 건다.
p(x_1, ..., x_T) = p(x_1) p(x_2 | x_1) p(x_3 | x_1, x_2) ... p(x_T | x_1, ..., x_{T-1})고전적인 AR(p) 모델은 시계열 분석에서 각 단계를 최근 p개 값의 선형 함수와 잡음의 합으로 둔다.
X_t = c + phi_1 X_{t-1} + phi_2 X_{t-2} + ... + phi_p X_{t-p} + e_t여기서 phi 계수는 데이터로부터 추정하며, 예를 들어 Yule-Walker 방정식을 쓴다. e_t는 평균이 0인 백색 잡음이다. 정상성을 위해서는 특성 다항식의 근이 단위원 바깥에 있어야 한다.
신경망 자기회귀 모델도 분해 방식은 같지만, 각 조건부 확률을 다음 원소에 대한 전체 분포를 출력하는 신경망으로 계산하며, 보통 이산 어휘 위의 소프트맥스를 쓴다. 다음 토큰의 교차 엔트로피를 최소화하는 것은 곧 최대 우도 학습이다. AR(p)가 p차 마르코프 과정인 반면, 트랜스포머는 전체 컨텍스트 창에 조건을 건다. 이 컨텍스트 창은 2026년 기준 최전선 모델에서 수십만 토큰에 이를 수 있다.
4. 연혁
자기회귀 분석은 조지 유디 율(George Udny Yule)이 1927년 태양 흑점 수의 준주기적 움직임을 설명하려고 도입했다. 그는 관측값을 규칙적인 주기가 아니라 과거 관측값의 선형 함수에 무작위 충격을 더한 것으로 모델링했다. 길버트 워커(Gilbert Walker)는 1930년대에 이 틀을 확장했고, 1970년 Box-Jenkins 방법론은 AR 모델과 ARIMA 모델을 경제와 산업 예측의 기본 도구로 자리 잡게 했다.2,4
신경망 계보는 2003년 요슈아 벤지오(Yoshua Bengio) 등이 낸 신경 확률적 언어 모델에서 시작되었다. 이 모델은 앞선 단어들의 학습된 임베딩으로 다음 단어를 예측하는 순방향 신경망이었다. Larochelle과 Murray의 NADE(2011)는 이 발상을 언어 밖으로 넓혔다. 가중치를 공유한 신경 조건부 사슬로 고차원 이진 데이터의 분포를 추정했다.5,6
2016년 Google DeepMind는 이 접근법이 여러 양식에 걸쳐 쓰일 수 있음을 보였다. PixelRNN과 PixelCNN은 이미지를 픽셀 단위로 생성했고 ICML 2016 최우수 논문상을 받았다. WaveNet은 확장(dilated) 인과 합성곱으로 원시 오디오를 샘플 하나씩 합성했다.7,8
2017년 트랜스포머는 주요 학습 병목을 없앴다. 인과적 셀프 어텐션이 학습 시퀀스의 모든 위치를 병렬로 예측하게 해 주었다. OpenAI의 GPT(GPT-1, 2018년 6월)는 디코더 전용 생성 사전 학습을 확립했다. 12층 디코더 전용 트랜스포머를 BookCorpus로 학습해 왼쪽 문맥으로부터 다음 토큰을 예측하게 했다.9,10
GPT-2(2019년)와 GPT-3(2020년)는 규모가 커지면 다음 토큰 예측이 퓨샷 문맥 학습이 된다는 것을 보였으며, 그중 GPT-3는 매개변수가 1,750억 개였다. ChatGPT(2022년 11월)는 이 패러다임을 대중에게 전했다. 자기회귀는 비전 분야로도 다시 확장되었다. 다음 스케일 예측으로 이미지를 생성하는 시각 자기회귀 모델링(VAR)은 NeurIPS 2024 최우수 논문상을 받았다.3,11
| 연도 | 사건 | 내용 |
|---|---|---|
| 1927년 | 조지 유디 율, 자기회귀 분석 도입 | 태양 흑점 수 설명에 과거 관측값의 선형 함수 사용2 |
| 1930년대 | 길버트 워커, 틀 확장 | AR 틀을 확장 |
| 1970년 | Box-Jenkins 방법론 | AR과 ARIMA 모델이 경제와 산업 예측의 기본 도구가 됨4 |
| 2003년 | 신경 확률적 언어 모델 | 앞선 단어의 임베딩으로 다음 단어 예측5 |
| 2011년 | NADE | 고차원 이진 데이터 분포를 신경 조건부 사슬로 추정6 |
| 2016년 | PixelRNN, PixelCNN, WaveNet | 이미지 픽셀 단위 생성, 원시 오디오 샘플 단위 합성7,8 |
| 2017년 | 트랜스포머 | 인과적 셀프 어텐션으로 위치 병렬 예측9 |
| 2018년 6월 | GPT-1 | 12층 디코더 전용 트랜스포머를 BookCorpus로 학습10 |
| 2019년 | GPT-2 | 규모 확장에 따른 퓨샷 문맥 학습 |
| 2020년 | GPT-3 | 1,750억 개 매개변수3 |
| 2022년 11월 | ChatGPT | 대중 사용자층으로 확산 |
| 2024년 | VAR | 다음 스케일 예측 이미지 생성, NeurIPS 2024 최우수 논문상11 |
5. 작동 원리
현대 LLM은 인과적 어텐션 마스크를 쓰는 디코더 전용 트랜스포머다. 위치 t는 1번부터 t번까지만 참조하고 그 뒤쪽은 볼 수 없다. 따라서 학습 중에는 수열의 모든 다음 토큰을 동시에 예측하되, 각 예측은 모델 자신의 출력이 아니라 실제 정답 접두사를 조건으로 한다. 이를 순환 신경망 문헌에서는 교사 강요(teacher forcing)라고 부른다.12
손실은 평균 다음 토큰 교차 엔트로피이며, 매개변수 수, 데이터 양, 연산량에 대해 매끄러운 거듭제곱 법칙을 따라 줄어든다. 이것이 LLM 스케일링 법칙의 경험적 기반이다.13
텍스트는 먼저 바이트 페어 인코딩 같은 토크나이저로 하위 단어 단위로 나뉜다. 그래서 '다음 토큰'은 다음 글자나 다음 단어가 아니라 다음 하위 단어를 뜻한다.
지시 튜닝과 RLHF 같은 사후 학습 단계는 모델이 어떤 이어 쓰기를 선호할지를 바꾸지만, 자기회귀 구조 자체는 건드리지 않는다. 채팅 어시스턴트도 여전히 프롬프트와 지금까지 생성한 모든 내용을 조건으로 답변을 한 토큰씩 낸다.
6. 샘플링과 추론 최적화
각 단계에서 네트워크는 다음 토큰에 대한 확률 분포를 정의하고, 디코딩 알고리즘이 그 분포를 어떻게 쓸지 정한다. 그리디 디코딩은 가장 확률이 높은 토큰을 고르고, 빔 서치는 확률이 높은 접두사 여러 개를 함께 추적한다. 그러나 우도를 최대화하는 디코딩은 열린 생성에서 반복적이고 퇴화된 텍스트를 만든다고 알려져 있다.14
그래서 실제 시스템은 샘플링을 쓴다. 온도 조정은 소프트맥스 전에 로짓을 상수로 나누어, 1보다 작으면 분포를 날카롭게, 1보다 크면 평평하게 만든다. top-k 샘플링은 확률이 가장 높은 k개 토큰으로 선택지를 제한한다. 뉴클리어스(top-p) 샘플링은 누적 확률이 p를 넘는 가장 작은 집합으로 제한한다. 반복 페널티와 빈도 페널티는 그 위에 얹는 흔한 휴리스틱이고, 제약 디코딩은 목표 문법이나 JSON 스키마를 어기는 토큰을 가린다.14,15
두 가지 시스템 기법이 현대 자기회귀 추론을 정의한다. KV 캐시는 과거 위치마다 모든 층의 어텐션 키와 값을 저장해, 새 토큰마다 접두사 전체를 다시 읽는 대신 증분 순전파 한 번만 하면 되게 한다. 그 대가로 메모리가 문맥 길이에 따라 늘어난다. 추측 디코딩은 순차 병목을 직접 공략한다. 작은 초안 모델(또는 보조 초안 헤드)이 토큰 여러 개를 미리 제안하면, 큰 모델이 이를 한 번의 병렬 순전파로 검증해 수락하거나 기각한다. 출력 분포가 바뀌지 않음이 증명되어 있으며, 보고된 속도 향상은 대략 2~3배다.16,17
7. 한계
가장 큰 한계는 지연 시간이다. T개 토큰짜리 답에는 T번의 순차적 네트워크 평가가 필요하고, 디코딩은 보통 연산보다 메모리 대역폭에 묶여 있어서 가속기가 일부 놀게 된다. 긴 사고의 연쇄 추론 과정은 이 비용을 더 눈에 띄게 만든다.
둘째는 노출 편향(exposure bias)이다. 교사 강요로 생긴 학습과 추론 사이의 불일치다. 학습 때는 정답 접두사만 보았는데, 추론 때는 자신의 샘플을 조건으로 쓰므로 초기 실수가 분포 밖으로 생성을 끌고 가 누적될 수 있다. 예정 샘플링(scheduled sampling)이 초기의 해결책이었고, Ranzato 등은 이 문제에 이름을 붙이고 분석했다. 큰 최신 모델은 이 문제에 꽤 견고하지만, 매우 긴 출력에서는 오류 누적이 여전히 현실적인 문제로 남아 있다.18,19
셋째, 왼쪽에서 오른쪽으로 가는 순서는 그 자체로 모델링 선택이다. 텍스트와 오디오에는 자연스럽지만 이미지와 표에는 임의적이다.
8. 대안 연구 흐름
이 방식을 완화하려는 연구도 있다. BERT 계열의 마스크 언어 모델은 무작위로 가려진 토큰을 복원하며 양방향으로 학습한다. 이해 과제에서는 강력한 인코더가 되지만, 자유 형식 텍스트를 위한 다루기 쉬운 생성 과정을 정의하지는 않는다. XLNet은 인수분해 순서의 무작위 순열에 걸쳐 자기회귀를 수행했다. 비자기회귀 기계 번역은 모든 출력 위치를 병렬로 생성하고, 반복 정제로 품질을 되찾았다.20,21,22
9. 확산 모델과의 경쟁
현재 가장 강한 도전자는 확산 모델이다. 텍스트용 이산 확산은 D3PM(2021)과 Diffusion-LM(2022)에서 발전했고, 2025년에 규모를 갖추었다.23,24
중국인민대학교(Renmin University of China)와 앤트그룹(Ant Group) 연구진은 처음부터 학습한 80억 개 매개변수의 마스크 확산 모델 LLaDA를 2조 3천억 토큰으로 학습시켰다. LLaDA는 Llama 3 8B와 비슷한 성능을 냈고, 왼쪽에서 오른쪽으로 가는 순서에서 벗어나 자기회귀 LLM을 괴롭히는 역방향 저주(reversal curse)를 완화했다.25
스탠퍼드대 교수 스테파노 에르몬(Stefano Ermon)이 공동 창업한 Inception Labs는 2025년 2월 Mercury를 상업 규모의 첫 확산 LLM으로 출시했다. 독립 측정 기관 Artificial Analysis의 측정에서 NVIDIA H100 GPU 기준 초당 토큰 수는 Mercury Coder Mini가 1,109, Mercury Coder Small이 737이었다.26
Google DeepMind는 2025년 5월 Google I/O에서 실험적 텍스트 모델 Gemini Diffusion을 시연했다. 초당 1,000~2,000 토큰이라고 보고되었다.27
Dream과 바이트댄스의 Seed Diffusion 같은 개방형 및 산업계 후속 모델도 같은 속도 이점을 노린다. 블록 확산 하이브리드는 블록 단위로 자기회귀 생성을 하고, 각 블록 안에서는 병렬로 노이즈를 제거한다.28,29
10. 패러다임 비교
| 방식 | 학습 신호 | 생성 방식 | 대표 모델 |
|---|---|---|---|
| 자기회귀 | 인과 마스킹을 쓴 다음 토큰 예측 | 순차적, 단계당 토큰 하나 | GPT-4, Claude, Llama, WaveNet |
| 마스크 언어 모델 | 무작위로 가린 토큰 복원 | 본래 생성용이 아니며 임베딩과 분류에 사용 | BERT, RoBERTa |
| 이산 확산 | 전체 수열을 반복적으로 복원하거나 노이즈 제거 | 고정된 단계 수의 병렬 정제 | LLaDA, Mercury, Gemini Diffusion, Seed Diffusion |
| 비자기회귀·임의 순서 | 순열, 삽입, 정제 목적 | 병렬 또는 유연한 순서 | XLNet, 비자기회귀 번역 모델 |
11. 현황
2026년 6월 기준 OpenAI, Anthropic, Google의 주력 어시스턴트는 여전히 자기회귀 방식이다. 추측 디코딩과 기타 추론 최적화가 속도 격차를 좁히고 있으며, 같은 규모에서 패러다임을 통제해 비교하는 연구는 여전히 활발한 주제다.28
출처 29개
- AI Wiki: Autoregressive Model (2026-06-22 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-22
- Yule, G. U. (1927). "On a Method of Investigating Periodicities in Disturbed Series, with Special Reference to Wolfer's Sunspot Numbers". Philosophical Transactions of the Royal Society of London, Series A, 226: 267-298. (AI Wiki 참고문헌) aiwiki.ai · 확인 2026-10-22
- Language Models are Few-Shot Learners arxiv.org · 확인 2026-10-22
- Box, G. E. P.; Jenkins, G. M. (1970). Time Series Analysis: Forecasting and Control. Holden-Day. (AI Wiki 참고문헌) aiwiki.ai · 확인 2026-10-22
- A Neural Probabilistic Language Model jmlr.org · 확인 2026-10-22
- The Neural Autoregressive Distribution Estimator proceedings.mlr.press · 확인 2026-10-22
- Pixel Recurrent Neural Networks arxiv.org · 확인 2026-10-22
- WaveNet: A Generative Model for Raw Audio arxiv.org · 확인 2026-10-22
- Attention Is All You Need arxiv.org · 확인 2026-10-22
- Improving Language Understanding by Generative Pre-Training cdn.openai.com · 확인 2026-10-22
- Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction arxiv.org · 확인 2026-10-22
- Williams, R. J.; Zipser, D. (1989). "A Learning Algorithm for Continually Running Fully Recurrent Neural Networks". Neural Computation 1(2): 270-280. (AI Wiki 참고문헌) aiwiki.ai · 확인 2026-10-22
- Scaling Laws for Neural Language Models arxiv.org · 확인 2026-10-22
- The Curious Case of Neural Text Degeneration arxiv.org · 확인 2026-10-22
- Hierarchical Neural Story Generation arxiv.org · 확인 2026-10-22
- Fast Inference from Transformers via Speculative Decoding arxiv.org · 확인 2026-10-22
- Accelerating Large Language Model Decoding with Speculative Sampling arxiv.org · 확인 2026-10-22
- Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks arxiv.org · 확인 2026-10-22
- Sequence Level Training with Recurrent Neural Networks arxiv.org · 확인 2026-10-22
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding arxiv.org · 확인 2026-10-22
- XLNet: Generalized Autoregressive Pretraining for Language Understanding arxiv.org · 확인 2026-10-22
- Non-Autoregressive Neural Machine Translation arxiv.org · 확인 2026-10-22
- Structured Denoising Diffusion Models in Discrete State-Spaces arxiv.org · 확인 2026-10-22
- Diffusion-LM Improves Controllable Text Generation arxiv.org · 확인 2026-10-22
- Large Language Diffusion Models arxiv.org · 확인 2026-10-22
- Mercury: Ultra-Fast Language Models Based on Diffusion arxiv.org · 확인 2026-10-22
- Gemini Diffusion deepmind.google · 확인 2026-10-22
- A Survey on Diffusion Language Models arxiv.org · 확인 2026-10-22
- Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models arxiv.org · 확인 2026-10-22
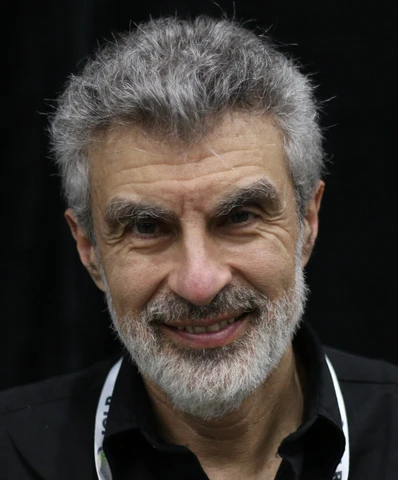 요슈아 벤지오