쉽게 말하면, 전문가 혼합(MoE)은 여러 개의 전문가 네트워크를 두고 입력이 들어올 때마다 라우터가 그중 일부만 골라 계산에 쓰는 구조다. 전문가를 늘려도 모든 전문가가 모든 입력에서 실행되지는 않으므로, 전체 매개변수는 키우면서 한 번에 실행되는 부분은 작게 유지할 수 있다. 원래 방식에서는 여러 전문가의 출력을 연속적인 가중치로 섞었지만, 최근의 희소 MoE 시스템에서는 토큰마다 소수의 전문가만 고르는 경우가 많다.
| 분류 | 머신러닝 구조 |
|---|---|
| 구성 요소 | 여러 개의 전문가(expert) 네트워크와 게이팅 또는 라우팅 메커니즘2,3,4 |
| 최초 제안 | 1991년 적응형 국소 전문가 혼합2 |
| 대규모 희소 MoE | 2017년 희소 게이트 MoE 계층 제시4 |
| 대표 설계 | GShard(top-2 토큰 라우팅), Switch Transformer(토큰당 전문가 1개 선택)5,6 |
| 핵심 구분 | 전체 매개변수와 토큰 하나가 쓰는 활성 매개변수의 분리6,7,8 |
1. 개요
전문가 혼합(Mixture of Experts, MoE)은 전문가라고 불리는 여러 구성 함수와, 각 전문가의 출력이 최종 결과에 얼마나 기여할지 정하는 게이팅 또는 라우팅 메커니즘으로 이루어진 머신러닝 구조다. 원래의 정식화에서는 게이트가 여러 국소 전문가 네트워크에 연속적인 가중치를 부여했다. 최근 많은 희소 MoE 시스템에서는 라우터가 입력이나 토큰마다 전문가의 작은 부분집합만 고른다.2,3,4
희소 활성화(sparse activation)는 일반적인 밀집 계층에서 똑같은 두 양을 분리한다. 하나는 계층에 저장된 매개변수 전체이고, 다른 하나는 입력 하나를 처리할 때 쓰는 매개변수다. 그래서 전문가를 추가하면 모든 전문가가 모든 토큰에서 실행되지 않아도 매개변수 용량을 늘릴 수 있다. 다만 이것이 계산량이나 메모리 사용량을 일정하게 만드는 것은 아니다. 공유 계층, 라우터, 선택된 전문가, 데이터 이동, 출력 결합에는 여전히 비용이 들고, 모든 전문가 가중치는 어떤 방식으로든 저장·분할·압축되거나 적재되어야 한다.6,7,8
전문가는 보통 하나의 신경망 안에 있는 학습 가능한 하위 네트워크이며, 따로 배포되는 독립 모델이 아니다. 현대 언어 모델 구현은 트랜스포머의 일부 블록에서 독립적인 피드포워드 네트워크를 전문가로 쓰는 경우가 많고, 어텐션과 다른 부분은 밀집 구조로 둔다. MoE가 트랜스포머, 언어 모델, 희소 라우팅에만 한정되는 것은 아니다. 학습된 전문가가 사람이 읽을 수 있는 주제와 대응한다는 보장도 없다.4,9
2. 핵심 구조
입력 표현을 x, 전문가 i의 출력을 E_i(x)라고 하자. 라우터는 N개의 전문가 각각에 대해 점수 s_i(x)를 만든다. 흔한 토큰 선택 구현은 이 점수를 확률로 바꾸고, 점수가 가장 높은 k개 전문가의 집합 S_k(x)를 고른 뒤 그 출력을 결합한다. 이를 식으로 나타내면 아래와 같다.
y(x)=\sum_{i\in S_k(x)} \alpha_i(x)E_i(x).계수 α_i(x)는 라우터 점수에서 도출된다. 선택 전에 전체 전문가에 걸쳐 정규화할 수도 있고, 선택된 전문가 사이에서 다시 정규화할 수도 있으며, 구현에 따라 다른 방식으로 처리할 수도 있다. 희소 선택은 그 토큰에 대해 선택된 전문가 함수만 실행한다는 뜻이다. 다만 주변 모델에 포함된 밀집 어텐션, 정규화, 잔차 경로, 임베딩 등 공유 구성 요소는 여전히 실행된다.
일반적인 언어 모델 MoE 블록에서 라우터는 토큰 표현마다 작동하며, 하나 이상의 밀집 피드포워드 하위 계층을 전문가 피드포워드 네트워크 묶음으로 바꿔 넣는다. GShard는 다국어 기계 번역용 트랜스포머에서 일종의 top-2 토큰 라우팅을 썼고, Switch Transformer는 이 설계를 토큰마다 전문가 하나만 고르도록 단순화했다. 두 설계는 영향력이 컸지만, MoE의 정의 자체는 아니다.5,6
매개변수 수는 세 가지로 구분해야 한다.
- 전체 매개변수는 모든 전문가와 공유 구성 요소를 포함한다.
- 토큰 하나의 활성 매개변수는 선택된 전문가와 그 토큰이 쓰는 공유 구성 요소를 포함한다.
- 배치나 시퀀스가 건드리는 매개변수는 그 안의 모든 토큰이 활성화한 매개변수의 합집합이다. 개별 토큰이 소수의 전문가만 써도 이 값은 전체 모델 크기에 가까워질 수 있다.8
계산량에도 같은 구분이 적용된다. 희소 전문가 활성화는 모든 전문가를 계산하는 경우에 비해 전문가 연산량을 줄일 수 있다. 하지만 토큰당 부동소수점 연산에는 모델의 밀집 부분도 포함된다. 분산 규모에서는 라우터와 통신 작업이 무시하기 어려운 비중을 차지할 수 있다.6,10,11
3. 연혁
로버트 제이콥스(Robert Jacobs), 마이클 조던(Michael Jordan), 스티븐 노윌런(Steven Nowlan), 제프리 힌턴(Geoffrey Hinton)은 1991년 적응형 국소 전문가 혼합(adaptive mixtures of local experts)을 제안했다. 이들의 지도 학습 절차는 여러 네트워크를 사례의 서로 다른 부분집합으로 학습시키고, 게이팅 네트워크로 입력에 따른 혼합 가중치를 할당했다. 1994년 마이클 조던과 로버트 제이콥스는 이 아이디어를 계층적 혼합으로 확장했다. 게이팅과 전문가 구성 요소를 트리로 배열하고, 기댓값 최대화(expectation-maximization) 절차로 학습시켰다.2,3
현대의 대규모 희소 MoE 계열은 조건부 계산에서 발전했다. 2017년 노엄 샤지어(Noam Shazeer) 등 연구진은 많은 피드포워드 전문가와, 예제마다 희소한 조합을 고르는 학습 가능한 게이트를 가진 희소 게이트 MoE 계층을 제시했다. 이들은 언어 모델링과 번역 실험에서 MoE 계층을 순환 계층 사이에 배치했고, 이 아이디어가 트랜스포머 구조에 의존하지 않는다는 점을 보였다.4
GShard는 이후 희소 MoE 계층, top-2 라우팅, 자동 샤딩을 결합해 다국어 번역용 트랜스포머를 학습했다. Switch Transformer는 top-1 라우팅, 전문가 용량, 부하 균형 손실, 선택적 라우터 정밀도, 데이터, 모델, 전문가 병렬의 조합을 연구했다. 이후 연구는 하나의 표준 방식을 정하기보다 설계 공간을 넓혔다. 균형 할당, 전문가 선택 라우팅, 소프트 라우팅, 드롭리스 희소 커널, 세분화된 전문가, 공유 전문가, 연속 희소 라우터는 각각 서로 다른 최적화나 시스템 제약을 다룬다.5,6,12,13,14,15,16,17,18
4. 라우팅 방식
4.1. 토큰 선택 라우팅
토큰 선택 라우팅에서는 각 토큰이 독립적으로 점수가 가장 높은 k개 전문가를 고른다. top-1 라우팅은 전문가 계산량과 라우팅 분기 수(fan-out)를 최소화한다. top-2 이상은 더 많은 전문가를 평가하고 그 출력을 결합한다. k를 늘리면 계산량과 통신이 모두 바뀌므로, k 값이 다른 모델은 전체 매개변수 수만으로 직접 비교할 수 없다.5,6
top-k 연산은 이산적이고 불연속적이다. 선택된 전문가와 선택 경로의 라우터 확률은 그래디언트를 받을 수 있지만, 선택 경계 자체는 일반적인 미분 가능한 사상이 아니다. 그래서 학습은 구현이 쓰는 특정 게이팅 공식, 보조 목적함수, 라우팅 잡음 또는 다른 추정기에 의존한다.4,5,18
4.2. 균형 및 전문가 선택 라우팅
토큰 선택 라우팅은 전문가 부하가 같다고 보장하지 않는다. BASE Layers는 할당을 균형 선형 할당 문제로 설정해, 연구된 학습 환경에서 각 전문가가 같은 수의 토큰을 받도록 했다. 전문가 선택 라우팅(Expert Choice Routing)은 기존의 일반적 방향을 뒤집었다. 각 전문가가 점수가 높은 토큰을 고정 크기 묶음으로 고르고, 이에 따라 토큰이 쓰는 전문가 수가 달라질 수 있다.12,13
이런 방법은 균형을 할당의 일부로 만들지만, 적용 범위가 중요하다. 배치 전체에서 계산한 할당은 한 토큰의 경로를 같은 배치의 다른 토큰에 의존하게 만든다. 자기회귀 대규모 언어 모델에서는 단순한 전역 전문가 선택 할당이 뒤쪽 토큰이 앞쪽 토큰의 할당에 영향을 줄 수도 있다. 따라서 인과적 구현은 이 계산을 제한하거나 수정해야 한다. 균형 할당은 토큰 단위 라우팅을 대신할 수 있는 만능 대체재가 아니다.19
4.3. 소프트 및 연속 라우팅
소프트 MoE(Soft MoE)는 전문가마다 고정된 수의 가중 입력 슬롯을 만든 뒤, 전문가 출력을 다시 토큰 표현으로 결합한다. 완전히 미분 가능하고 토큰을 강제로 버리는 일을 피하지만, 수행하는 계산 자체를 바꾸며 주로 비전 설정에서 평가되었다. ReMoE는 top-k 선택과 소프트맥스 대신 ReLU 기반 희소 라우팅을 쓰는 다른 연속형 접근이다. 두 방법의 결과는 시험한 모델과 작업 부하에 대한 근거이지, 연속 라우팅이 언제나 더 낫다는 증거는 아니다.15,18
라우팅은 정적일 수도, 해시 기반일 수도, 작업 조건부일 수도, 계층형일 수도 있다. MoE라는 용어는 특정 라우팅 알고리즘이 아니라 게이트가 있는 전문가를 쓰는 방식 전체를 가리킨다.
5. 부하 균형과 전문가 용량
너무 많은 토큰이 같은 전문가를 고르면, 그 전문가가 메모리나 지연 시간의 병목이 되고 다른 전문가는 거의 쓰이지 않은 채 남을 수 있다. 지속적인 불균형은 일부 전문가가 상대적으로 적은 학습 예제만 보게 만들 수도 있다. 따라서 부하 균형은 최적화 문제이자 시스템 활용도 문제다.5,6,13
많은 분산 구현은 전문가마다 고정된 토큰 버퍼를 할당한다. 라우팅 그룹에 토큰 T개, 전문가 N개, 토큰당 선택 전문가 k개, 용량 계수(capacity factor) c가 있을 때 유용한 일반 근사식은 아래와 같다.
C=\left\lceil c\frac{Tk}{N}\right\rceil .Switch 방식의 top-1 라우팅에서는 이 식이 C = ⌈cT/N⌉로 줄어든다. 정확한 반올림, 최소 용량, 라우팅 그룹의 경계, 두 번째 선택 할당을 같은 방식으로 세는지는 구현마다 다르다. 따라서 이 식은 보편적인 API 정의가 아니라 평균 할당 예산으로 읽어야 한다.5,6
용량 계수를 키우면 불균형한 경로를 더 많이 수용할 수 있지만, 메모리, 통신량, 패딩된 계산이 늘어날 수 있다. 용량이 작으면 넘침(overflow)이 생길 수 있다. 설계에 따라 넘친 할당은 잔차 경로로 건너뛰거나, 다른 전문가로 돌리거나, 가변 크기 또는 드롭리스 커널로 처리한다.5,6,14
흔한 부하 균형 기법으로 다음이 있다.
- 전문가별 평균 라우터 확률과 실제 토큰 비율을 더 고르게 만드는 보조 손실
- 균형 할당 또는 고정 크기 전문가 버킷
- 균형 손실을 역전파하지 않고 최근 부하로 갱신하는 라우터 점수 편향
- 전문가 복제나 적응형 배치 같은 시스템 측 조치.
보조 손실은 가중치를 지나치게 세게 주면 주 학습 목표와 경쟁할 수 있는 두 번째 목표가 된다. Lean Wang 등 연구진이 보고한 보조 손실 없는 편향 방식은 이런 균형 그래디언트를 피하지만, 발표된 근거는 연구된 모델, 데이터, 학습 규모에 한정된다. MegaBlocks는 문제의 다른 부분을 다뤘다. 블록 희소 연산으로 가변적인 전문가 부하를 처리하면서, 토큰을 버리지 않고 모든 전문가를 최대 부하에 맞춰 패딩하지도 않았다.14,19
라우터 안정성은 부하 균형과 관련이 있지만 별개의 문제다. ST-MoE 연구는 라우터 로짓이 클 때와 연관된 학습 불안정성을 확인했고, 시험한 설정에서 로짓을 작게 유지하기 위해 라우터 z-loss를 도입했다. z-loss 자체가 전문가 사용의 균형을 보장하지는 않는다.9
6. 분산 실행
희소 MoE는 전문가를 서로 다른 가속기에 나눠 두는 순간 분산 시스템 문제가 된다. 전문가 병렬화(expert parallelism)는 서로 다른 전문가나 전문가의 복제본을 서로 다른 장치에 배정한다. 일반적인 순전파는 네 단계로 이뤄진다.
- 라우터 점수와 할당을 계산한다.
- 토큰 표현을 묶어 선택된 전문가를 가진 장치로 보낸다.
- 받은 토큰에 대해 각 전문가를 평가한다.
- 전문가 출력을 원래 토큰 순서로 되돌려 결합한다.
전송과 반환 단계는 보통 두 번의 all-to-all 집합 통신으로 구현된다. 이 비용은 상호연결 토폴로지, 메시지 크기, 참여 장치 수, 토큰 분포, 정밀도, 통신을 전문가 계산과 겹칠 수 있는지 여부에 따라 달라진다. Tutel은 최적의 병렬 구성과 파이프라이닝 전략이 작업 부하와 규모에 따라 바뀐다는 것을 보였고, COMET은 더 세밀한 통신-계산 중첩으로 이 흐름을 이어갔다. 이들이 측정한 속도 향상은 각자의 실험 시스템에서 나온 결과이지, MoE의 고정된 특성이 아니다.6,10,11
전문가 병렬화는 다른 형태의 분산 학습을 대체하지 않고 보완한다. 데이터 병렬화는 예제를 나누고, 텐서 병렬은 층 안의 연산을 나누며, 파이프라인 병렬화는 층의 묶음을 나눈다. 모델 병렬화는 이들 가운데 여럿을 포함할 수 있는 더 넓은 범주다. 실제 배포에서 이들을 함께 쓰면 메모리 배치와 집합 통신 패턴이 달라진다.6,10
모델 수준의 부하 균형이 벽시계 실행 시간의 균형까지 보장하지는 않는다. 시퀀스 묶음, 토큰 형상, 커널 효율, 복제본, 장치 배치가 다르면 전문가의 토큰 수가 같아도 실제 비용은 다를 수 있다. 반대로 인기 있는 전문가를 복제하거나 더 빠른 링크에 두면 일부 불균형은 허용될 수 있다. 중요한 목표는 의도한 작업 부하에서의 종단 간(end-to-end) 시간과 자원 사용량이다.
7. 학습 동작
희소 라우팅은 어떤 매개변수가 갱신되는지를 바꾼다. 한 번의 학습 스텝에서 각 전문가는 자기에게 라우팅된 토큰으로만 학습된다. 초기 라우팅이 소수의 전문가에 강하게 쏠리면, 양의 피드백으로 일부 전문가만 과부하되고 다른 전문가는 제대로 학습되지 않을 수 있다. 균형 목적함수, 용량 정책, 라우터 초기화, 라우팅 잡음, 전문가 할당 방법, 수치 정밀도는 문헌에서 연구된 제어 수단이다.4,5,6,9
전문가 특화는 나타날 수 있지만 가정하기보다 측정해야 한다. 2017년 희소 게이트 연구는 일부 언어 전문가에서 구문과 의미 패턴을 발견했다. ST-MoE는 이후 일부 인코더 전문가에서 뚜렷한 특화가 보였고, 디코더 전문가에서는 의미 있는 특화가 훨씬 적었으며, 다국어 분석에서는 언어별로 단순하게 나뉘는 전문가 분할이 없었다고 보고했다. 따라서 전문가 번호는 믿을 만한 주제 라벨이 아니며, 라우팅된 예제 몇 개를 살펴본다고 의미 역할이 완전히 확인되지는 않는다.4,9
희소 업사이클링(sparse upcycling)은 사전 학습된 밀집 체크포인트에서 MoE를 초기화한다. 보통 밀집 피드포워드 계층을 여러 전문가로 복사한 뒤 새 라우터로 학습을 이어 간다. Komatsuzaki 등 연구진은 언어 모델과 비전 모델에서 이 방법을 보였고, 그 이득이 추가 학습 예산과 설정에 따라 달랐다고 함께 보고했다. 업사이클링은 체크포인트를 재사용할 뿐, 라우팅을 학습하고 처음에는 동일한 전문가들을 서로 다르게 만드는 과정을 없애지는 않는다.20
전문가의 크기와 구성도 추가 설계 변수다. 세분화 MoE(fine-grained MoE)는 비슷한 전문가 매개변수 예산을 더 많고 더 작은 전문가로 나누고, 그중 더 큰 조합을 활성화한다. 스케일링 법칙 실험은 이 세분성을 고정된 전문가 크기를 가정하지 않고 별도의 하이퍼파라미터로 다뤘다. DeepSeekMoE는 시험한 구조에서 세분화된 라우팅 전문가와 항상 활성화되는 공유 전문가를 결합했다. 이런 설계는 균일하고 전부 라우팅되는 전문가에 대한 대안을 보여 주지만, 보고된 품질과 효율 비교가 다른 모델에 자동으로 옮겨지지는 않는다.16,17
8. 추론과 배포
희소 연산량이 작다고 배포 규모가 비례해서 작아지지는 않는다. 저지연 추론 실행에서는 선택될 수 있는 모든 전문가가 대개 서빙 시스템 어딘가에 상주하거나 적재 정책으로 가용해야 한다. 샤딩은 가중치를 장치에 나누고, 복제는 경합을 줄이는 대가로 메모리를 더 쓰며, 오프로딩은 가속기 상주량을 줄이지만 데이터 이동을 늘린다. 양자화는 저장과 연산 정밀도를 바꾼다. 장치당 메모리는 전체 모델 크기보다 훨씬 작을 수 있지만, 모델 가중치 전체는 여전히 존재한다.
토큰 하나는 전문가 한두 개만 활성화할 수 있지만, 이질적인 토큰 묶음은 많은 전문가를 활성화한다. 따라서 토큰당 활성 매개변수는 메모리 트래픽과 지연 시간을 예측하는 지표로서 불완전하다. 프롬프트 처리는 단일 토큰 자기회귀 디코딩보다 전문가별로 묶을 토큰이 많은 경우가 많지만, 디코딩 효율은 동시 요청 배치 처리에 크게 좌우된다. 전문가별 묶음이 작으면 행렬 연산 하드웨어를 덜 쓰게 되고, 통신이나 가중치 읽기가 시간을 지배할 수 있다.8
서빙 지표도 서로 다른 방향으로 움직인다. 자주 선택되는 전문가를 복제하면 처리량은 오르지만 다른 전문가에 필요한 메모리를 쓰게 된다. 용량을 늘리면 넘침은 줄지만 버퍼가 커진다. all-to-all 그룹을 제한하면 통신 거리는 줄지만 배치 유연성이 떨어진다. 설정은 아키텍처 이름으로 추론하기보다 의도한 하드웨어, 트래픽 분포, 시퀀스 길이, 배치 정책, 지연 목표에서 평가해야 한다.
9. 평가와 절충
MoE 모델과 밀집 모델은 둘 이상의 규모 축을 가진다. 라우팅된 언어 모델 실험은 전체 매개변수 수와 계산량이 모두 성능에 영향을 주며, 두 값의 관계를 설명하는 추가 모델 없이는 일반적인 밀집 모델의 매개변수 수 하나로 묶을 수 없음을 보였다. 세분화 MoE 실험은 여기에 전문가 세분성과 학습 토큰 수를 더했다. 따라서 전체 매개변수 수나 활성 매개변수 수 하나만으로는 모델 품질이나 효율을 확정할 수 없다.7,17
유용한 비교는 최소한 아래 항목을 함께 보고한다.
| 구분 | 필요한 정보 |
|---|---|
| 모델 | 전체 매개변수, 공유 매개변수, 전문가 수와 크기, MoE를 쓰는 계층, 라우팅 방식, k |
| 학습 | 데이터, 토큰 수, 목적함수, 옵티마이저, 정밀도, 전체 학습 계산량, 실패 및 토큰 드롭 비율 |
| 토큰당 작업 | 활성 전문가 매개변수, 공유 밀집 작업, 측정 또는 추정 연산량, 라우터 작업 |
| 배치 구성 | 장치, 가중치 정밀도, 샤딩, 복제, 오프로딩, 총 메모리 |
| 통신 | 전문가 병렬 그룹, 토폴로지, 전송 바이트 수, 집합 통신 구현, 중첩 정책 |
| 품질 | 같은 데이터와 평가 절차에서의 보류 손실과 하위 작업 평가 |
| 서빙 | 프롬프트와 디코딩 지연, 처리량, 배치 정책, 시퀀스 길이, 서비스 수준 목표 |
GShard, Switch, DeepSpeed-MoE, Tutel, MegaBlocks, COMET에서 보고된 벽시계 기준 속도 향상은 특정 모델, 기준선, 소프트웨어, 하드웨어, 병렬 구성에서 측정된 값이다. 이를 MoE의 일반적인 배수처럼 제시해서는 안 된다. 에너지 사용과 비용에도 같은 주의가 필요하다.5,6,8,10,11,14
보고되는 연산 수에도 명시된 범위가 필요하다. 전문가 행렬 곱셈이 산술 추정을 지배하는 동안, 라우팅, 패딩, 집합 통신, 동기화, 가중치 이동은 따로 측정되거나 빠질 수 있다. FLOPs는 알고리즘을 맞춘 비교에는 쓸모 있지만, 대상 시스템에서의 경과 시간, 메모리, 네트워크 트래픽, 서비스 수준 측정을 대신하지는 못한다.
MoE는 일반적인 앙상블과도 다르다. 앙상블은 대개 여러 구성 모델의 예측을 결합하며, 종종 따로 학습한 뒤 합친다. 반면 MoE는 보통 라우팅과 전문가를 함께 학습하고, 라우팅된 계층을 더 큰 네트워크 안에 둘 수 있다. 일부 분야에서는 용어가 겹치므로 이름보다 학습 및 라우팅 구조가 더 많은 정보를 준다.
10. 응용
최초의 신경망 국소 전문가 혼합은 범용 지도 학습 아키텍처였다. 이후 대규모 희소 MoE 연구는 언어 모델링과 번역에 크게 집중되었다. 이 기법은 언어를 넘어서도 적용된다. V-MoE는 희소 전문가 계층을 Vision Transformer에 넣고 이미지 인식에서 평가했으며, Soft MoE는 시각 인식에서 미분 가능한 슬롯 기반 라우팅을 연구했다.2,3,4,5,15,21
이 예들은 MoE가 특정 언어 모델의 동의어가 아니라 조건부 계산 패턴임을 보여 준다. 도움이 되는지는 데이터, 과제, 최적화 방법, 전문가 설계, 라우터, 실행 시스템에 따라 달라진다. 매개변수 저장, 통신, 소규모 배치의 지연 시간, 구현 복잡도, 학습 안정성이 조건부 용량 확장보다 더 중요하면 밀집 모델이 더 나을 수 있다.
출처 21개
- AI Wiki: Mixture of Experts (MoE) (2026-10-04 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-26
- Adaptive Mixtures of Local Experts cs.toronto.edu · 확인 2026-10-26
- Hierarchical Mixtures of Experts and the EM Algorithm doi.org · 확인 2026-10-26
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer arxiv.org · 확인 2026-10-26
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding arxiv.org · 확인 2026-10-26
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity jmlr.org · 확인 2026-10-26
- Unified Scaling Laws for Routed Language Models proceedings.mlr.press · 확인 2026-10-26
- DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training to Power Next-Generation AI Scale proceedings.mlr.press · 확인 2026-10-26
- ST-MoE: Designing Stable and Transferable Sparse Expert Models arxiv.org · 확인 2026-10-26
- Tutel: Adaptive Mixture-of-Experts at Scale proceedings.mlsys.org · 확인 2026-10-26
- COMET: Fine-grained Computation-communication Overlapping for Mixture-of-Experts proceedings.mlsys.org · 확인 2026-10-26
- BASE Layers: Simplifying Training of Large, Sparse Models proceedings.mlr.press · 확인 2026-10-26
- Mixture-of-Experts with Expert Choice Routing proceedings.neurips.cc · 확인 2026-10-26
- MegaBlocks: Efficient Sparse Training with Mixture-of-Experts proceedings.mlsys.org · 확인 2026-10-26
- From Sparse to Soft Mixtures of Experts proceedings.iclr.cc · 확인 2026-10-26
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models aclanthology.org · 확인 2026-10-26
- Scaling Laws for Fine-Grained Mixture of Experts proceedings.mlr.press · 확인 2026-10-26
- ReMoE: Fully Differentiable Mixture-of-Experts with ReLU Routing proceedings.iclr.cc · 확인 2026-10-26
- Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts arxiv.org · 확인 2026-10-26
- Sparse Upcycling: Training Mixture-of-Experts from Dense Checkpoints openreview.net · 확인 2026-10-26
- Scaling Vision with Sparse Mixture of Experts proceedings.neurips.cc · 확인 2026-10-26
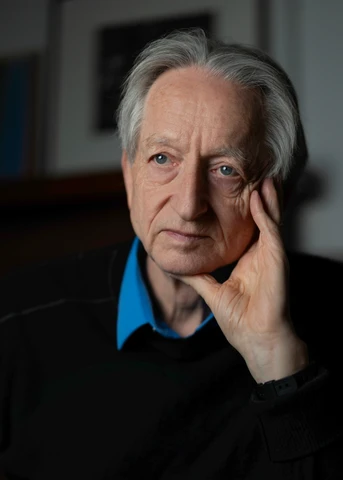 제프리 힌턴
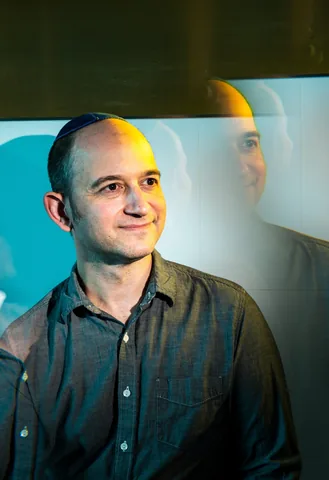 노암 셔지어