AI 스타트업 Recursive가 2026년 10월 21일(현지시간) 첫 모델 Flint를 공개했다. 노트북에서 돌리는 코딩 모델로, 총 40B 매개변수 가운데 토큰당 약 2.5B만 쓰는 전문가 혼합 구조다. 가중치는 Hugging Face에서 Apache 2.0 라이선스로 내려받을 수 있다.1,2
Ollama v0.40.8에는 ollama run flint 명령이 들어갔다. Ollama 릴리스 노트는 Flint가 macOS에서 지원되며, 다른 GPU 지원은 이후 릴리스에서 활성화될 예정이라고 적었다. llama.cpp도 b11803 빌드에 Flint 모델(FlintForCausalLM)을 추가했다. Marktechpost는 Flint가 llama.cpp, Ollama, Unsloth, LM Studio, vLLM, SGLang에서 작동한다고 전했고, 에이전트가 쓴 'Sponsored' 표시 글인 TestingCatalog도 같은 지원 목록을 실었다.2,3,4,5
필요한 하드웨어와 속도
Flint는 텍스트 전용 디코더 방식 트랜스포머로, 저장소 단위 코딩 작업을 겨냥했다. 코드베이스 파악, 버그 추적, 기능 구현, 테스트 작성을 맡고 추론과 OpenAI 호환 도구 호출을 지원한다. 컨텍스트 창은 모델 카드 기준 262,144 토큰이며, Recursive 블로그는 최대 512k까지 쓸 수 있다고 적었다. 회사는 256k 이내를 권장한다.2,5
Recursive는 자체 엔진 rec으로 M4 Pro 맥북 프로에서 초당 125토큰 넘게, 64GB NVIDIA RTX Spark에서 150토큰 넘게 나온다고 밝혔다. 모두 짧은 컨텍스트 기준이며 비슷한 모델의 최대 2배 속도라는 주장이다. TechCrunch는 Recursive의 시험에서 M4 Pro 기준 초당 약 131토큰이 나왔다고 전했다. 같은 기기에서 비슷한 모델들은 초당 58~69토큰에 그쳤고, 여기에는 Google의 Gemma 4와 NVIDIA의 Nemotron 3.5 Lightning이 포함된다. 코딩 점수가 비슷한 25~40B 밀집 모델보다 5배 넘게 빠르다는 것도 회사 주장이다.1,2
- Apple Silicon: INT4 MLX 가중치가 약 22.6GB이고, rec 엔진은 48GB 메모리의 M4 Pro, M5 Pro, M5 Max가 필요하다. llama.cpp보다 M4 Pro에서 1.4~2.6배 처리량이 나온다고 회사는 밝혔다.
- NVIDIA: NVFP4 GGUF 파일이 22.9GB이며 Recursive는 GPU 메모리 48GB 이상을 권장한다.
- 서버: 80GB BF16 체크포인트는 복제본마다 B300 또는 H200 GPU 한 장이 필요하다.2
로컬 실행이라 오프라인 사용, 코드 비공개, 사용량 요금 회피가 가능하다. 다만 Recursive는 대형 유료 코딩 어시스턴트보다 안내가 더 필요하다며, 큰 작업을 작은 단계로 나누고 지시를 구체적으로 주라고 권했다.1,5
성능과 비교
아래 점수는 모두 Recursive가 직접 밝힌 수치다. 샘플링은 온도 1.0, Top-p 0.95, Top-k 20을 썼다. Terminal-Bench는 Terminus 2 하네스를 썼고 웹 검색으로 찾은 풀이는 실패로 처리했다. SWE-bench는 인터넷 없이 mini-swe-agent로 돌렸으며, 에이전트 점수는 5회 이상 시도의 pass@1 평균이다.2
| 벤치마크 | BF16 | NVFP4 |
|---|---|---|
| Terminal-Bench 2.1 | 54.9% | 53.7% |
| SWE-bench Pro v2 | 89.7% | 88.5% |
| SWE-bench Verified | 74.2% | 74.1% |
| LiveCodeBench v6 | 80.3% | 80.8% |
| IFBench | 89.2% | 88.1% |
| IFEval | 95.1% | 94.6% |
Recursive는 총 50B 미만 전문가 혼합 모델 가운데 SWE-bench Pro v2, Terminal-Bench 2.1, SWE-bench Verified에서 앞선다고 밝혔다. 그러나 같은 비교표에서 밀집 모델 Qwen 3.8은 Terminal-Bench 2.1에서 73.0%로 Flint를 크게 앞선다. SWE-bench Verified에서는 Qwen 3.8이 75.6%(Recursive 측정치), 밀집 모델 Muse Glimmer가 76.0%로 Flint의 74.2%보다 높다. Qwen 3.6은 73.4%다. SWE-bench Pro v2는 Recursive가 직접 측정한 점수여서 공개 SWE-bench Pro와 비교할 수 없다.2,5
TechCrunch는 Recursive 자체의 여섯 개 시험 평균을 기준으로, 비교 모델 가운데 Alibaba의 Qwen3.8 27B만 Flint보다 높았다고 전했다. 같은 매체는 SWE-Bench Verified에서 Flint가 50B 미만 다른 모델을 앞섰다고 썼지만, 위 비교표에서는 밀집 모델인 Qwen 3.8(75.6%)과 Muse Glimmer(76.0%)가 Flint(74.2%)보다 높아 이 서술은 표와 맞지 않는다. 표 기준으로 Flint가 앞선다고 할 수 있는 범위는 50B 미만 전문가 혼합 모델 사이의 비교다.1,2
Wired의 Will Knight는 메모리 48GB 맥에서 할 일 앱과 웹 조사 도구 등 작은 프로그램 여러 개를 만들게 했다. 작은 코딩 모델은 Claude나 Codex에 비해 오류가 나거나 느린 경우가 많았지만 Flint는 요청마다 코드를 맞게 만들었다고 한다.1
자동 연구 시스템 Eureka Machine
Recursive는 자동 연구 시스템 Eureka Machine이 아이디어를 내고 구현과 시험을 거쳐 다음 시도를 정하는 방식으로 개발 전반을 도왔다고 밝혔다. 소규모 팀이 4개월 미만에 처음부터 모델을 만들었다. 구조는 총 35B에 활성 3B인 기준 모델에서 출발해 전문가 구성과 폭을 탐색한 끝에 40B, 활성 2.5B에 이르렀다.1,2,5
양자화에서는 관행과 달리 출력층(lm_head)을 4비트로 줄이고, 16비트 모델을 교사로 한 오프라인 지식 증류로 정확도를 되살렸다. 양자화 인지 학습 기준선보다 학습 단계가 거의 절반으로 줄었다. Recursive는 NVFP4 모델이 16비트 모델과 0.7점 이내라고 밝혔지만 평균인지 최대 차이인지는 설명하지 않았고, 표에서는 Terminal-Bench 2.1과 SWE-bench Pro v2가 1.2점, IFBench가 1.1점 벌어진다. TechCrunch는 회사가 품질 손실이 거의 없는 저비트 학습으로 Flint를 71% 줄였다고 전했다. 저비트 투영, 전문가 혼합 연산, 어텐션, 프롬프트 처리용 커널도 만들었고, M4·M5 칩에서는 디코딩 전 과정을 묶는 Metal 메가커널을 쓴다.1,2
구조는 49개 층으로, 밀집 2층 뒤에 전문가 혼합 47층이 이어진다. 층마다 라우팅 전문가 256개 중 6개와 항상 켜지는 공유 전문가 1개를 쓴다. 35개 층은 513토큰 슬라이딩 윈도 어텐션, 14개 층은 위치 인코딩 없는 전체 어텐션이다.2
Recursive는 2026년 5월 GV, NVIDIA, AMD Ventures 등으로부터 6억 5천만 달러를 투자받고 기업 가치 46억 5천만 달러로 모습을 드러냈다. 대표는 Salesforce 전 최고과학자 Richard Socher다. Socher는 Wired에 장기 목표가 Eureka Machine의 완전한 재귀적 자기 개선이며, 사람이 감독하고 문제가 생기면 멈출 수 있어야 한다고 말했다. Eureka Machine이 연구 시간을 얼마나 줄였는지는 밝히지 않았다.1
출처
- Recursive launches Flint, a laptop coding model it says was largely built by AI techcrunch.com
- Recursive Releases Flint, an Open-Weight 40B MoE Local Coding Model for Agents with 2.5B Active Params marktechpost.com
- ollama/ollama v0.40.8 github.com
- ggml-org/llama.cpp b11803 github.com
- Recursive releases Flint, 40B model for local coding testingcatalog.com
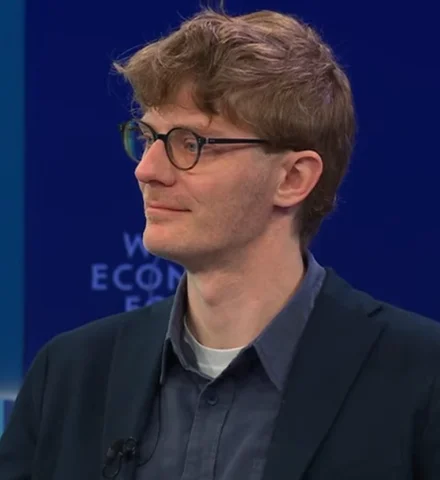 리처드 소처