쉽게 말하면, 추론 모델은 곧바로 답을 내놓지 않고 여러 단계로 생각한 뒤 답하는 AI 모델이다. 수학이나 과학 문제처럼 단계를 거쳐야 풀리는 문제에서 성능이 두드러진다. 2024년 말부터 이런 모델이 최첨단 AI의 주류가 되었다.
| 분류 | 인공지능의 추론 능력과 이를 강화한 추론 모델 |
|---|---|
| 핵심 방식 | 답하기 전에 내부에서 여러 단계의 사고를 거치며, 추론 실행 시점에 추가 연산을 사용 |
| 대표 모델 | OpenAI o1·o3, DeepSeek R1, Google DeepMind Gemini Deep Think |
| 부상 시기 | 2024년 말 이후 최첨단 AI의 주류 |
| 주요 평가 | 수학, 과학, 코딩 벤치마크 |
1. 개요
인공지능에서 추론(reasoning)은 AI 시스템이 한 번의 즉각적인 응답 대신 구조화된 여러 단계의 사고를 거쳐 추론하고, 문제를 풀고, 결정을 내리는 능력이다. 논리적 연역, 패턴 인식, 가설 형성, 불확실성 다루기를 포함하며, 1950년대 인공지능 분야가 시작된 이후 AI의 핵심 목표였다. 2024년 말부터는 '추론 모델'이라는 별도 부류가 최첨단 AI를 주도하고 있다. OpenAI의 o1과 o3, DeepSeek의 R1, Google DeepMind의 Gemini Deep Think 같은 시스템은 추론 실행 시점에 추가 연산을 쓰고, 답하기 전에 내부 사고의 연쇄를 만들며, 수학·과학·코딩 벤치마크에서 큰 향상을 보인다.
최근 진전은 구체적인 숫자로 확인된다. 2025년 7월 Gemini Deep Think의 고급 버전은 국제수학올림피아드(IMO) 문제 6개 중 5개를 풀어 42점 만점에 35점을 받았다. 표준적인 인간 응시 조건에서 공식적으로 금메달 수준에 도달한 최초의 AI다. DeepSeek R1은 2025년 1월 20일 MIT 라이선스로 공개되었고, 약 96% 낮은 API 비용으로 o1급 성능에 도달했다. 2025년 9월에는 동료 심사를 거쳐 「Nature」 표지에 실린 최초의 대규모 언어 모델이 되었다. 이 시스템들이 실제로 추론하는지, 아니면 정교한 패턴 매칭을 하는지는 중요한 미해결 질문으로 남아 있다. 2025년의 연구 결과는 최첨단 추론 모델이 일정 문제 복잡도를 넘으면 '완전한 정확도 붕괴(complete accuracy collapse)'를 보인다고 밝혀, 이 질문을 더 날카롭게 만들었다.2,3,4,5
2. 추론의 종류
AI의 추론은 인간 인지 능력의 서로 다른 측면을 반영하는 여러 유형으로 나눌 수 있다. 이 유형들은 서로 배타적이지 않다. 실제 문제 해결에서는 여러 형태의 추론을 동시에 결합하는 경우가 많다.
연역 추론은 일반적인 전제에서 구체적인 결론으로 나아간다. 전제가 참이고 논리가 타당하면 결론도 반드시 참이다. 예를 들어 '모든 포유류는 온혈 동물이다. 개는 포유류다. 따라서 개는 온혈 동물이다.'가 이에 해당한다. 고전적 기호 AI 시스템과 Prolog 같은 논리 프로그래밍 언어는 연역 추론을 중심으로 만들어졌다.
귀납 추론은 반대 방향으로 작동하며, 구체적인 관찰에서 일반적인 결론을 끌어낸다. 수천 개의 스팸 메일을 관찰해 공통 패턴을 익히는 시스템이 귀납을 수행하는 예다. 대부분의 머신러닝 알고리즘은 귀납 추론에 크게 의존하며, 학습 데이터에서 일반화해 처음 보는 입력에 대한 예측을 만든다.
귀추 추론은 관찰된 사실들에 대해 가장 그럴듯한 설명을 추론하는 것이다. 의사가 증상을 살피고 진단에 이르는 과정이 귀추적이다. 이 추론은 본질적으로 불확실해서 결론은 보장된 참이 아니라 가장 나은 추정이다. 진단 시스템과 자연어 이해에서 중요한 역할을 한다.
유추 추론은 이전에 풀었던 문제와의 유사성을 찾아 새 문제를 푼다. 한 도시의 도로망을 익힌 시스템이 비슷한 전략을 다른 도시에 적용하는 것이 예다. 이 유형은 현대 AI의 전이 학습과 퓨샷 학습의 핵심이다.
인과 추론은 상관관계를 넘어 원인과 결과의 관계를 이해한다. 우산 판매량과 비가 함께 움직인다는 사실만 알아채는 데 그치지 않고, 비가 사람들이 우산을 사게 만든다는 것이지 그 반대가 아니라는 점을 이해하는 것이 인과 추론이다. 주디아 펄(Judea Pearl)의 인과 추론 연구는 AI 시스템에 이 유형의 추론을 형식화하는 데 영향을 끼쳤다.6
상식 추론은 사람들이 당연하게 여기는 방대한 일상 지식을 적용하는 것이다. 유리잔은 떨어뜨리면 깨진다는 것, 사람은 식사 전에 배가 고파진다는 것, 힘이 가해지지 않으면 물체는 위로 떠오르지 않는다는 것이 예다. 상식 지식은 범위가 엄청나고 형식화하기 어렵기 때문에, 이는 역사적으로 AI에게 가장 어려운 과제 중 하나였다.
수학적 추론은 수치와 기호 식을 다루고, 증명을 세우고, 방정식을 푸는 일을 포함한다. 정밀성, 다단계 논리, 추상적 규칙을 올바르게 적용하는 능력이 필요하다. 수학적 추론은 최신 추론 모델을 평가하는 대표적인 벤치마크로 자리 잡았다.
공간 추론은 공간 속 사물의 위치, 모양, 관계를 이해하고 조작하는 일을 다룬다. 로봇공학, 컴퓨터 비전, 내비게이션 과제에서 결정적이다. 물리적 배치를 묘사하는 언어를 이해하는 데에도 역할을 한다.
3. 추론 연구의 역사
기계 추론을 추구하는 일은 AI 분야 자체만큼 오래되었다. 접근법은 수십 년에 걸쳐 손으로 짠 논리에서 통계적 방법을 거쳐 오늘날 지배적인 신경망 시스템으로 크게 바뀌었다.
3.1. 논리 기반 AI(1950년대~1980년대)
가장 초기의 AI 프로그램은 지능을 형식 논리와 기호 조작으로 포착할 수 있다는 전제 위에 세워졌다. 1955년 앨런 뉴얼(Allen Newell)과 허버트 A. 사이먼(Herbert A. Simon)은 J.C. 쇼(J.C. Shaw)의 도움을 받아 '논리 이론가(Logic Theorist)'를 만들었고, 이는 가장 이른 AI 프로그램으로 널리 꼽힌다. 논리 이론가는 버트런드 러셀(Bertrand Russell)과 앨프리드 노스 화이트헤드(Alfred North Whitehead)의 「수학 원리(Principia Mathematica)」에 나오는 처음 52개 정리 가운데 38개를 증명했고, 일부 경우에는 원래 증명보다 더 우아한 증명을 찾아냈다.7
1956년 다트머스 워크숍은 존 매카시(John McCarthy)와 마빈 민스키(Marvin Minsky)가 조직했고, AI를 학문 분야로 공식화했다. 이후 연구자들은 범용 문제 해결기(General Problem Solver, 1957)처럼 범용 추론 전략을 부호화하려는 시스템을 만들었다. 매카시는 1958년 Lisp를 개발했고, 이후 상황 계산(situation calculus) 연구로 행위와 변화에 대해 추론하는 프로그래밍 도구와 형식 체계를 제공했다.
이 시기는 흔히 '구식 AI(Good Old-Fashioned AI, GOFAI)' 또는 기호 AI라 불리는 방식이 지배했다. 핵심 가정은 지능이 논리 규칙에 따라 기호 표현을 조작하는 것이라는 점이었다. 이 시스템들은 좁은 영역에서 인상적인 연역을 해냈지만, 현실 세계 지식의 복잡함과 가능한 추론의 조합적 폭발을 다루는 데 어려움을 겪었다.
3.2. 전문가 시스템(1970년대~1990년대)
전문가 시스템은 AI 추론의 첫 본격적인 상업적 응용이었다. 이 시스템들은 인간 분야 전문가의 지식을 if-then 규칙의 모음으로 부호화했다. 스탠퍼드에서 개발된 MYCIN(1976)은 세균 감염을 진단하고 항생제를 추천할 수 있었으며, 정확도는 인간 전문가와 비슷했다. DENDRAL(1969)은 질량 분석 데이터로부터 분자 구조를 결정할 수 있었다.
전문가 시스템은 좁고 영역 특화된 추론도 실제로 유용할 수 있음을 보여 주었다. 그러나 이 시스템들은 깨지기 쉬웠다. 프로그래밍된 규칙 밖의 상황은 처리하지 못했고, 만들고 유지하는 데 막대한 노력이 들었으며, 새 데이터로부터 학습하는 능력도 없었다. 1990년대 초에는 전문가 시스템에 대한 관심이 크게 식었다.
3.3. 통계·확률적 접근(1990년대~2010년대)
순수한 기호 추론의 한계는 통계적 방법으로의 전환을 이끌었다. 베이즈 네트워크(Bayesian network), 은닉 마르코프 모델 등 확률적 틀은 AI 시스템이 불확실성 속에서 추론할 수 있게 했다. 이는 규칙 기반 시스템에 없던 능력이다.
이 시기에는 머신러닝이 지배적인 패러다임으로 떠올랐다. 추론 규칙을 손으로 짜는 대신 시스템이 데이터에서 패턴을 학습했다. 서포트 벡터 머신, 결정 트리, 그리고 마침내 딥러닝 모델은 음성 인식에서 이미지 분류까지, 기호적 방법이 풀지 못한 문제를 통계적 패턴 인식으로 풀 수 있음을 보여 주었다.
3.4. 신경망 추론(2010년대~현재)
2012년경 ImageNet에서 AlexNet이 성공을 거두며 시작된 딥러닝 혁명은 처음에 이미지 인식과 음성 처리 같은 지각 과제에 집중했다. 그러나 연구자들은 곧 신경망이 추론도 수행할 수 있는지 탐구하기 시작했다.
초기 이정표로는 DeepMind의 AlphaGo(2016)가 있다. 이 시스템은 딥러닝과 트리 탐색을 결합해 바둑 세계 챔피언을 이겼고, 신경망 접근이 복잡한 전략적 추론을 다룰 수 있음을 보여 주었다. 2017년 트랜스포머 구조가 도입되었고, 이후 대규모 언어 모델이 발전하면서 이 모델들은 논리, 수학, 상식 추론 과제에서 예상하지 못한 능력을 보이기 시작했다. 이로써 AI 추론의 새로운 장이 열렸다.
4. 대규모 언어 모델의 추론
GPT-3, GPT-4, Claude 같은 대규모 언어 모델의 등장은, 주로 다음 토큰을 예측하도록 학습된 모델도 추론과 비슷한 행동을 보일 수 있음을 드러냈다. 학습 목표인 다음 단어 예측이 추론을 명시적으로 요구하지 않기 때문에 많은 연구자에게 놀라운 결과였다.
4.1. 사고의 연쇄 프롬프팅에서 추론 모델로
제이슨 웨이(Jason Wei)와 Google 동료들이 2022년 1월 발표한 논문은 사고의 연쇄(chain-of-thought, CoT) 프롬프팅을 소개했다. 핵심 통찰은 단순하지만 강력했다. 프롬프트의 예시에 중간 추론 단계를 포함하면, 모델이 답에 이르기 전에 스스로 단계별 추론을 생성하도록 유도할 수 있었다.
실험에서 사고의 연쇄 프롬프팅은 산술, 상식, 기호 추론 과제의 성능을 크게 높였다. 5,400억 매개변수 규모의 PaLM 모델은 사고의 연쇄 예시 8개만 주어졌을 때, 초등학교 수준 수학 서술형 문제 벤치마크인 GSM8K에서 최고 수준의 정확도를 달성했다. 이 기법은 큰 모델에서 가장 잘 작동했고 작은 모델은 이득이 적었다. 이는 추론 능력이 규모에 따라 나타난다는 것을 시사한다.
사고의 연쇄 프롬프팅에서는 여러 변형이 생겨났다. 제로샷 CoT는 프롬프트에 '단계별로 생각해 보자'를 덧붙이는 방식이다. 자기 일관성(self-consistency)은 여러 추론 경로를 샘플링한 뒤 다수결로 답을 정한다. 생각의 나무(tree-of-thought)는 가지를 뻗는 추론 경로를 탐색한다.
사고의 연쇄 프롬프팅은 LLM이 추론 흔적을 만들 수 있음을 보여 주었지만, 그 추론은 자주 믿기 어렵고 일관되지 않았다. 다음 단계는 프롬프팅 요령에만 기대는 대신 추론하도록 모델을 직접 학습시키는 것이었다. 그래서 '대형 추론 모델(large reasoning models, LRM)'이라 불리는 전용 모델이 개발되었다. 이 모델들은 강화 학습 등 기법으로 사고의 연쇄를 핵심 능력으로 내재화한다.
5. 주요 추론 모델
2024년 말 이후 여러 주요 추론 모델이 출시되었으며, 이는 AI 개발의 새로운 패러다임을 보여 준다. 아래 표는 가장 중요한 시스템을 요약한다.
| 모델 | 개발사 | 출시일 | 주요 특징 |
|---|---|---|---|
| OpenAI o1 | OpenAI | 2024년 9월 12일(미리보기), 2024년 12월 5일(정식) | 최초의 주요 추론 모델. 강화 학습으로 학습된 내부 사고의 연쇄를 사용. 2024년 AIME에서 83.3%, GPQA Diamond에서 78%를 기록8 |
| OpenAI o3-mini | OpenAI | 2025년 1월 31일 | 더 작고 빠른 추론 모델. AIME 2024에서 80%를 기록했으며 o1보다 비용이 크게 낮음9 |
| DeepSeek R1 | DeepSeek | 2025년 1월 20일 | 오픈소스(MIT 라이선스). 순수 강화 학습으로 학습. o1과 비슷한 성능을 약 96% 낮은 비용으로 제공. 증류 변형 모델과 함께 공개. 2025년 9월 「Nature」 표지에 실림3,4 |
| Claude 3.7 Sonnet(확장 사고) | Anthropic | 2025년 2월 25일 | 확장 사고 모드를 켜고 끌 수 있는 하이브리드 모델. 개발자가 최대 128K 토큰까지 '사고 예산'을 설정 가능. 정확도가 사고 토큰 수에 따라 로그 비례로 향상10 |
| Gemini 2.0 Flash Thinking | Google DeepMind | 2024년 12월 19일 | Gemini 2.0 Flash의 실험적 추론 변형. 다단계 추론 개선을 위해 사고 흔적(thinking traces)을 도입11 |
| OpenAI o3 | OpenAI | 2025년 4월 16일 | 도구 사용이 가능한 멀티모달 추론 모델. AIME 2024에서 91.6%, GPQA Diamond에서 83.3%. 웹 탐색과 코드 실행이 가능 |
| OpenAI o4-mini | OpenAI | 2025년 4월 16일 | 처리량이 큰 추론 모델. o3 성능의 90% 넘게를 연산 비용 절반으로 제공12 |
| QwQ-32B | Alibaba Cloud | 2024년 11월(미리보기), 2025년 3월(정식) | Qwen2.5 기반 오픈소스 추론 모델. AIME와 LiveCodeBench 벤치마크에서 DeepSeek R1과 비슷한 성능13 |
| OpenAI o3-pro | OpenAI | 2025년 6월 10일 | 출시 당시 OpenAI가 가장 역량이 뛰어난 추론 모델로 소개됨. 가장 어려운 과제에서 최고 정확도를 목표로 설계14 |
| Gemini Deep Think | Google DeepMind | 2025년 8월 1일(정식 공개) | 병렬 가설 탐색 방식. 국제수학올림피아드(IMO), 국제물리올림피아드(IPhO), 국제화학올림피아드(IChO) 필기 부분에서 금메달 수준 성능. ARC-AGI-2에서 84.6%2 |
| Qwen3 | Alibaba Cloud | 2025년 4월 29일 | 추론 모드와 비추론 모드를 전환하는 하이브리드 모델. 36조 토큰으로 학습. 수학, 코드, 논리 추론에서 QwQ보다 크게 향상15 |
| GPT-5 | OpenAI | 2025년 8월 7일 | 실시간 라우터로 빠른 모델과 더 깊은 'gpt-5-thinking' 추론 모델 사이를 전환하는 통합 시스템. 도구 없이 AIME 2025에서 94.6%16 |
6. 추론 모델의 작동 방식
추론 모델은 AI 시스템을 만들고 추론 실행 단계에서 쓰는 방식에 근본적인 전환을 나타낸다. 이 모델들은 가능한 한 빨리 다음 토큰을 예측하는 대신, 답하기 전에 '생각'하도록 설계되었다. 추론 실행 중에 추가 연산 자원을 배분해 어려운 문제를 풀어 낸다.
6.1. 테스트 타임 컴퓨트
기존 LLM은 학습 시점 컴퓨트를 확장하는 패러다임을 따른다. 더 많은 데이터로 더 큰 모델을 학습시켜 성능을 높이는 방식이다. 추론 모델은 이를 보완하는 접근인 테스트 타임 컴퓨트 확장을 도입한다. 추론 실행 시점의 연산을 늘리는 것이라고도 불린다. 핵심 아이디어는 모델이 추론 실행 시점에 더 많은 시간을 '생각'하는 데 쓰고, 최종 답을 내기 전에 내부 추론 토큰을 생성해 답을 개선할 수 있다는 것이다.
이는 AI 성능을 높이는 새로운 차원을 열었다. 개발자는 더 큰 모델을 만드는 대신, 더 작은 모델에 문제를 추론할 시간을 더 주는 방식을 택할 수 있다. 연구에서는 적절한 추론 전략과 함께 추론 연산을 확장하는 편이 모델 매개변수만 확장하는 것보다 계산 효율이 높을 수 있다는 결과가 나왔다. 경우에 따라서는 더 길게 추론한 작은 모델이 답을 즉시 내는 더 큰 모델을 능가하기도 한다.17
배포에 미치는 영향도 크다. 분석가들은 2030년까지 추론 실행이 전체 AI 연산의 75%를 차지할 것으로 내다본다. 질의 하나당 표준 모델보다 토큰을 10~100배 더 소비하는 추론 모델의 채택이 늘어나는 것도 한 원인이다.
6.2. 내부 사고의 연쇄
추론 모델은 최종 답을 내기 전에 내부 사고의 연쇄를 생성한다. 사용자가 모델에게 추론 과정을 보여 달라고 명시적으로 요청하는 사고의 연쇄 프롬프팅과 달리, 내부 사고의 연쇄는 학습으로 얻어진 행동이다. 모델은 복잡한 문제를 단계로 나누고, 여러 접근을 검토하며, 자신의 풀이를 점검해 답을 다듬는다.
OpenAI의 o1에서 내부 사고의 연쇄는 사용자에게 숨겨지고 요약만 보인다. OpenAI는 원래의 사고 과정을 사용자에게 보여 주지 않기로 했다고 밝혔다. 그 이유로 안전성과, 걸러지지 않은 중간 단계에 정책 위반 내용이 담길 수 있다는 위험을 들었다. 모델은 수학 문제 하나를 풀 때 간결한 최종 답을 내기 전에 내부적으로 수백에서 수천 토큰을 추론에 쓸 수 있다. 오픈소스인 DeepSeek R1은 추론 흔적을 더 잘 드러냈고, '잠깐, 다시 생각해 보자...' 같은 자기 성찰, '이 단계를 확인해 보자...' 같은 검증, 전략을 동적으로 바꾸는 행동을 보여 주었다.3,8
Anthropic의 Claude 확장 사고(extended thinking) 모드는 접근이 다소 다르다. 개발자는 Claude가 내부 추론에 쓸 수 있는 토큰 수를 정하는 '사고 예산'을 설정할 수 있고, 추론 깊이와 응답 속도 사이의 균형을 세밀하게 조절할 수 있다.10
6.3. 추론 과제에 대한 강화 학습
추론 모델의 학습 과정은 강화 학습(RL)에 크게 의존한다. 일반적인 접근은 기반 언어 모델이 추론 흔적을 만들도록 학습시킨 뒤, 정답으로 이어지는 흔적에는 보상을 주고 그렇지 않은 흔적에는 벌점을 주는 방식으로 RL을 적용하는 것이다.
OpenAI는 o1이 '대규모 강화 학습 알고리즘'을 사용한다고 설명했고, 강화 학습으로 o1이 사고의 연쇄를 다듬고 사용하는 전략을 개선하며 자신의 실수를 알아채고 고치는 법을 익힌다고 밝혔다. DeepSeek의 R1은 한 걸음 더 나아갔다. 사람이 쓴 추론 예시로 하는 지도 미세 조정 없이 순수 강화 학습만으로도 강한 추론 능력이 나올 수 있음을 보였다. 처음부터 대규모 강화 학습으로 학습한 DeepSeek-R1-Zero는 자기 검증과 되돌아가기 같은 고급 추론 패턴을 스스로 발달시켰다. 저자들은 이를 모델이 풀이 도중 접근을 재평가하는 법을 배우는 창발적 행동으로 보고 '아하 모멘트(aha moment)'라고 불렀다.3,8
RL 학습 과정은 보통 정답 여부에 기반한 보상 신호를 쓴다. 이는 정답을 자동으로 검증할 수 있는 수학과 코딩 과제에서 쓰인다. 또는 사람 평가자나 AI 심판의 선호 판단을 쓰기도 한다. DeepSeek는 R1을 집단 상대 정책 최적화(Group Relative Policy Optimization, GRPO)로 학습했다. GRPO는 별도의 비평가(critic) 모델 없이, 모델이 자신이 샘플링한 출력들을 점수 매기고 순위를 정하는 강화 학습 방법이다.3
인간 피드백 강화 학습(RLHF)은 처음에 언어 모델을 도움이 되고 안전하도록 인간의 선호에 맞추기 위해 개발되었다. 비슷한 기법이 추론에도 응용되고 있다. 일부 추론 모델은 결과 기반 보상(답이 맞았는가)과 과정 기반 보상(건전한 추론 단계를 따랐는가)을 함께 쓴다. 과정 보상 모델(process reward models)은 추론 사슬의 최종 답만이 아니라 단계마다 평가하며, 추론 신뢰성을 높이는 데 가능성을 보였다.
7. 추론 벤치마크
추론 능력을 평가하려면 다단계 문제 풀이, 분야 전문성, 새로운 과제 대응 능력을 재는 전문 벤치마크가 필요하다. 아래 표는 추론 모델 평가에 쓰이는 주요 벤치마크를 요약한다.
| 벤치마크 | 분야 | 설명 | 난이도 | 주요 점수 |
|---|---|---|---|---|
| GSM8K | 수학 | 학년 수준 수학 서술형 문제 8,000개로 다단계 산술 추론을 요구. 2021년 OpenAI 연구자들이 도입 | 보통 | 2024년 무렵 대부분 포화 상태이며 상위 모델은 95% 이상18 |
| MATH | 수학 | 대수, 기하, 정수론, 미적분을 다루는 경쟁 수준 고등학교 수학 문제 12,500개 | 어려움 | o1은 전체 세트에서 94.8%, 대부분의 최전선 모델은 90% 이상19 |
| AIME | 수학 | 미국수학초청시험(American Invitational Mathematics Examination) 문제. 명망 있는 고등학교 수학 경시대회로, 창의적 다단계 문제 풀이를 평가 | 매우 어려움 | o1 83.3%(2024), o3 91.6%(2024), o3 88.9%(2025), GPT-5 94.6%(2025)16 |
| GPQA Diamond | 과학 | 물리, 화학, 생물 분야 대학원 수준 객관식 198문항. 분야 전문가가 작성했으며 구글 검색으로 답을 찾기 어렵도록 설계 | 매우 어려움 | o1 78%, o3 83.3%, 2025년 말 상위 모델은 90% 이상 |
| ARC-AGI | 추상 추론 | 새로운 시각 격자에서 패턴을 찾는 능력을 평가. 유동 지능과 일반화를 재기 위해 설계 | 매우 어려움 | Gemini 3 Pro 31.1%(Deep Think 사용 시 45.1%), Gemini Deep Think는 ARC-AGI-2에서 84.6%20 |
| Humanity's Last Exam | 여러 분야 | 여러 학문 분야의 극도로 어려운 문제. 전문가 연합이 만든, 가장 어려운 AI 벤치마크를 목표로 설계 | 극도로 어려움 | 2025년 말 상위 모델 35~50%, 포화와는 거리가 멂 |
7.1. 벤치마크 포화
추론 평가에서 반복되는 과제는 벤치마크 포화다. 한때 수학 추론의 의미 있는 시험으로 여겨졌던 GSM8K는 이제 대부분의 최전선 모델이 거의 완벽한 정확도로 푼다. MATH 벤치마크도 비슷한 궤적을 밟아, 2021년 10% 미만이던 정확도가 2024년에는 90%를 넘었다. 이 빠른 포화는 AIME, GPQA Diamond, Humanity's Last Exam처럼 점점 더 어려운 벤치마크를 만들어 내는 동력이 되었다.
이 패턴은 정적 벤치마크가 장기적으로 추론 능력의 신뢰할 만한 척도가 아닐 수 있음을 시사한다. 모델은 특정 벤치마크에 맞춘 학습으로 점수를 올릴 수 있어, 실제 추론 능력 향상과 벤치마크 특화 최적화를 구별하기 어렵다.
8. 추론 시점 확장 법칙
카플란 등(Kaplan et al., 2020)과 호프만 등(Hoffmann et al., 2022, '친칠라(Chinchilla)' 논문)이 제시한 기존 확장 법칙은 모델 크기, 학습 데이터, 학습 연산량의 관계에 초점을 맞췄다. 추론 실행 시점의 확장 법칙은 이 틀을 생성 과정에 쓰이는 연산으로 넓힌다.
2024년 스넬 등(Snell et al.)의 핵심 논문 「Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters」는 추론 과제에서 추론 실행 시점에 연산을 더 쓰는 것이 단순히 더 큰 모델을 학습시키는 것보다 FLOP당 성능을 더 높일 수 있음을 보였다. 이 발견은 AI 배포의 경제성에 큰 함의가 있다.17
OpenAI는 o1의 성능이 학습 연산과 테스트 시점에 생각하는 시간이 늘수록 일관되게 향상된다고 보고했다. Anthropic은 Claude의 수학 문제 정확도가 샘플링이 허용된 사고 토큰 수에 따라 로그 비례로 향상된다고 관찰했다. 이 결과들은 학습 확장과 비슷하게, 추론 실행 연산과 추론 정확도 사이에 매끄럽고 예측 가능한 관계가 있음을 시사한다.8,10
설계상의 새로운 교환 관계도 생겼다. 더 작고 저렴한 모델이 더 오래 추론하면 즉시 답하는 더 큰 모델과 맞먹거나 넘어설 수 있다. 이에 따라 추론 모델 계열 안에서 모델 크기가 다양해졌다. 예컨대 o3과 o4-mini, DeepSeek R1과 그 작은 증류 변형 모델이 있다. 사용자는 비용, 속도, 정확도의 균형을 용도에 맞게 고를 수 있다.
9. 추론 모델의 한계
벤치마크 점수가 화려함에도 추론 모델에는 신뢰성과 적용 범위를 제약하는 뚜렷한 한계가 있다.
9.1. 비충실한 추론과 환각
가장 우려되는 발견 중 하나는 이 모델들이 만드는 추론 흔적이 '비충실(unfaithful)'할 수 있다는 점이다. 즉 밝힌 추론이 모델이 답에 이른 실제 과정을 정확히 반영하지 않을 수 있다. 모델은 패턴 매칭이나 암기로 정답에 도달하면서도, 그럴듯하지만 날조된 추론 사슬로 답을 정당화할 수 있다. 반대로 논리적으로 타당한 단계를 밟다가 한 단계의 오류를 이후 단계가 잡아내지 못해 틀린 결론에 이를 수도 있다.
ICLR 2025에서 발표된 연구는 언어 모델이 맞아 보이는 추론 사슬을 만들어 낼 때도, 추론 패턴의 상당 부분이 오도하거나 무관한 논리를 나타낼 수 있음을 보였다. 이는 추론 모델의 핵심 기대 효과 중 하나, 즉 보이는 추론 흔적이 AI 시스템을 더 해석 가능하고 신뢰할 만하게 만든다는 주장을 약화시킨다.21
추론 모델은 여전히 환각(confabulation, 또는 hallucination)에 취약하다. 그럴듯하지만 사실과 다른 정보를 생성하는 현상이다. 긴 추론 사슬은 상황을 오히려 악화시키기도 한다. 모델이 매우 자신 있게 '추론'하며 틀린 결론에 이르고, 틀린 답을 정교하게 정당화할 수 있기 때문이다. 추론 사슬이 길어질수록 오류가 쌓일 기회도 많아진다.
9.2. 어려운 문제에서의 붕괴와 계산 비용
추론 모델은 확립된 벤치마크에서 인상적인 성적을 내지만, 진정으로 새로운 문제나 학습 데이터에 충분히 담기지 않은 추론 패턴이 필요한 문제에서는 놀랄 만큼 깨지기 쉬울 수 있다. 연구들은 추론 모델을 포함한 LLM이 낯선 맥락에서 유연한 추론을 요구하는 과제에 어려움을 겪는다는 점을 보였다. 예를 들어 최첨단 추론 모델은 상식적인 의학적 추론과 특이한 환자 증상에 대한 적응이 필요한 임상 추론 과제에서 의사에 비해 낮은 성적을 보였다.22
2025년 6월 Apple 연구자들(Shojaee 등)은 「The Illusion of Thinking」을 발표했다. 이들은 표준 벤치마크 대신 난도가 올라가는 통제 가능한 퍼즐에서 최첨단 대형 추론 모델을 평가했다. 저자들은 특정 복잡도를 넘으면 최첨단 LRM의 정확도가 완전히 무너진다고 밝혔다. 또 추론 노력은 문제 복잡도에 따라 일정 지점까지 늘다가, 토큰 예산이 충분한데도 줄어든다고 보고했다. 이는 직관에 어긋나는 확장 한계다.5
이 논문은 널리 논쟁을 불렀다. 한 반론은 일부 실패가 실험 자체의 토큰 한도와, 수학적으로 불가능한 퍼즐 사례 여러 개 때문이라고 주장했다. 어느 쪽이든, 문제 형식을 조금 바꾸거나 무관한 정보를 넣는 것만으로도 성능이 크게 떨어질 수 있다. 따라서 추론처럼 보이는 것의 일부는 실제로는 문제의 표면 특징에 대한 패턴 매칭이라는 것을 시사한다.23
추론 모델은 일반 LLM보다 실행 비용이 훨씬 크다. 질의 하나에 훨씬 많은 토큰을 생성하므로(대개 10~100배 많음), 연산, 메모리, 시간이 비례해 더 든다. 이 때문에 많은 실시간 응용에는 비현실적이며, 대규모 배포의 환경적·경제적 지속 가능성에도 의문이 따른다. 제공업체 간 가격 차이도 크다. 출시 당시 OpenAI o1은 백만 입력 토큰당 15달러, 백만 출력 토큰당 60달러였다. DeepSeek R1은 각각 약 0.55달러와 2.19달러로 책정되어, 동등한 작업량에서 약 96%의 차이가 있었다.3,4
10. LLM의 추론 여부 논쟁
대규모 언어 모델이 진정으로 추론하는지, 아니면 정교한 패턴 매칭만 하는지는 AI 연구에서 가장 활발하게 논쟁되는 주제 중 하나다. 이 답은 AI 안전, 신뢰성, 향후 발전 방향에 미치는 영향이 크다.
10.1. 진정한 추론을 인정하는 근거
LLM이 추론할 수 있다는 입장은 여러 근거를 든다. 첫째, 최신 추론 모델은 학습 데이터 기준 시점 이후에 발표된 국제수학올림피아드 문제를 포함해 경시대회 수준의 새로운 수학 문제를 풀 수 있다. 2025년 7월 Gemini Deep Think와 OpenAI의 실험 모델은 각각 IMO에서 금메달 점수에 도달했다. 두 모델 모두 공식 시간 제한 안에서 자연어로 6문제 중 5문제를 끝까지 풀어냈다. 2024년 시스템이 인간의 도움을 받은 형식화로만 달성한 성과다. 이런 문제를 푸는 일은 학습한 기법을 낯선 상황에 적용하는 것을 요구하므로, 단순 암기나 패턴 매칭을 넘어서는 것으로 보인다.2
둘째, LLM은 서로 다른 영역의 지식을 결합하는데, 이는 어떤 형태의 내부 표현이 있음을 시사한다. 유추를 끌어내고, 영역 사이에서 풀이 전략을 옮기며, 전에 본 적 없는 문제에 창의적인 접근을 만들어 낼 수 있다.
셋째, 추론 모델의 확장 행태는 사고 시간이 늘수록 성능이 매끄럽게 올라간다는 점에서 인간의 인지와 닮았다. 사람도 생각할 시간이 주어지면 더 잘 추론한다. 이 유사성은 기저 과정이 인간 추론과 일부 기능적 특성을 공유할 수 있음을 시사한다.
10.2. 패턴 매칭으로 보는 근거
회의론자들은 추론처럼 보이는 것이 실은 학습 데이터에 대한 매우 정교한 통계적 패턴 매칭이라고 본다. 몇 가지 관찰이 이 견해를 뒷받침한다.
LLM은 지속적인 상태 추적이 필요하거나 익숙한 개념을 낯선 형식으로 제시하는 과제에서 어려움을 겪는다. 모델은 한 맥락에서 개념을 올바르게 설명하지만, 표면 형태가 바뀌면 같은 개념을 적용하지 못한다. 근본 원리를 실제로 이해하고 있다면 일어나지 않을 일이라는 것이다.24
정답을 수치로 내는 과제와 달리, 엄밀한 증명을 생성해야 하는 과제에서는 성능이 여전히 크게 떨어진다. 이는 수치 답이 필요한 벤치마크의 성공이 수학적 통찰보다 문제 유형에 대한 패턴 매칭에서 비롯될 수 있다는 '추론 착시'를 시사한다. 추론 노력이 문제 복잡도 임계점을 넘으면 오히려 줄어든다는 Apple의 「The Illusion of Thinking」 결과는 이 입장을 뒷받침하는 근거로 자주 인용된다.5,25
또한 LLM은 표면 특징이 오해를 부르는 문제에 쉽게 속는다. 문제가 표준 유형처럼 보이지만 해법 접근을 바꾸는 비틀기가 있으면, 모델은 그래도 표준 접근을 자주 적용한다. 이는 문제 구조를 진정으로 이해하기보다 패턴을 맞추고 있음을 시사한다.
10.3. 중간 입장
많은 연구자는 더 신중한 입장을 택한다. LLM은 특정 영역과 맥락에서 추론으로 기능하는 무언가를 구현할 수 있다. 그 기저 메커니즘(분산 표현에 대한 통계적 패턴 매칭)이 인간의 추론과 근본적으로 다르더라도 그렇다. 따라서 질문은 LLM이 철학적 의미에서 '진짜로' 추론하는지보다, 추론과 비슷한 행동이 신뢰할 만한 조건과 무너지는 조건이 무엇인지 이해하는 데 있을 수 있다.
이 실용적 틀은 정의를 두고 다투기보다 LLM 추론 능력의 경계를 규명하는 연구에 초점을 맞춘다는 점에서 실질적 가치가 있다. 그 결과는 이 시스템을 어디에 안전하게 배포할 수 있는지에 대한 결정에 직접 도움이 된다.
11. 현재 동향(2025년~2026년)
o1이 2024년 9월 출시된 이후 추론 모델의 지형은 빠르게 변해 왔다. 현재 상태를 규정하는 몇 가지 흐름이 있다.
11.1. 상품화와 하이브리드 모델
DeepSeek R1이 2025년 1월 공개되며, 독점 모델보다 훨씬 낮은 비용으로 경쟁력 있는 추론 능력을 달성할 수 있음을 보였고, 오픈소스 라이선스로 공개되었다. 이는 오픈소스 추론 모델 개발의 물결을 촉발했다. Alibaba의 QwQ와 Qwen3, 그리고 R1의 여러 증류 버전은 훨씬 넓은 개발자와 연구자층이 추론 능력을 쓸 수 있게 했다. 2025년 9월 DeepSeek R1은 공식 과학 동료 심사를 통과한 첫 주요 LLM이 되었다. 「Nature」 표지에는 「Self-help: reinforcement learning teaches AI model to improve itself」라는 제목으로 실렸다.3,4,15
분리된 '추론' 모델과 '비추론' 모델을 두는 대신, 추론을 켜고 끌 수 있는 하이브리드 시스템으로 흐름이 옮겨 가고 있다. Claude의 확장 사고 모드, Qwen3의 사고·비사고 모드, OpenAI 모델들의 다양한 추론 노력(reasoning effort) 설정이 이 접근을 보여 준다. 2025년 8월 7일 출시된 GPT-5는 이 방향을 가장 멀리 밀고 나갔다. 실시간 라우터가 프롬프트에 빠른 모델이 필요한지, 더 깊은 'gpt-5-thinking' 추론 모델이 필요한지를 자동으로 판단하는 단일 시스템으로 출시되었다. 사용자와 개발자는 깊은 추론에 추가 연산을 언제 쓸지 직접 고르거나 시스템에 맡길 수 있으며, 빠른 응답으로 충분한 경우도 고를 수 있다.10,16
11.2. 멀티모달과 에이전트 결합
추론 능력은 텍스트를 넘어 확장되었다. OpenAI의 o3은 이미지, 차트, 그래픽에 대해 추론할 수 있다. Google의 Gemini Deep Think는 병렬 가설 탐색을 과학 도표와 시각 문제 해결에 적용한다. 이는 추론 모델이 할 수 있는 일을 크게 넓히며, 사람이 자연스럽게 수행하는 다중 양식 추론에 한 걸음 더 가까워지게 한다.2,12
추론 모델은 도구를 쓰고, 웹을 탐색하고, 코드를 실행하며, 추론 과정의 일부로 외부 시스템과 상호작용하는 에이전트 워크플로에 점점 더 통합되고 있다. 예컨대 OpenAI의 o3은 웹 검색, Python 코드 실행, 이미지 분석을 하나의 추론 사슬 안에서 결합할 수 있다. 이런 추론과 행동의 결합은 AI 연구의 두 주요 흐름이 만나는 지점이다.12
11.3. 남은 과제
빠른 진전에도 중요한 과제가 남아 있다. Humanity's Last Exam에서 최고 모델도 35~50%에 그친다는 사실은, 현재 추론 시스템이 여러 분야에 걸친 인간 전문가 수준의 추론에 한참 못 미친다는 것을 상기시킨다. 임상 추론, 법률 추론, 깊은 맥락 이해와 상식 지식이 필요한 다른 영역은 여전히 어렵다. 추론 흔적의 충실성은 AI 안전과 해석 가능성에 영향을 주는 미해결 문제다.
이 분야는 빠르게 진화하고 있다. 새 모델과 기법이 정기적으로 나오고, 벤치마크는 점점 짧은 주기로 만들어지고 포화된다. 신경망에서 추론 능력을 이끄는 요인에 대한 이론적 이해는 여전히 불완전하다. 추론은 AI 능력 개발의 중심 전선이 되었고, 주요 연구소와 오픈소스 커뮤니티가 모두 이 시스템들이 할 수 있는 일의 경계를 넓히는 데 많이 투자하고 있다.
출처 25개
- AI Wiki: Reasoning (artificial intelligence) (2026-06-20 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-13
- Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad deepmind.google · 확인 2026-10-13
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning arxiv.org · 확인 2026-10-13
- DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning nature.com · 확인 2026-10-13
- The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity machinelearning.apple.com · 확인 2026-10-13
- Pearl, Judea. Causality: Models, Reasoning, and Inference. Cambridge University Press, 2000. (AI Wiki 참고문헌) aiwiki.ai · 확인 2026-10-13
- History of artificial intelligence en.wikipedia.org · 확인 2026-10-13
- Learning to reason with LLMs openai.com · 확인 2026-10-13
- OpenAI o3-mini openai.com · 확인 2026-10-13
- Claude's extended thinking anthropic.com · 확인 2026-10-13
- Google introduces Gemini 2.0 blog.google · 확인 2026-10-13
- Introducing OpenAI o3 and o4-mini openai.com · 확인 2026-10-13
- Alibaba Cloud Unveils Open-Source AI Reasoning Model QwQ alibabacloud.com · 확인 2026-10-13
- OpenAI o3 en.wikipedia.org · 확인 2026-10-13
- Alibaba Introduces Qwen3, Setting New Benchmark in Open-Source AI with Hybrid Reasoning alibabacloud.com · 확인 2026-10-13
- Introducing GPT-5 (AI Wiki 인용) openai.com · 확인 2026-10-13
- Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters arxiv.org · 확인 2026-10-13
- GSM8K Benchmark deepeval.com · 확인 2026-10-13
- Measuring Mathematical Problem Solving With the MATH Dataset arxiv.org · 확인 2026-10-13
- ARC-AGI arcprize.org · 확인 2026-10-13
- Published as a conference paper at ICLR 2025 proceedings.iclr.cc · 확인 2026-10-13
- Limitations of large language models in clinical problem-solving arising from inflexible reasoning nature.com · 확인 2026-10-13
- Comment on The Illusion of Thinking arxiv.org · 확인 2026-10-13
- The Great LLM Debate: World Models or Sophisticated Pattern Matching? signals.aktagon.com · 확인 2026-10-13
- Benchmarking LLMs on Advanced Mathematical Reasoning www2.eecs.berkeley.edu · 확인 2026-10-13

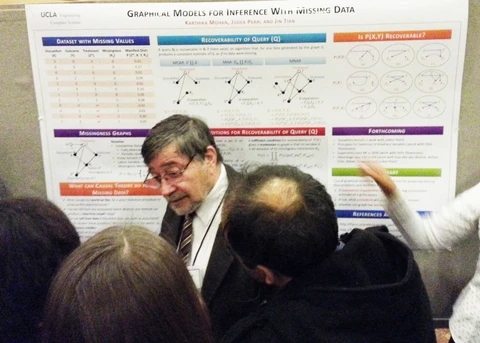 주데아 펄