스탠퍼드대 연구진 Owen Queen과 James Zou가 대규모 언어 모델을 다룬 널리 인용된 연구 결과 50개를 최신 모델 20개로 다시 시험했더니 44%가 이미 효력을 잃은 것으로 나타났다. 모델이 이런 것을 못 한다는 식의 결론은 새 모델이 나오면 금방 틀리게 되므로, 논문 속 모델 약점을 현재 모델에 그대로 적용하기 어렵다는 뜻이다.
연구진은 2024년 7월부터 2026년 9월 사이에 8개 개발사가 낸 모델을 썼다. 수명을 추정할 수 있었던 22개 결과의 평균 수명은 15.7개월이었다. 공개 후 1년이 지나면 16%가, 2년이 지나면 39%가 효력을 잃었다.1
| 상태 | 비율 |
|---|---|
| 효력 상실(원래 효과가 대부분 사라짐) | 44% |
| 크게 약해짐 | 34% |
| 여전히 유효 | 16% |
| 오히려 강해짐 | 6% |
못 하는 일에 관한 결론이 가장 빨리 낡았다
추론 관련 결과 9개 중 5개가 효력을 잃었고, 유효하거나 강해진 것은 하나도 없었다. 이 9개 결과가 다루는 대표적인 약점으로는 'strawberry'의 글자 수 세기, 낯선 진법의 산술, 긴 문맥 중간의 정보 놓치기, 사용자가 반박하면 맞는 답을 포기하는 문제가 있다. 연구진은 이런 오류에는 정답이 분명해서 개발사가 학습 목표를 잡기 쉽다고 추정했다.
선호와 성향에 관한 결과는 더 오래 갔다. 유효하거나 강해진 11개 가운데 3개는 모델이 평가자로 일할 때의 행동이다. 모델은 자기 답변을 더 좋게 보고, 채택된 논문과 거절된 논문을 비슷하게 평가하며, 의학 초록의 수사에 점수가 흔들린다. 다른 3개는 사용자에게 동조하는 아첨 경향이다. 왼쪽으로 기운 정치 성향, 열린 질문에 거의 같은 답을 내는 경향, 난수를 뽑을 때 고르지 않은 분포도 남아 있었다.1
가짜 참고문헌 사례
연구진은 환각 가운데 존재하지 않는 학술 인용을 사례로 골랐다. 2023년 Walters와 Wilder의 원 연구에서 GPT-3.5는 참고문헌의 55%를 지어냈다. 그 연구는 학부 작문 수준의 보고서 주제 42개로 ChatGPT가 낸 참고문헌 636건을 조사했고, GPT-3.5는 222건 중 55%, GPT-4는 18%가 가짜였다.1,2
스탠퍼드 연구진이 같은 프롬프트를 최신 모델에 넣자 GPT-6.1 Sol은 0%, Claude Sonnet 5.5는 1%를 지어냈다. 같은 2026년 모델인 Qwen3.7-Flash는 69%를 지어냈다.
연구는 이를 안심해도 된다는 신호로 읽지 말라고 경고한다. 두 가지 사실을 결합해야 하는 2단계 질문에서 Claude Sonnet 5.5는 개별 질문 두 개를 모두 맞힌 경우의 약 10%에서 여전히 틀린다. 이 질문 유형을 다룬 원 논문은 앞서 소개한 Walters·Wilder 연구와는 다른 논문이며, ChatGPT에서 43%를 보고했다. 'Reversal Curse'와 시간 관련 짝 질문의 모순 답변도 약해졌지만 여전히 관찰된다.
사회적 편향은 항목마다 달랐다. 왼쪽으로 기운 정치 성향은 남아 있고, 성별 고정관념과 암묵적 연상 편향은 약해졌다. 아프리카계 미국인 영어 화자에 대한 편향은 추세 데이터에서 방향이 뒤집혔다.1
같은 시기 모델끼리도 차이가 크다
2026년 7월부터 9월 사이에 나온 모델만 비교해도 효력을 잃은 결과의 수는 DeepSeek V4 Pro의 11개부터 GPT-6.1 Sol의 30개까지 벌어졌다. 출시일, 개발사, 모델 크기 어느 것도 이 패턴을 믿을 만하게 예측하지 못했다.
Queen과 Zou는 LLM에 관한 실증 결과를 보편적 진리가 아니라 특정 시점의 특정 모델에 대한 관찰로 제시해야 한다고 결론지었다. 논문에는 모델, 버전, 날짜를 적고, 프롬프트와 분석 코드를 공개해 이후 모델로 다시 시험할 수 있게 하라는 제안이다.
연구진은 LLM의 실제 행동에 대한 인식 격차가 AI에 대한 신뢰와 사용 빈도에 영향을 준다고 쓴 Andrej Karpathy의 글을 언급했다. Karpathy는 OpenAI 공동 창업자로, 이후 Anthropic에 합류했다.
독자가 읽는 LLM 연구 가운데 상당수는 이미 지난 세대 모델의 기록일 수 있다. 정답이 분명한 오류는 개발사가 학습 목표를 잡기 쉬워 빨리 사라진다는 연구진의 추정대로라면, 오래된 논문의 한계 목록을 지금 쓰는 모델에 대입하기보다 모델 이름과 시험 날짜를 먼저 확인하는 편이 안전하다. 반대로 아첨, 평가자 편향, 정치 성향처럼 정답이 없는 경향은 최신 모델에도 남아 있었다. 같은 시기 모델 사이의 차이도 커서, 사용할 모델로 직접 시험해 보는 일이 중요하다.1
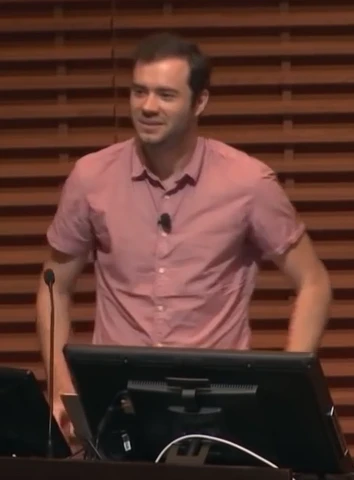 안드레이 카파시