쉽게 말하면, DeepSeek는 중국 항저우의 인공지능 회사로, 글을 이해하고 쓰는 대형 AI 모델인 대규모 언어 모델을 연구한다. 내려받을 수 있는 모델 가중치를 배포하고, 소비자용 채팅 서비스와 개발자용 API도 운영한다.
| 개발 주체 | Hangzhou DeepSeek Artificial Intelligence Co., Ltd.2 |
|---|---|
| 본사 | 중국 항저우 |
| 설립 | 2023년, 량원펑(Liang Wenfeng)3 |
| 분류 | 인공지능 기업, 대규모 언어 모델 연구 |
| 대표 모델 | DeepSeek-R1(2025년 1월 공개)4 |
1. 개요
DeepSeek는 중국 항저우에 본사를 둔 인공지능 기업이다. 2023년 량원펑(Liang Wenfeng)이 세웠으며, 량원펑은 그 전에 정량 투자 회사 High-Flyer를 공동 창업했다. 회사의 현재 개인정보 처리방침에 적힌 법인명은 Hangzhou DeepSeek Artificial Intelligence Co., Ltd.다. DeepSeek는 대규모 언어 모델을 연구하고 공개하며, 내려받을 수 있는 모델 가중치를 배포하고, 소비자용 채팅 서비스와 API를 운영한다.2,3
2025년 1월 공개된 추론 모델 DeepSeek-R1이 중국 밖에서 널리 알려지는 계기가 됐다. R1은 상당 부분 강화 학습을 적용해 학습한 모델이다. DeepSeek는 기술 보고서와 모델 저장소를 공개하지만, 회사, 호스팅 서비스, 개별 모델 출시는 서로 다른 대상이다. 그래서 어떤 모델의 구조, 라이선스, 학습 과정, 벤치마크 결과에 관한 주장이 회사 전체나 DeepSeek의 모든 제품에 자동으로 적용되는 것은 아니다.
DeepSeek는 High-Flyer의 인공지능 연구에서 출발했다. 로이터가 검토한 공개 기업 기록에 따르면 2025년 초 량원펑이 DeepSeek의 지배 주주로 확인됐으며, High-Flyer는 DeepSeek에 자금을 대고 연구 인력과 컴퓨팅 기반 시설을 제공했다. 이 관계는 DeepSeek의 출발점을 설명하지만, High-Flyer와 DeepSeek는 서로 바꿔 쓸 수 있는 이름이 아니다.5
2. 기업 연혁과 자금 조달
High-Flyer는 2015년에 설립됐고 정량 거래에 머신러닝을 썼다. 2019년에는 인공지능 연구 부서를 세웠다. 2021년에는 Nvidia A100 그래픽 처리 장치 약 1만 개로 이루어진 Fire-Flyer 2 클러스터를 만들었고, 2022년 7월 High-Flyer의 인공지능 부서는 위챗에서 A100 칩 1만 개로 된 클러스터를 소유하고 운영한다고 밝혔다. 량원펑은 2023년 인공지능 모델 연구에 집중하는 별도 회사로 DeepSeek를 세웠다.3,5
DeepSeek는 처음에 외부 투자를 공개하지 않은 채 운영됐다. 2026년에 이 상황이 바뀌었지만, 회사는 비상장 기업이고 감사받은 재무제표나 자세한 투자 문서를 공개하지 않아 재무 기록이 여전히 불완전하다.
로이터는 사안을 아는 사람들을 인용해 2026년 6월 DeepSeek가 약 74억 달러를 조달했고, 투자 후 기업가치가 약 4,500억 위안이라고 보도했다. 같은 보도는 량원펑, 텐센트, CATL 등이 투자에 참여했으며, DeepSeek가 기업가치 약 5,000억 위안으로 또 한 번의 투자 라운드와 본토 증시 상장을 검토하고 있다고 전했다. 로이터는 이번 계획된 라운드 규모를 최대 500억 위안으로 봤고, 5,000억 위안 기업가치는 약 740억 달러에 해당한다고 환산했으며, 기사 끝에 환율 주석 "1달러 = 6.7704위안"을 달았다.
완료된 6월 라운드에서 량원펑은 개인적으로 200억 위안을 냈고, 텐센트와 CATL은 각각 100억 위안과 50억 위안을 투자해 외부 최대 주주가 됐다. 보도는 중국 국가 인공지능 펀드, NetEase, JD.com, IDG Capital, Loyal Valley Capital, Monolith Management, Shixiang Capital도 투자자로 꼽았으며, 이 명단은 소식통과 언론 보도에 근거한 것이다. 로이터는 이 라운드와 상장 계획이 초기 단계이며 바뀔 수 있다고 강조했다.6
라운드가 마감되기 전인 6월 3일 로이터는 역시 익명 소식통을 인용해 투자 후 기업가치를 3,500억에서 4,000억 위안으로 볼 수 있다고 보도했다.
중국 증권거래소 공시는 간접적인 기업가치 신호를 제공했다. 한 펀드가 29억 위안을 투자해 간접 지분 0.8265%를 확보했다고 공시했고, 이는 3,508.8억 위안의 기업가치를 뜻하며 보도가 인용한 환율 기준으로 약 518억 2,000만 달러다. 로이터는 이 공시가 첫 외부 투자 라운드에 관한 드문 공개 증거라고 설명했으며, DeepSeek가 이를 발표하거나 자세히 밝히지 않았다고 전했다.7
7월 25일 로이터는 블룸버그 보도를 인용해 DeepSeek가 계획했던 두 번째 라운드를 중단했다고 전했다. 로이터는 이 보도를 독자적으로 확인할 수 없다고 밝혔고, 블룸버그의 소식통은 절차가 재개될 수 있다고 말했다.8
중단은 오래가지 않았다. 2026년 8월 6일 PYMNTS는 같은 날 블룸버그 보도를 인용해 DeepSeek가 두 번째 라운드를 재개했고, 기업가치 약 740억 달러 수준에서 80억 달러에 가까운 금액을 조달하려 한다고 전했다. 협의는 진행 중이며 바뀔 수 있다고 설명됐다.9
2026년 9월 9일 사우스차이나모닝포스트(South China Morning Post)는 이름을 밝히지 않은 두 명의 소식통을 인용해 DeepSeek가 CITIC Securities를 포함한 주관사 네 곳을 선임했다고 보도했다. 같은 보도는 올해 안에 상하이 증권거래소의 STAR Market(과창판) 상장 절차를 시작하는 것을 목표로 하며, 기업가치 약 5,000억 위안으로 볼 수 있는 상장 전 투자 라운드를 마무리하는 중이라고 전했다.10
이 수치는 모두 익명 소식통에 기댄 거래 추정치이며, 감사를 거친 현재 기업가치가 아니다. 보도들은 상장 자체가 아직 준비 단계라고 설명한다.
공개 정보로는 회사의 현재 매출, 이익, 지분 구조, 직원 수를 정확한 수치로 확인할 수 없다. DeepSeek의 모델 문서에 있는 수치는 엔지니어링 측정치이며, 회사 재무제표가 아니다.
3. 연구와 모델 출시
DeepSeek는 범용, 코딩, 수학, 비전 언어, 추론 모델을 출시했다.
| 시기 | 모델 또는 계열 | 주요 내용 |
|---|---|---|
| 2023년 11월 | DeepSeek LLM | 70억과 670억 매개변수 언어 모델 계열. 2조 토큰 규모의 말뭉치로 학습11 |
| 2024년 1월 | DeepSeek-Coder | 13억부터 330억 매개변수까지의 코드 모델. 프로젝트 단위 코드로 2조 토큰을 학습하고 16,000토큰 창을 사용12 |
| 2024년 5월 | DeepSeek-V2 | DeepSeekMoE와 멀티헤드 잠재 어텐션을 결합한 전문가 혼합 모델. 8.1조 토큰으로 학습13 |
| 2024년 12월 | DeepSeek V3 | 6,710억 매개변수 전문가 혼합 모델. 토큰마다 370억 매개변수 활성화14 |
| 2025년 1월 | DeepSeek-R1 | 추론 모델. 강화 학습만 적용한 실험 모델 R1-Zero와 증류 소형 모델을 함께 공개4 |
| 2025년 8월에서 12월 | DeepSeek V3.1, V3.2 | 호스팅 버전과 공개 가중치 버전이 잇따라 출시됨. API 변경 기록에 남아 있음15 |
| 2026년 4월 | DeepSeek V4 | 1.6조 매개변수 Pro 모델과 2,840억 매개변수 Flash 모델로 구성된 계열. 두 모델 모두 100만 토큰 컨텍스트 창 사용16 |
| 2026년 7월 | DeepSeek-V4-Flash-0731 | V4-Flash API의 공개 베타 정식 출시. DeepSeek는 프리뷰와 구조, 크기가 같고 사후 학습만 다시 했다고 밝힘 |
| 2026년 8월 | DeepSeek-V4-Pro-0813 | 앱, 웹, API 전반에 V4 Pro 정식 출시. 네이티브 Responses API 지원과 사고 강도 낮음, 높음, 최대 단계 추가 |
| 2026년 8월 | DeepSeek-V4-Flash-Vision-Exp | API에서만 제공하는 실험용 시각 이해 모델. 텍스트 과제에서는 V4-Flash와 맞먹는다고 DeepSeek가 설명15 |
| 2026년 9월 | DeepSeek V4.1-Flash | 5,520억 매개변수 백본의 멀티모달 전문가 혼합 모델. 100만 토큰 컨텍스트 창을 지원하며 MIT 라이선스 가중치 공개15,17 |
3.1. 아키텍처
DeepSeek-V2 이후 범용 모델은 전문가 혼합 설계를 쓴다. 토큰마다 모든 매개변수를 쓰지 않고, 라우팅 장치가 전문가 일부를 골라 쓴다. V2는 이 설계에 멀티헤드 잠재 어텐션을 더했고, 이 방식은 키-값 표현을 압축해 추론 실행 때 메모리 사용을 줄인다. V2 논문은 총 2,360억 매개변수 가운데 토큰마다 210억 매개변수를 활성화한다고 보고했다.13
V3는 멀티헤드 잠재 어텐션과 DeepSeekMoE를 유지하면서, 보조 손실 없이 전문가 사용량을 맞추는 방식, 다중 토큰 예측, 저정밀도 FP8 학습을 더했다. 논문은 총 6,710억 매개변수, 토큰마다 370억 매개변수 활성화, 14.8조 토큰 규모의 사전 학습을 보고했다. 이는 개발사가 보고한 구조와 학습 사양이며, 독립적으로 검증된 성능 지표가 아니다.14
V4는 규모와 어텐션 체계를 바꿨다. 기술 보고서는 V4 Pro를 토큰마다 약 490억 매개변수가 활성화되는 1.6조 매개변수 모델로, V4 Flash를 약 130억 매개변수가 활성화되는 2,840억 매개변수 모델로 설명했다. 보고된 사전 학습 말뭉치는 32조 토큰을 넘는다. 보고서는 DeepSeek 희소 어텐션(DeepSeek Sparse Attention), 다중 토큰 예측 목표, 다양체 제약 하이퍼 연결 방법, 수정된 Muon 옵티마이저를 설명한다. 논문과 공개된 체크포인트는 설계를 보여 주지만, 모든 과제와 배포 환경에서 가장 좋은 모델임을 입증하지는 않는다.16
3.2. V3 학습 비용 주장
자주 인용되는 557만 6,000달러(US$5.576 million)는 DeepSeek의 총 연구개발비, R1 개발비, 회사 전체 지출이 아니다. V3 논문은 공식 V3 학습 한 번에 H800 GPU 278만 8,000시간이 들었다고 보고했다. 논문은 이 시간에 H800 GPU 시간당 임대 가격 2달러를 곱해 557만 6,000달러를 산출했다. 논문은 앞선 연구와 절제 실험(ablation)의 비용을 명시적으로 제외한다.14
이 수치는 한 번의 문서화된 학습이 쓴 연산량을 이해하는 데 쓸모가 있다. 하지만 인건비, 데이터 준비, 실패한 실험, 하드웨어 확보, 추론 실행, 이전 모델 개발에 든 비용을 포함한 추정치와는 직접 비교할 수 없다. DeepSeek는 V3나 R1 개발에 든 감사받은 총비용을 공개하지 않았다.
3.3. R1과 강화 학습
R1 연구 과정은 서로 관련된 두 시스템으로 나뉘었다. DeepSeek-R1-Zero는 기초 모델에서 시작해 대규모 강화 학습만으로 학습했고, 지도 미세 조정 단계는 거치지 않았다. DeepSeek는 이 실험에서 검증이나 더 긴 추론 같은 행동이 나타났지만 가독성과 언어 혼용 문제도 생겼다고 밝혔다. 정식 R1 학습 절차는 소량의 콜드 스타트 데이터, 추론 중심 강화 학습, 거부 샘플링, 지도 미세 조정, 마지막 강화 학습 단계를 더했다.
R1 논문은 2025년 9월 동료 심사를 거쳐 Nature에 실렸다. 논문은 학습 절차, 평가 설정, 한계, 안전성 시험을 기록한다. 동료 심사를 통과했다는 것은 연구 보고서가 학술지 심사 과정을 거쳤다는 뜻이며, 모든 벤치마크 결과, 호스팅 응답, 이후 DeepSeek 모델을 보증하지는 않는다.4
DeepSeek는 R1이 생성한 데이터로 Qwen 및 Llama 기반 모델을 지식 증류한 6개 소형 모델도 공개했다. 이 증류 모델은 전체 R1 모델과 체크포인트, 크기, 라이선스가 각각 다르다. 증류 모델의 결과를 R1의 결과인 것처럼 단순히 표시해서는 안 된다.
3.4. V4와 독립 평가
DeepSeek는 2026년 4월 24일 V4 Pro와 V4 Flash의 프리뷰 공개를 발표했다. 기술 보고서는 두 모델을 코딩, 추론, 과학, 에이전트 벤치마크에서 다른 시스템과 비교했다. 이 표는 개발사가 직접 수행한 평가이며, 프롬프트, 추론 예산, 도구 연결 틀, 모델 버전, 벤치마크 노출 가능성에 따라 결과가 달라질 수 있다.16
미국 국립표준기술연구소(NIST) 산하 AI 표준혁신센터(CAISI)는 2026년 4월 V4 Pro를 독립적으로 평가했다. CAISI는 이 모델이 당시까지 자신들이 평가한 중화인민공화국 모델 가운데 가장 뛰어난 모델이라고 밝혔다. 평가는 선택한 사이버, 소프트웨어 엔지니어링, 자연과학, 추상 추론, 수학 과제 전반에서 이뤄졌다. 종합 방식으로 보면 V4는 비교에 쓰인 모델 최전선보다 약 8개월 뒤처졌다. CAISI는 또 시험한 벤치마크 7개 가운데 5개에서 V4가 GPT-5.4 mini보다 비용 효율이 높았다고 밝혔다. 7개 결과의 비용 차이는 53% 더 저렴한 쪽부터 41% 더 비싼 쪽까지 걸쳐 있었다. CAISI는 DeepSeek가 직접 공개한 벤치마크 결과가 CAISI 결과보다 유리하게 나타난다고 보고했다.18
이 결과는 한 평가 묶음과 한 서빙 구성에 따른 것이며, 보편적 순위가 아니다. 독립적인 비교를 제공하고 방법과 한계를 드러낸다는 점에서 쓸모가 있다.
3.5. V4.1-Flash
DeepSeek는 2026년 9월 10일 DeepSeek-V4.1-Flash를 공개했다. 모델 카드에 따르면 이 모델은 5,520억 매개변수 백본을 가진 멀티모달 전문가 혼합 모델이며, 최대 100만 토큰 컨텍스트 창을 지원한다. 구조는 40개 층의 인과적 인코더-디코더로, 20개 층의 인과적 인코더 뒤에 20개 층의 디코더가 이어진다. 카드는 이 구조 덕분에 입력 토큰마다 사전 채우기(prefill) 단계에서 약 80억 매개변수, 출력 토큰마다 디코딩 단계에서 약 160억 매개변수가 활성화된다고 밝혔다. 카드는 또 밀집 연산이 아니라 해시 조회로 접근하는 1,960억 매개변수 규모의 Engram 조건부 메모리도 나열한다. 저장소와 가중치는 MIT 라이선스를 따른다.17
DeepSeek의 같은 날짜 API 변경 기록에 따르면 호스팅 모델 이름은 deepseek-flash가 됐다. 이전 이름인 V4-Flash와 V4-Flash-Vision-Exp는 종료되고 새 모델로 연결됐으며, 이 출시와 함께 API 가격도 인하됐다. 같은 기록은 사용자 요구에 따라 V4 Pro의 API 서비스를 2026년 9월 14일 이후에도 요금 변경 없이 계속 제공한다고 밝혔다. 벤치마크 표는 이전 출시와 마찬가지로 DeepSeek가 직접 작성했다.15,19
3.6. 에이전트 학습 인프라
DeepSeek는 에이전트 강화 학습(RL) 학습과 평가에 쓰는 샌드박스를 내부 플랫폼 DeepSeek Elastic Compute(DSec)에서 운영한다. V4 기술 보고서는 2026년 4월 DSec를 회사의 3FS 분산 파일 시스템 위에 만든 실서비스용 샌드박스 플랫폼으로 소개했다. 보고서에 따르면 함수 호출, 컨테이너, Firecracker 마이크로VM, QEMU 완전 가상 머신을 하나의 Python SDK로 제공한다.16
2026년 9월 19일 arXiv에 게시된 별도 보고서는 DSec가 V3.2부터 V4.1까지 RL 학습과 평가에 쓰인 모든 샌드박스 작업을 처리했다고 밝혔다. 운영 규모 단위 하나는 노드 약 160개로 구성되며 하루 약 300만 개의 샌드박스를 제공한다. 최고 동시 실행은 약 38만 개이고, 샌드박스 생성은 초당 5,000개를 넘는다. 이 수치는 DeepSeek가 직접 밝힌 운영 수치다.
4. 비용과 효율 전략
DeepSeek가 모델에 관해 공개하는 자료의 상당 부분은 모델을 실행하는 비용과 관련이 있다. 캐시 크기, 토큰당 활성 매개변수, 희소 어텐션, 반복된 가격 인하가 그 예다. 이것이 의도된 경쟁 전략인지는 해석의 문제다. 다만 공개된 수치는 확인할 수 있으며, 모두 같은 방향을 가리키지는 않는다.
가장 직접적인 1차 자료는 DeepSeek가 V4.1-Flash 출시 자료에 그림으로 공개한 토큰당 전역 키-값 캐시 크기다. 그림의 값은 아래 표와 같다.
| 모델 | 그림에 적힌 날짜 | 토큰당 전역 키-값 캐시 |
|---|---|---|
| DeepSeek-V1 | 2023.11 | 389,120바이트 |
| DeepSeek-V3.2 | 2025.12 | 48,068바이트 |
| DeepSeek-V4-Flash | 2026.04 | 3,514바이트 |
| DeepSeek-V4.1-Flash | 2026.09 | 890바이트 |
V4.1-Flash 모델 카드는 같은 890바이트를 제시하며, 이 감소가 V4-Flash 대비 약 4배, V1 대비 약 437배라고 설명한다. 이 값은 DeepSeek가 자체 서빙 스택에서 측정한 특정 수치이며 독립적으로 재현된 결과가 아니다. 전역 키-값 캐시는 전체 캐시 메모리보다 좁은 개념이다. 카드는 별도로 지속 캐시 점유량이 V4-Flash의 약 8분의 1로 줄었다고 보고했는데, 이는 다른 양에 대한 다른 비율이다. 변경 기록의 날짜는 그림의 라벨과 맞는다. DeepSeek-V3.2는 2025년 12월 1일, V4-Flash는 2026년 4월 24일 API에 올라왔다.15,17,20
가격도 같은 방향으로 움직였으며, 이 내용은 API 변경 기록에 있다. DeepSeek는 2024년 8월 디스크 기반 컨텍스트 캐싱을 추가하면서 가격이 또 한 차수 낮아진다고 설명했다. V4 정식 출시와 함께 피크와 비피크 요금제를 도입했고, 비피크 요금은 피크 요금의 절반으로 2026년 8월 16일 16:00 UTC부터 적용됐다. V4.1-Flash 출시 때는 가격을 다시 낮췄다.15
2026년 9월 11일 목록에 적힌 피크 시간 요금은 다음 표와 같다.
| 모델 | 입력(백만 토큰당) | 출력(백만 토큰당) | 캐시 입력(백만 토큰당) |
|---|---|---|---|
| deepseek-flash | 0.30달러 | 1.20달러 | 0.006달러 |
| deepseek-v4-pro | 1.32달러 | 3.96달러 | 0.044달러19 |
피크 시간은 평일 UTC 01:00에서 04:00까지와 06:00에서 10:00까지이며, 그 밖의 시간은 절반 가격의 비피크 요금이 적용된다.19
독립 측정은 더 엇갈린 그림을 보여 준다. Artificial Analysis는 지능 지수 버전 4.3(2026년 9월 11일 조회)에서 V4.1-Flash에 40점, V4-Pro-0813에 36점을 매겼다. 지수 과제당 가중 비용은 각각 0.27달러와 0.67달러였다. 이 기관은 지수 전체에서 V4.1-Flash가 출력 토큰 2억 5,000만 개를 생성했다고 기록했다. 비교 집단의 중앙값은 1억 4,000만 개였다. 기관은 이 모델을 매우 장황하다고 평가하면서도, 같은 규모의 공개 가중치 모델치고는 빠르고 가격이 합리적이라고 설명했다.21,22
Artificial Analysis는 지수에 버전을 두며, 서로 다른 버전에서 나온 점수는 비교할 수 없다. 따라서 이 기관의 수치를 인용할 때는 버전과 조회일을 함께 적어야 한다.
반대 방향의 증거도 있다. 앞서 본 CAISI 평가에서 V4 Pro는 시험한 7개 벤치마크 중 5개에서만 GPT-5.4 mini보다 저렴했고, 전체 차이는 53% 저렴한 쪽에서 41% 비싼 쪽까지 걸쳐 있었다. 이 증거에 따르면 비용 우위는 벤치마크마다 달랐고, 전체 능력에서는 격차가 있었다.18
저렴한 서빙이 저렴한 개발을 뜻하지도 않는다. 앞서 본 V3 학습 비용 논의처럼, DeepSeek의 가장 많이 인용되는 비용 수치는 한 번의 학습에서 임대한 연산만 담고 앞선 연구, 절제 실험, 인건비, 하드웨어는 제외한다. DeepSeek가 비용에 관해 공개하는 것은 엔지니어링 측정치와 가격표이며, 감사받은 재무 공시와는 다르다.
5. 제품과 배포 경로
내려받는 모델과 호스팅 서비스는 같은 제품이 아니다. 내려받은 체크포인트는 이를 배포하는 사람이나 조직이 운영한다. 호스팅 서비스는 DeepSeek의 이용 약관, 개인정보 처리방침, 이용 가능 규칙, 콘텐츠 통제, 모델 라우팅 아래에서 운영된다. 2026년 4월 프리뷰에서 DeepSeek는 V4 Pro와 V4 Flash를 공식 저장소에 올리고, V4를 100만 토큰 컨텍스트 창과 함께 채팅 서비스와 API에 넣었다. API 변경 기록에 따르면 기존 deepseek-chat과 deepseek-reasoner 서비스는 V4 엔드포인트로 전환된 뒤 2026년 7월 24일 종료됐다.15,23
DeepSeek의 이용 약관은 사용자가 결과물을 쓰기 전에 검토해야 하고, 개인에게 실질적 영향을 미치는 결정에는 사람의 검토가 필요하며, 여러 범주의 불법·유해 사용을 금지한다고 규정한다. 약관은 또 회사가 출력과 서비스의 정확성, 완전성, 보안, 중단 없는 이용 가능성을 보장하지 않는다고 밝힌다. 이 조항들은 DeepSeek와의 서비스 관계에 적용된다. 따로 내려받은 모델의 기술적 동작이나 라이선스를 바꾸지는 않는다.24
현행 개인정보 처리방침은 서비스가 계정 정보, 입력 프롬프트, 업로드 파일, 대화 기록, 피드백, 기기와 네트워크 정보, 대략적 위치, 결제 정보를 수집할 수 있다고 밝힌다. 서비스를 통해 수집된 정보는 중화인민공화국의 서버에 저장된다고 적혀 있다. 방침은 또 사용자가 입력 내용을 모델 학습에 쓰지 않도록 거부할 수 있다고 설명한다. 로컬 배포는 프롬프트가 DeepSeek 호스팅 서비스로 전송되는 것을 피할 수 있다. 다만 실제 개인정보 보호 수준은 로컬 운영자, 소프트웨어 스택, 로그 기록, 인프라에 달려 있다.2
6. 라이선스와 개방성
DeepSeek는 많은 출시를 오픈소스라고 설명하지만, 더 정확한 표기는 출시마다 다르다. 공개 가중치는 학습된 매개변수를 내려받을 수 있다는 뜻이다. 그 자체로 학습 데이터, 완전한 데이터 처리 파이프라인, 소스 코드, 모델을 재현하는 데 필요한 모든 구성 요소가 공개된다는 뜻은 아니다.
DeepSeek-V3가 이 차이를 보여 준다. 저장소 코드는 MIT 라이선스를 따르지만, 모델 가중치에는 상업적 이용을 허용하면서 이용 제한을 둔 별도의 DeepSeek 모델 라이선스가 적용된다. R1 저장소와 전체 R1 가중치는 MIT 라이선스다. 증류 체크포인트는 원천이 된 Qwen 또는 Llama 기반 모델의 라이선스도 따른다. V4 Pro와 Flash의 모델 카드는 두 모델을 MIT 라이선스로 지정했다.25,26,27
Open Source Initiative의 오픈소스 AI 정의는 AI 시스템을 사용, 연구, 수정, 공유할 자유를 핵심으로 보며, 수정에 가장 알맞은 형태로 접근할 수 있어야 한다고 요구한다. 여기에는 코드와 매개변수뿐 아니라 학습 데이터에 관한 충분한 정보도 포함된다. 이 기준에서는 내려받을 수 있는 가중치 파일만으로는 오픈소스 AI라고 하기에 충분하지 않다. 그래서 이 문서는 검증 가능한 사실이 가중치 공개일 때 공개 가중치라고 쓰고, 모델별 라이선스는 따로 적는다.28
DeepSeek의 기술 보고서는 아키텍처, 최적화 방법, 데이터 규모, 평가 절차를 공개한다. 하지만 여기서 다루는 범용 모델의 사전 학습 말뭉치 전체나 완전히 재현 가능한 종단 간 학습 파이프라인은 공개하지 않는다.
7. 반응과 영향
DeepSeek의 소비자 앱은 R1 출시 직후인 2025년 1월 27일 미국 애플 무료 iPhone 앱 차트 1위에 올랐다. 같은 날 Nvidia 주가는 인공지능 지출에 노출된 기술 기업들의 더 넓은 매도 속에서 17% 떨어졌다. Associated Press 보도는 경쟁 모델이 더 적은 연산 지출로 만들어지거나 운영될 수 있다는 투자자 우려를 전했다. 같은 보도는 DeepSeek 비용 주장의 비교 가능성과 완전성에 불확실성이 있다고도 지적했다.29
연구자들은 시장 반응과 별개로 R1에 관심을 보였다. Nature는 과학자들이 모델의 추론 행동을 시험하고 학습 방식을 검토하고 있다고 보도했다. 이 매체는 R1을 완전히 재현 가능한 오픈소스 시스템이 아니라 공개 가중치 모델로 묘사했다. 이후 동료 심사를 거친 논문은 연구자들에게 학습 절차에 대한 더 완전한 설명을 제공했다.4,30
이 공개물들은 밀집 모델의 크기를 키우거나 특정 금액을 쓰면 능력이 따라온다는 단순한 주장을 어렵게 만들었다. DeepSeek의 작업은 희소 전문가 라우팅, 압축된 어텐션, 강화 학습, 증류의 실용적 가치에 대한 근거를 제공했다. 그러나 연산, 데이터 품질, 하드웨어, 엔지니어링이 더는 중요하지 않다는 것을 보여 준 것은 아니다. 예를 들어 V4는 V3보다 훨씬 크고, 보고된 학습 토큰 수가 두 배를 넘는 데이터로 학습됐다.14,16
8. 개인정보, 보안, 규제 대응
2025년 1월 클라우드 보안 기업 Wiz는 인증 없이 인터넷에서 접근할 수 있는 DeepSeek ClickHouse 데이터베이스를 찾았다고 보고했다. Wiz는 이 데이터베이스가 채팅 기록, API 관련 정보, 운영 메타데이터를 포함한 로그 100만 건 이상을 노출했다고 밝혔다. 연구진은 발견 사실을 DeepSeek에 알렸고, 곧 보안 조치가 이뤄졌다고 보고했다. 이 보고는 당시 노출된 시스템을 기록한 것이며, 현재 모든 배포에 같은 결함이 있다는 것을 입증하지는 않는다.31
여러 정부와 규제 기관이 법적 범위가 다른 조치를 취했다.
- 이탈리아 개인정보 보호 당국은 명령서에서 설명한 처리 행위가 불법이라고 선언했고, 긴급하게 이탈리아에 있는 사람들의 개인정보 처리를 확정적으로 제한하라고 명령했다. 제한은 2025년 1월 30일 명령서를 받은 즉시 발효했으며, 당국은 조사가 끝날 때까지 추가 결정을 유보했다. 이 조치는 이탈리아 이용자 데이터에 적용되며, 모델 내려받기를 전 세계적으로 금지한 것은 아니다.
- 한국 개인정보보호위원회는 2025년 2월 앱 다운로드가 중단된 뒤 서비스를 조사했다. 4월에 위원회는 DeepSeek가 사용자 입력과 기기, 네트워크, 앱 정보를 적절한 법적 근거나 필요한 고지 없이 해외로 이전했다고 밝혔다. 위원회는 DeepSeek가 4월 10일 Volcano Engine으로의 사용자 입력 전송을 중단했다고 설명했고, 기존에 이전된 입력의 파기와 보호 장치 개선을 포함한 시정 조치를 명령했다.
- 호주 보호 보안 정책 프레임워크 지침 001-2025(Direction 001-2025)은 연방 정부 기관이 정부 시스템과 기기에서 DeepSeek 제품의 사용과 설치를 막고 기존 설치를 제거하도록 요구했다. 이 지침은 호주 정부 기술에 적용되며, 호주 내 민간 이용을 일반적으로 금지하는 것이 아니다.32,33,34
이 조치들은 호스팅 애플리케이션, 데이터 처리, 정부 시스템에 관한 것이다. 모든 관할권에서 모델 내려받기를 반드시 금지하는 것은 아니다. 배포를 검토하는 기관은 적용되는 모델 라이선스, 데이터 흐름, 보안 구성, 현지 법을 따로 평가해야 한다.
9. 평가의 한계와 쟁점
DeepSeek의 기술 논문은 개발사가 자체 벤치마크를 돌린 결과를 보고한다. 이런 결과는 정보가 될 수 있지만 독립 평가와 바꿔 쓸 수는 없다. 프롬프트 템플릿, 추론 예산, 도구 접근, 샘플링, 데이터 오염, 서빙 하드웨어, 이후 체크포인트 업데이트가 측정 성능을 바꿀 수 있다. CAISI의 V4 평가는 DeepSeek 자체 보고 표보다 종합 비교가 불리하게 나왔지만, 여러 시험 과제에서는 여전히 경쟁력 있는 능력과 비용을 보였다.18
호스팅 서비스의 동작은 내려받은 가중치와도 구분해야 한다. 서비스는 DeepSeek의 약관과 콘텐츠 규칙 아래에서 운영되지만, 공개 가중치 체크포인트의 주변 소프트웨어는 로컬 운영자가 통제한다. 어느 쪽도 사실에 맞는 출력을 보장하지 않는다. DeepSeek의 개인정보 처리방침은 생성된 정보가 불완전하거나 부정확하거나 오래됐을 수 있다고 특별히 경고한다.2
9.1. 증류 의혹
2025년 1월 OpenAI와 한 미국 정부 자문관은 DeepSeek가 OpenAI 시스템의 출력을 증류를 통해 모델 개선에 썼을 것으로 의심한다고 밝혔다. Associated Press는 당시 어느 쪽도 구체적 증거를 공개하지 않았고, DeepSeek가 논평 요청에 응답하지 않았다고 보도했다. R1 논문의 동료 심사 과정에서 DeepSeek 저자들은 R1의 성능이 다른 대형 언어 모델의 추론 패턴 증류에 의존하지 않는다고 밝혔다. Nature는 2025년 9월 이 진술을 보도했으며, 이는 학습 데이터의 독립적 재구성이 아니라 저자들의 입장이었다.35,36
2026년 2월 Anthropic은 DeepSeek 계정과 연관된 조직적 캠페인이 Claude와 15만 건을 넘는 교환을 생성했다고 주장했다. Anthropic은 이 활동이 추론, 보상 모델, 콘텐츠 필터 관련 과제를 겨냥했다고 밝혔다. 이 주장은 Anthropic 자체의 탐지 보고서로 뒷받침되지만, 근거가 되는 계정 기록과 학습 기록은 공개되지 않았다. 따라서 판정된 사실이 아니라 Anthropic의 귀속 주장으로 기술해야 한다.37
Anthropic은 2026년 9월 10일 발표한 위협 인텔리전스 보고서에서 이 문제를 다시 다뤘다. 보고서는 2026년 2월 이후 무단 증류 캠페인을 탐지하고 차단했으며, 그 캠페인을 중화인민공화국에 있는 특정 연구소들의 소행으로 "높은 확신"을 갖고 귀속한다고 밝혔다. 이름이 거론된 곳은 DeepSeek를 포함해 Alibaba, Moonshot AI, Zhipu, Xiaomi, SenseTime, MiniMax다.
DeepSeek의 경우 Anthropic은 회사가 Anthropic 자체 대응책 가운데 하나를 우회하는 사고의 연쇄 추출 파이프라인을 만들었다고 주장했다. Anthropic의 인터페이스는 원시 추론을 돌려주지 않고 그 추론을 가리키는 참조를 돌려준다. 보고서에 따르면 DeepSeek는 그 참조를 저장한 뒤 새 세션을 열어 Claude에게 참조를 전체 추론 흔적으로 다시 펼치도록 요청했다. Anthropic은 2026년 7월의 14일 동안 DeepSeek에 귀속되는 교환이 1,210만 건을 넘는다고 추산했다.38
공개 기록으로는 특정 DeepSeek 모델에 경쟁사의 독점 출력이 얼마나 쓰였는지 판단할 수 없다. 모델 자신의 출력, 라이선스를 받은 모델, 합법적으로 얻은 데이터를 이용한 증류는 표준적인 기술 방법이다. 무단 접근이나 이용 약관 위반 여부는 데이터 출처와 법률 사실에 달려 있다.
9.2. 요청 경로 의혹
Anthropic의 2026년 9월 보고서는 증류와 구별되는 DeepSeek 관련 두 번째 주장을 제기한다. 다른 회사의 출력으로 학습하는 것과, 다른 회사의 모델을 자신의 유료 사용자에게 제공하는 것은 다른 혐의이며 보고서는 둘을 따로 다룬다. 추적 집단 GTG-16001 아래에서 Anthropic은 DeepSeek가 자체 모델 대신 Claude를 제공하고 모델 학습용으로 교환 내용을 수집한다고 주장했다. 이를 위해 DeepSeek가 들어오는 요청의 문자열을 검사해 Claude Code, Claude Agent SDK, OpenCode 같은 제3자 또는 Anthropic 코딩 하네스로 들어온 사용자를 식별하고, 그 사용자에 표시를 붙인 뒤 선택된 요청을 Claude Opus로 전달했다고 Anthropic은 말했다.
Anthropic은 이 고객들이 자신의 요청이 Anthropic에 전달되고 있다는 사실을 알지 못했을 가능성이 크다고 말했으며, 세 가지 예를 들었다. 중국의 한 기술 기업 직원이 내부 프로그램 문서를 분석한 요청이 전달됐다. 러시아 정부 기관과 일하는 정보기술 사업자의 요청도 전달됐는데, 보고서는 이 기관을 국방부와 연관된 곳으로 본다. 이 요청들을 통해 실시간 데이터베이스 자격 증명이 노출됐다. 중국 시 공안국을 위한 사건 관리 도구를 만드는 엔지니어의 요청도 있었다.38
이 주장은 Anthropic 자체의 탐지와 텔레메트리에 근거한다. 공개된 보고서는 요청 로그나 계정 식별자가 아니라 기법과 집계 수치를 제시하며, 활동을 DeepSeek 모델 버전이 아니라 2026년 7월의 14일 관찰 기간으로 특정한다. 2026년 9월 10일 보고서 공개를 다룬 CNBC는 DeepSeek, Alibaba, Moonshot, Xiaomi, Anthropic이 논평 요청에 즉시 응답하지 않았다고 보도했다. 2026년 2월의 주장과 마찬가지로 이것도 판정된 사실이 아니라 Anthropic의 귀속 주장이다.39
9.3. 하드웨어 의혹
2026년 3월 로이터는 이름을 밝히지 않은 미국 고위 관리가 DeepSeek가 미국의 수출 통제에도 불구하고 고급 Nvidia Blackwell 칩을 확보해 V4를 학습했다고 주장했다고 보도했다. 관리는 주장의 근거를 밝히지 않았고, DeepSeek와 Nvidia는 논평하지 않았다. 중국 외교부는 구체 사항을 알지 못한다고 밝히고, 기술과 무역의 정치화에 반대한다고 말했다. V4 논문은 학습에 쓰인 하드웨어를 밝히지 않는다. 학습 클러스터를 입증하는 공개된 기술 또는 문서 증거가 없으므로, 이 하드웨어 주장은 귀속된 혐의로 남는다.16,40
출처 40개
- AI Wiki: DeepSeek (2026-09-23 수정본) aiwiki.ai · CC BY 4.0 · 확인 2026-10-14
- Privacy Policy (AI Wiki 인용) cdn.deepseek.com · 확인 2026-10-14
- DeepSeek founder Liang Wenfeng built an AI company that shook the world (AI Wiki 인용) apnews.com · 확인 2026-10-14
- DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning doi.org · 확인 2026-10-14
- What is DeepSeek and why is it disrupting the AI sector? (AI Wiki 인용) investing.com · 확인 2026-10-14
- China's DeepSeek to raise fresh capital at $74 billion valuation ahead of onshore IPO, sources say finance.yahoo.com · 확인 2026-10-14
- Chinese filing implies DeepSeek valuation of around $52 billion investing.com · 확인 2026-10-14
- DeepSeek tells prospective investors of funding pause, Bloomberg News reports (AI Wiki 인용) investing.com · 확인 2026-10-14
- DeepSeek Resumes Funding Round to Raise $8 Billion pymnts.com · 확인 2026-10-14
- Chinese AI firm DeepSeek taps underwriters including Citic Securities for IPO: sources scmp.com · 확인 2026-10-14
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism arxiv.org · 확인 2026-10-14
- DeepSeek-Coder: When the Large Language Model Meets Programming arxiv.org · 확인 2026-10-14
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model arxiv.org · 확인 2026-10-14
- DeepSeek-V3 Technical Report arxiv.org · 확인 2026-10-14
- API updates (AI Wiki 인용) api-docs.deepseek.com · 확인 2026-10-14
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence arxiv.org · 확인 2026-10-14
- DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression huggingface.co · 확인 2026-10-14
- CAISI Evaluation of DeepSeek V4 Pro nist.gov · 확인 2026-10-14
- Models & Pricing (AI Wiki 인용) api-docs.deepseek.com · 확인 2026-10-14
- Global KV cache size per token across generations of DeepSeek models huggingface.co · 확인 2026-10-14
- DeepSeek V4.1 Flash (Reasoning, Max Effort) Intelligence, Performance & Price Analysis artificialanalysis.ai · 확인 2026-10-14
- DeepSeek V4 Pro 0813 (Reasoning, Max Effort) Intelligence, Performance & Price Analysis artificialanalysis.ai · 확인 2026-10-14
- DeepSeek-V4 Preview Release (AI Wiki 인용) api-docs.deepseek.com · 확인 2026-10-14
- Terms of Use (AI Wiki 인용) cdn.deepseek.com · 확인 2026-10-14
- DeepSeek-V3 repository and license github.com · 확인 2026-10-14
- DeepSeek-R1 repository and model license notes github.com · 확인 2026-10-14
- DeepSeek-V4-Pro model card huggingface.co · 확인 2026-10-14
- The Open Source AI Definition opensource.org · 확인 2026-10-14
- Chinese AI startup DeepSeek overtakes ChatGPT on Apple App Store (AI Wiki 인용) apnews.com · 확인 2026-10-14
- Chinese AI DeepSeek-R1 stuns scientists with its efficiency nature.com · 확인 2026-10-14
- Wiz Research uncovers exposed DeepSeek database leaking sensitive information, including chat history wiz.io · 확인 2026-10-14
- DeepSeek: the Italian SA orders limitation of processing (AI Wiki 인용) garanteprivacy.it · 확인 2026-10-14
- Results of preliminary inspection of DeepSeek service pipc.go.kr · 확인 2026-10-14
- Direction 001-2025: DeepSeek products, applications and web services (AI Wiki 인용) protectivesecurity.gov.au · 확인 2026-10-14
- OpenAI says Chinese rivals use its work for their AI apps apnews.com · 확인 2026-10-14
- DeepSeek says its success did not rely on OpenAI models nature.com · 확인 2026-10-14
- Detecting and preventing distillation attacks anthropic.com · 확인 2026-10-14
- Detecting and countering misuse of AI: September 2026 anthropic.com · 확인 2026-10-14
- Chinese AI labs secretly used millions of Claude exchanges to train their models, Anthropic says cnbc.com · 확인 2026-10-14
- China's DeepSeek trained AI model on Nvidia's best chip despite U.S. ban, official says (AI Wiki 인용) investing.com · 확인 2026-10-14
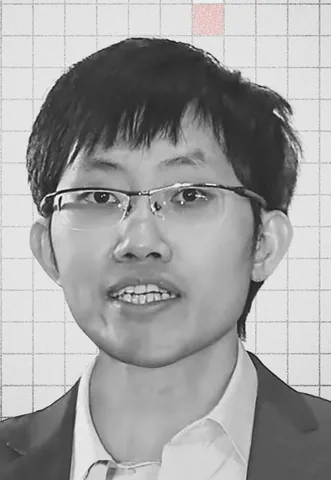 량원펑